
NoSQL 与搜索 / 系统课时
排查连接耗尽与请求堆积
排查连接耗尽与请求堆积
当应用出现获取连接超时、接口延迟陡升或大量请求排队时,真正的问题可能在客户端连接池、MongoDB 执行层,也可能是慢查询或下游超时引发的连锁反应。本课建立一条从“连接是否真的耗尽”到“请求为什么堆积”的可验证排查路径。
学习目标
- 区分连接数高、连接池等待和服务端执行阻塞三种不同现象。
- 使用
serverStatus与$currentOp判断连接、活跃操作和等待位置。 - 根据慢查询与下游超时证据选择限流、连接池或查询层面的修复措施。
先判断连接耗尽发生在哪一层
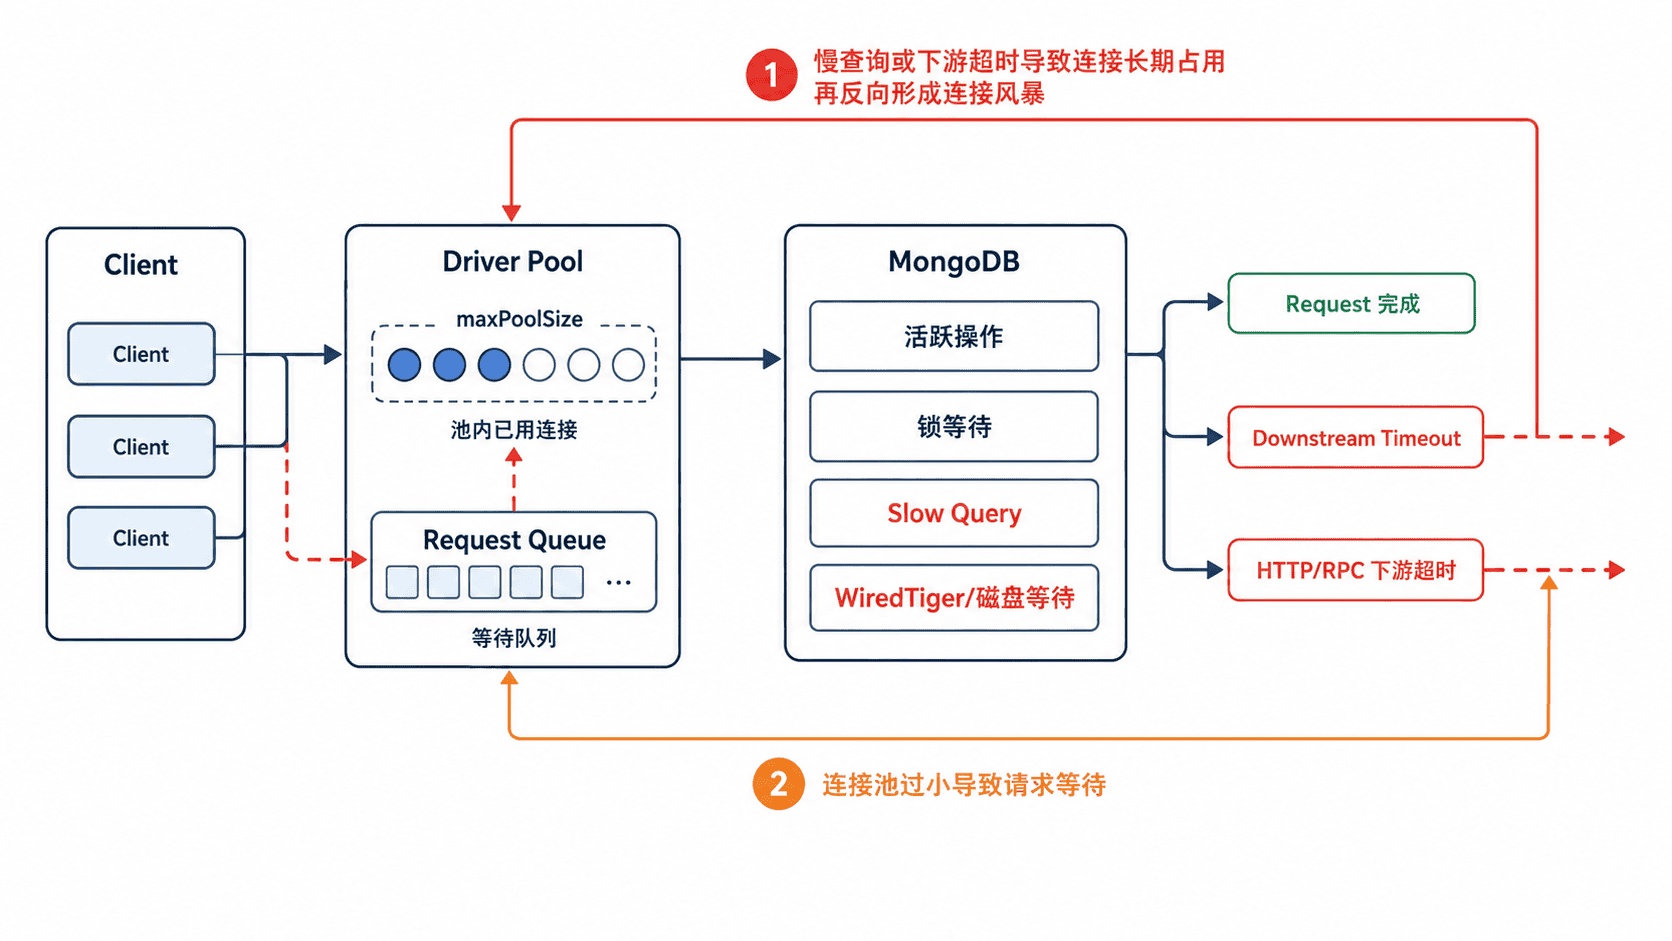
“连接耗尽”不能只看 MongoDB 的 current。应用侧连接池可能已经达到 maxPoolSize,新请求正在等待连接;也可能 MongoDB 仍有可用连接,但大量操作被慢查询、锁等待或磁盘延迟拖住,导致连接长期不能归还。
先在数据库侧确认连接总量、当前活跃连接和历史累计创建数。下面命令只读取状态,不修改配置;实际字段值会随负载变化。
mongosh "$MONGODB_URI" --quiet --eval '
const c = db.serverStatus().connections;
printjson({
  current: c.current,
  active: c.active,
  available: c.available,
  totalCreated: c.totalCreated
});
'
预期输出
{
  current: <VALUE>,
  active: <VALUE>,
  available: <VALUE>,
  totalCreated: <VALUE>
}
current 高但 active 低,通常表示大量连接处于空闲或等待,并不等于数据库繁忙;available 接近 0 才说明服务端连接容量逼近上限。若 totalCreated 在短时间快速增长,应继续检查应用是否频繁新建客户端或发生重连风暴。
找出谁占着连接不归还
连接池被占满时,关键不是“有多少连接”,而是“这些连接正在做什么”。使用 $currentOp 可以观察正在执行的操作、持续时间和锁等待情况,并优先查看运行时间较长的请求。
db.getSiblingDB("admin").aggregate([
  { $currentOp: { allUsers: true, idleConnections: false } },
  {
    $match: {
      active: true,
      secs_running: { $gte: 1 }
    }
  },
  {
    $project: {
      _id: 0,
      opid: 1,
      ns: 1,
      secs_running: 1,
      waitingForLock: 1,
      planSummary: 1,
      command: 1
    }
  },
  { $sort: { secs_running: -1 } },
  { $limit: 20 }
]).toArray()
预期输出
[
  {
    opid: <ID>,
    ns: "<DATABASE>.<COLLECTION>",
    secs_running: <VALUE>,
    waitingForLock: <VALUE>,
    planSummary: "<VALUE>",
    command: { ... }
  }
]
如果多数长操作拥有相似的查询条件或 planSummary,应把它们视为同一类 query shape 继续分析执行计划。若大量操作显示锁等待,则连接只是被阻塞现象占住,优先处理竞争事务或长写操作,而不是立即扩大连接池。
把应用等待队列和数据库阻塞分开
应用日志中的“获取连接超时”通常来自 Driver 连接池等待队列,它与 MongoDB 服务端的连接上限不是同一个指标。排查时应同时记录池大小、池内在用连接、连接等待时间、请求总耗时和 MongoDB 操作耗时。
判断顺序可以简化为:池已满但数据库 active 不高,先查应用是否把连接持有得过久;池已满且数据库存在大量长操作,先治慢查询或锁等待;连接建立频率异常高,则检查客户端生命周期、网络抖动和错误重试。
追踪慢查询和下游超时
一个请求可能先访问 MongoDB,再调用 HTTP、RPC 或其他数据库。即使 MongoDB 查询本身很快,只要应用在一次业务请求中长期持有会话、事务或其他有限资源,下游超时仍可能让连接池恢复变慢,并触发重试放大流量。
因此需要把同一请求的 request ID、连接池等待时间、MongoDB 操作耗时和下游耗时串在一起。若“池等待时间”随“下游超时”同步增长,而数据库长操作数量没有明显增加,根因更可能在应用调用链而不是 MongoDB。
按根因修复并验证
修复必须对应证据:查询慢就补索引或改 query shape;事务过长就缩短事务边界;连接反复创建就复用单例客户端并检查重连;突发流量超过处理能力就限流或背压;下游超时导致占用则设置合理超时并避免无界重试。
验证时重新观察同一组指标,目标不是把连接数降到最低,而是让连接池等待恢复、长操作数量下降、totalCreated 增速稳定,并确认业务 P95/P99 延迟和超时率同时回落。只有这些信号一起改善,才说明请求堆积的根因真正被消除。