
NoSQL 与搜索 / 系统课时
使用 Computed Pattern 降低聚合成本
使用 Computed Pattern 降低聚合成本
当页面反复请求“订单数、累计销售额、评分统计”这类聚合结果时,每次现场扫描明细会把查询成本推高。Computed Pattern 把昂贵计算前移到写入事件或后台批处理中,让读取直接拿预计算值,并显式管理写放大与数据时效性。
学习目标
- 识别适合预计算的聚合结果,并设计保存位置与更新粒度。
- 使用原子更新维护计数与累计值,验证读取不再执行全量聚合。
- 在实时事件更新与周期批处理之间权衡准确性、时效性和写入成本。
先确定要缓存的计算结果
假设商品详情页每次都展示累计销量与销售额。如果每次请求都从 orders 对所有历史订单执行 $group,成本会随数据量增长;Computed Pattern 可以把结果保存在商品文档的 stats 字段中。
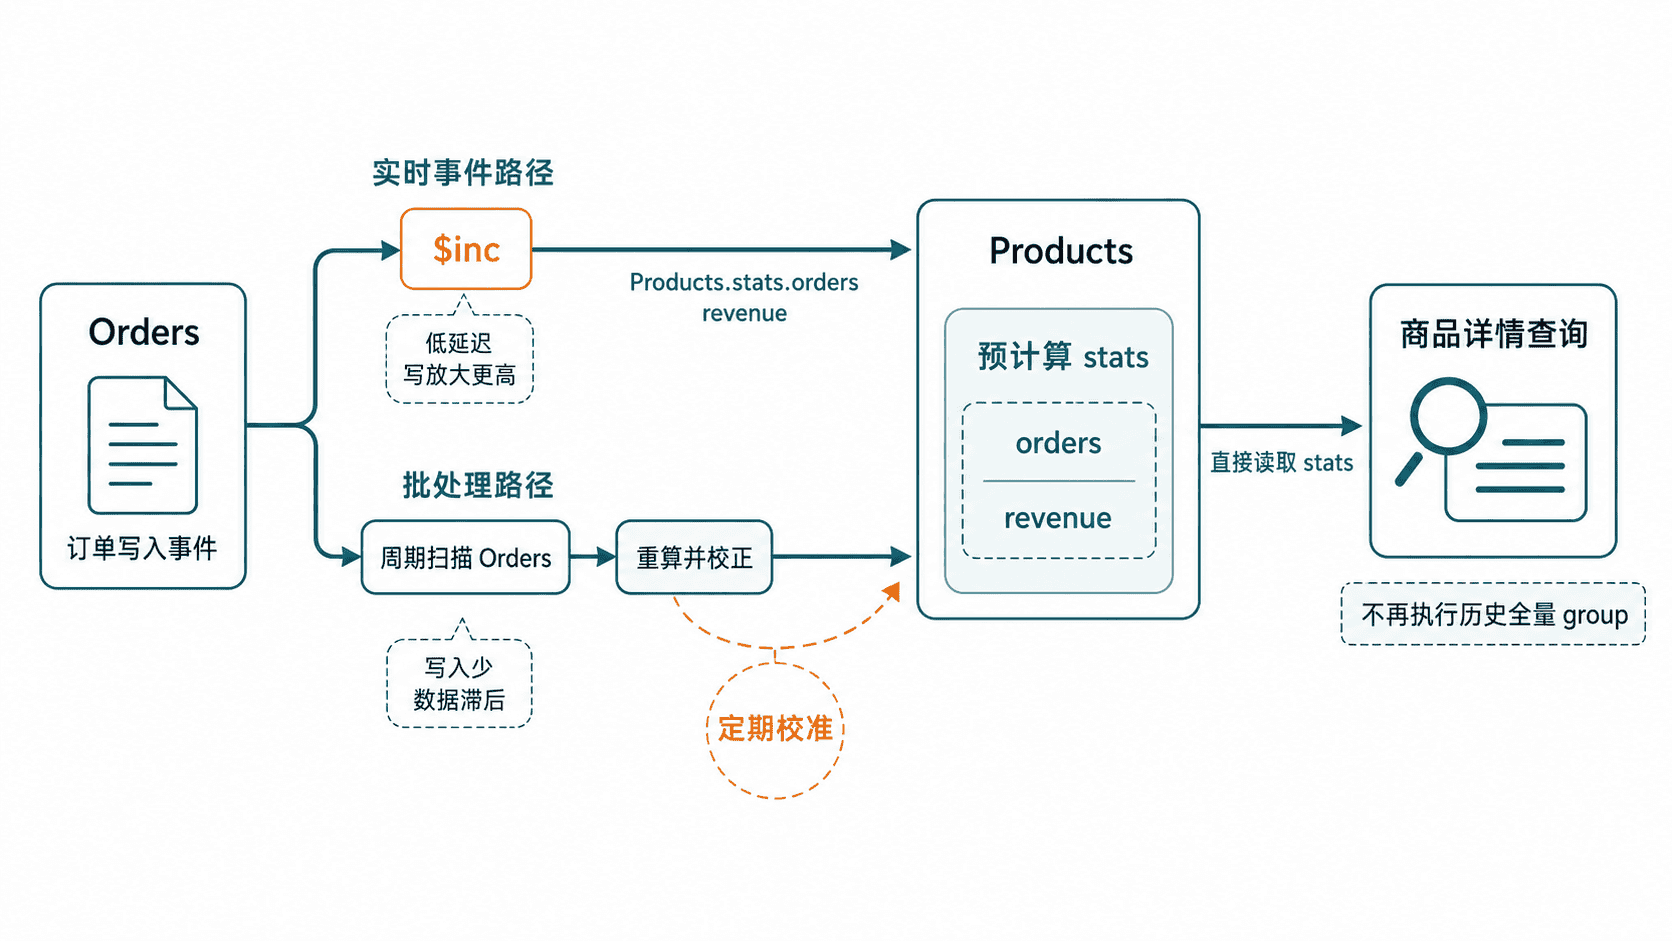
适合预计算的指标通常具有三个特征:读取远多于更新、计算公式稳定、允许明确的刷新策略。临时分析指标、频繁改变口径的报表,往往更适合按需聚合。
用事件增量维护统计值
下面假设商品文档已经存在。当一笔已确认订单包含商品 p1001、数量为 2、行金额为 1198 时,可以用 $inc 原子累加预计算字段。
db.products.updateOne(
  { _id: "p1001" },
  {
    $inc: {
      "stats.orderCount": 1,
      "stats.unitsSold": 2,
      "stats.revenue": 1198
    },
    $set: {
      "stats.updatedAt": new Date()
    }
  }
)

db.products.findOne(
  { _id: "p1001" },
  { _id: 0, stats: 1 }
)
预期输出
{
  stats: {
    orderCount: <VALUE>,
    unitsSold: <VALUE>,
    revenue: <VALUE>,
    updatedAt: ISODate("<TIME>")
  }
}
<VALUE> 与 <TIME> 取决于更新前的数据和执行时间。读取商品详情时只需读取 products.stats,无需再扫描订单集合。
防止重复事件把统计值加两次
事件驱动更新的关键风险不是 $inc 本身,而是消息可能重试。如果同一订单事件重复消费,计数和金额都会被重复累加。生产环境应让“业务事件是否已应用”与统计更新具备幂等边界,例如使用事件 ID 去重、事务记录消费结果,或由可重算的批处理定期校正。
对于允许秒级延迟的数据,可让订单成功后异步更新统计;对于必须立即返回准确累计值的关键交易流程,则应先确认是否真的适合把该指标作为预计算字段。
用批处理重算做校准
增量更新快,但长期运行后可能因历史补单、退款逻辑变化或异常重试产生偏差。可以周期性从权威明细重新聚合,再覆盖 stats 作为校准。下面的聚合展示重算思路,结果可由批处理程序写回商品集合。
db.orders.aggregate([
  { $unwind: "$items" },
  { $match: { status: "CONFIRMED" } },
  {
    $group: {
      _id: "$items.productId",
      orderCount: { $sum: 1 },
      unitsSold: { $sum: "$items.quantity" },
      revenue: {
        $sum: { $multiply: ["$items.unitPrice", "$items.quantity"] }
      }
    }
  },
  { $match: { _id: "p1001" } }
])
预期输出
[
  {
    _id: 'p1001',
    orderCount: <VALUE>,
    unitsSold: <VALUE>,
    revenue: <VALUE>
  }
]
实时增量适合低延迟展示,批处理重算适合纠偏与降低事件链复杂度。实践中常把两者组合:平时用增量更新提供快速读取,定期用权威明细重算校准,从而在查询延迟、写放大和最终准确性之间取得可控平衡。