
NoSQL 与搜索 / 系统课时
判断嵌入还是引用
判断嵌入还是引用
MongoDB 的关系建模不是把关系型数据库的外键原样搬过来,而是围绕实际访问模式决定数据放在哪里。本课用读取成本、更新方式、文档增长和一致性四个维度建立判断方法,并通过订单示例验证嵌入与引用带来的查询差异。
学习目标
- 根据数据的读取与更新模式判断何时优先嵌入、何时使用引用
- 理解嵌入对原子更新、数据重复和文档增长的影响
- 识别共享数据、独立生命周期和无界增长等不适合嵌入的信号
从访问模式而不是关系类型出发
看到“订单属于用户”“文章拥有评论”时,不要先问它是一对一还是一对多,而要先问:这些数据通常是否一起读取、是否一起修改、子数据是否会被多个父对象共享,以及数量是否可能持续增长。
如果子数据总是随父文档读取、数量有限,而且生命周期与父对象一致,嵌入通常能用一次文档读取得到完整结果。反过来,如果子对象需要被多个文档引用、单独高频更新或独立查询,引用会更自然。
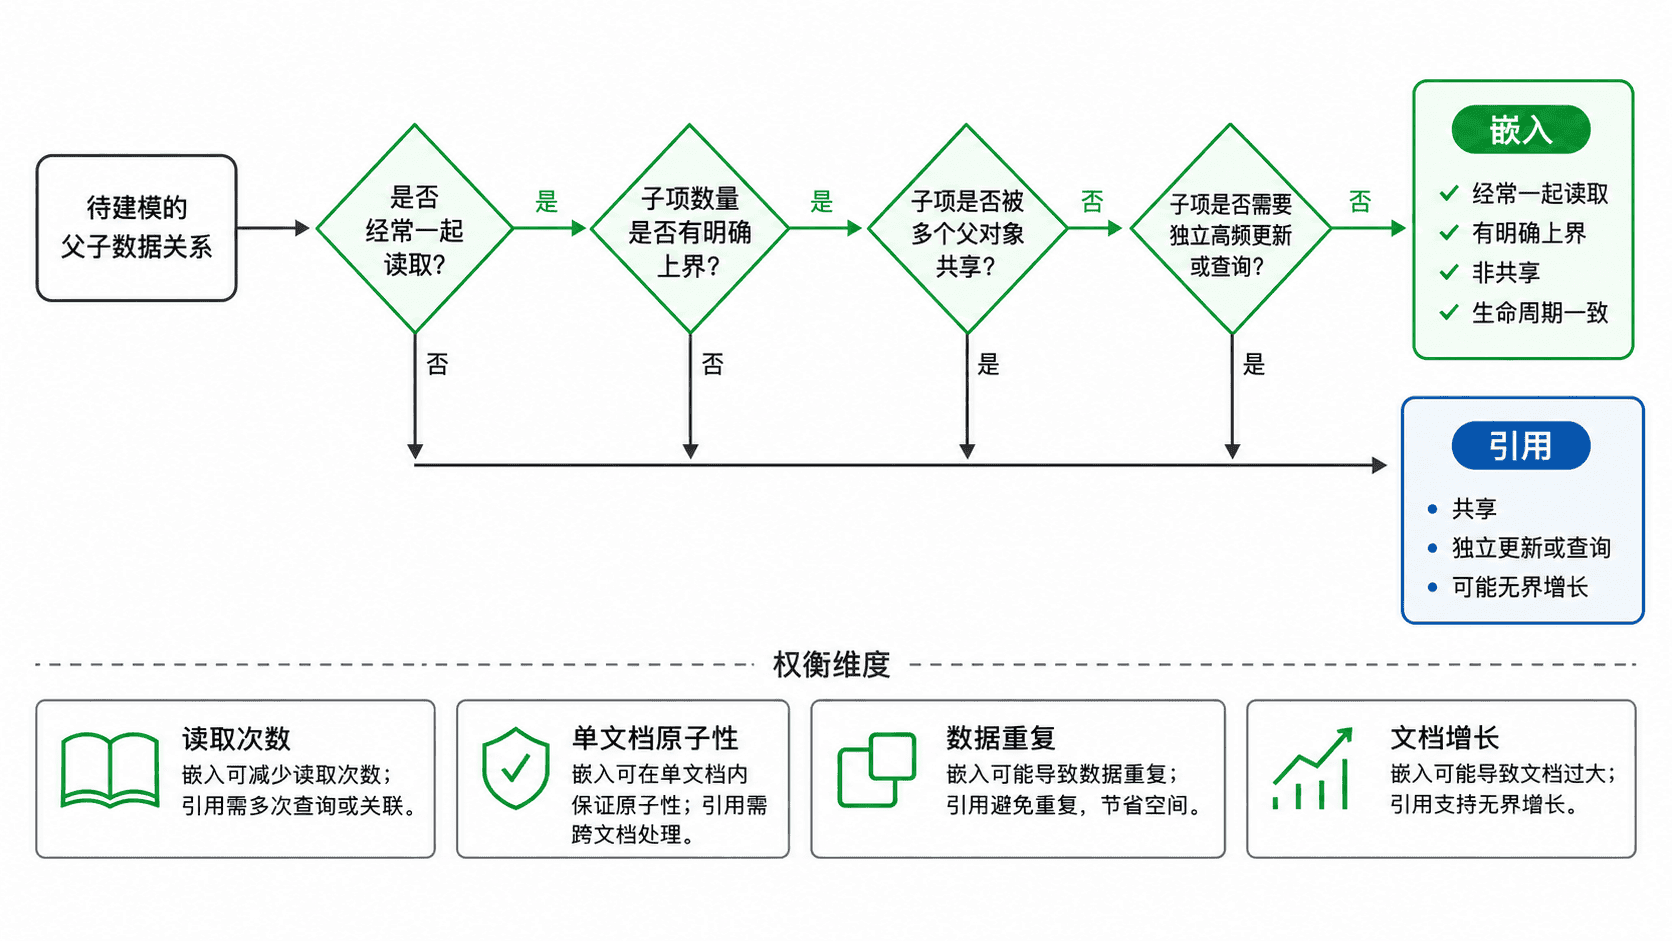
比较两种模型的核心代价
嵌入把相关数据保存在同一个 BSON 文档中。读取父对象时无需额外查询,同一文档内的修改也天然具有单文档原子性;代价是数据可能重复,而且数组或子文档增长会让父文档越来越大。
引用只保存关联对象的标识符,关联数据位于独立集合。它避免复制共享数据,并允许子对象独立增长和更新,但读取完整业务对象时通常需要额外查询或 $lookup。如果一个业务动作必须同时修改多个文档,还需要额外设计一致性策略,必要时才使用多文档事务。
可以用下面的判断表快速筛选:
| 信号 | 更偏向嵌入 | 更偏向引用 |
|---|---|---|
| 读取方式 | 父子数据几乎总是一起读取 | 子数据经常独立读取 |
| 更新方式 | 一起修改,希望单文档原子更新 | 子数据独立且高频修改 |
| 共享关系 | 子数据只属于一个父对象 | 同一子对象被多个父对象使用 |
| 数据规模 | 子项数量有稳定上界 | 子项可能持续增长 |
| 生命周期 | 创建、归档、删除通常同步 | 生命周期彼此独立 |
用订单快照验证嵌入的价值
订单中的收货地址通常适合保存为下单时的快照。即使用户之后修改个人地址,历史订单仍应保留成交时的信息,因此这里的“重复”反而是业务语义的一部分。
下面的命令可直接在 mongosh 中执行:
use modeling_demo

db.orders.drop()

db.orders.insertOne({
  _id: 1001,
  customerId: 42,
  shippingAddress: {
    city: "Shanghai",
    street: "Century Avenue 100"
  },
  total: 299
})

db.orders.findOne(
  { _id: 1001 },
  { _id: 0, customerId: 1, shippingAddress: 1, total: 1 }
)
预期输出
{
  customerId: 42,
  shippingAddress: { city: 'Shanghai', street: 'Century Avenue 100' },
  total: 299
}
一次读取就能得到订单与地址快照,也不依赖当前用户资料。如果改成只保存 addressId,读取历史订单时还需要访问地址集合,并且必须额外解决“地址后来被修改后,历史订单是否跟着变化”的语义问题。
警惕文档增长与共享数据
嵌入并不意味着“能放进去就放进去”。MongoDB 单个 BSON 文档存在 16 MiB 大小上限,因此评论、日志、消息等持续增长的集合不应无限追加到一个父文档数组中。即使距离大小上限还很远,大数组也会增加网络传输和更新成本。
商品名称、用户资料等共享数据也通常不适合复制到所有关联文档中,除非业务明确需要保存历史快照。共享对象一旦被大量重复嵌入,每次修改都可能演变成跨大量文档的数据同步问题。
做出可解释的选择
实际建模时可以先写出最频繁的两三个查询,再检查子数据是否有界、是否共享和是否独立更新。满足“一起读、有界、不共享、生命周期一致”时优先考虑嵌入;出现“共享、独立查询、高频独立更新、持续增长”中的任一强信号时,应认真考虑引用。真正好的模型不是嵌入最多或引用最规范,而是让核心访问路径以最低复杂度得到正确数据。