
NoSQL 与搜索 / 系统课时
综合排查慢查询与复制延迟
综合排查慢查询与复制延迟
慢查询与复制延迟经常同时出现,但两者未必互为因果。可靠的定位方式是从告警出发,把 query shape、执行计划、WiredTiger 缓存、磁盘延迟和 oplog 应用情况串成一条证据链,再通过改动后的同一组指标验证修复是否有效。
学习目标
- 从慢请求和复制延迟告警中确定需要优先验证的 query shape。
- 结合
explain、WiredTiger、磁盘与复制状态判断瓶颈位于哪一层。 - 用修复前后的执行计划、延迟和 oplog 指标完成根因闭环。
从告警建立同一时间窗口
先固定故障时间窗口,例如 <TIME_START> 到 <TIME_END>,再对齐应用 P95/P99、MongoDB 慢操作、CPU、磁盘延迟、WiredTiger 缓存和 secondary lag。若不同指标使用的时间窗口不一致,很容易把无关峰值错误地拼成“根因”。
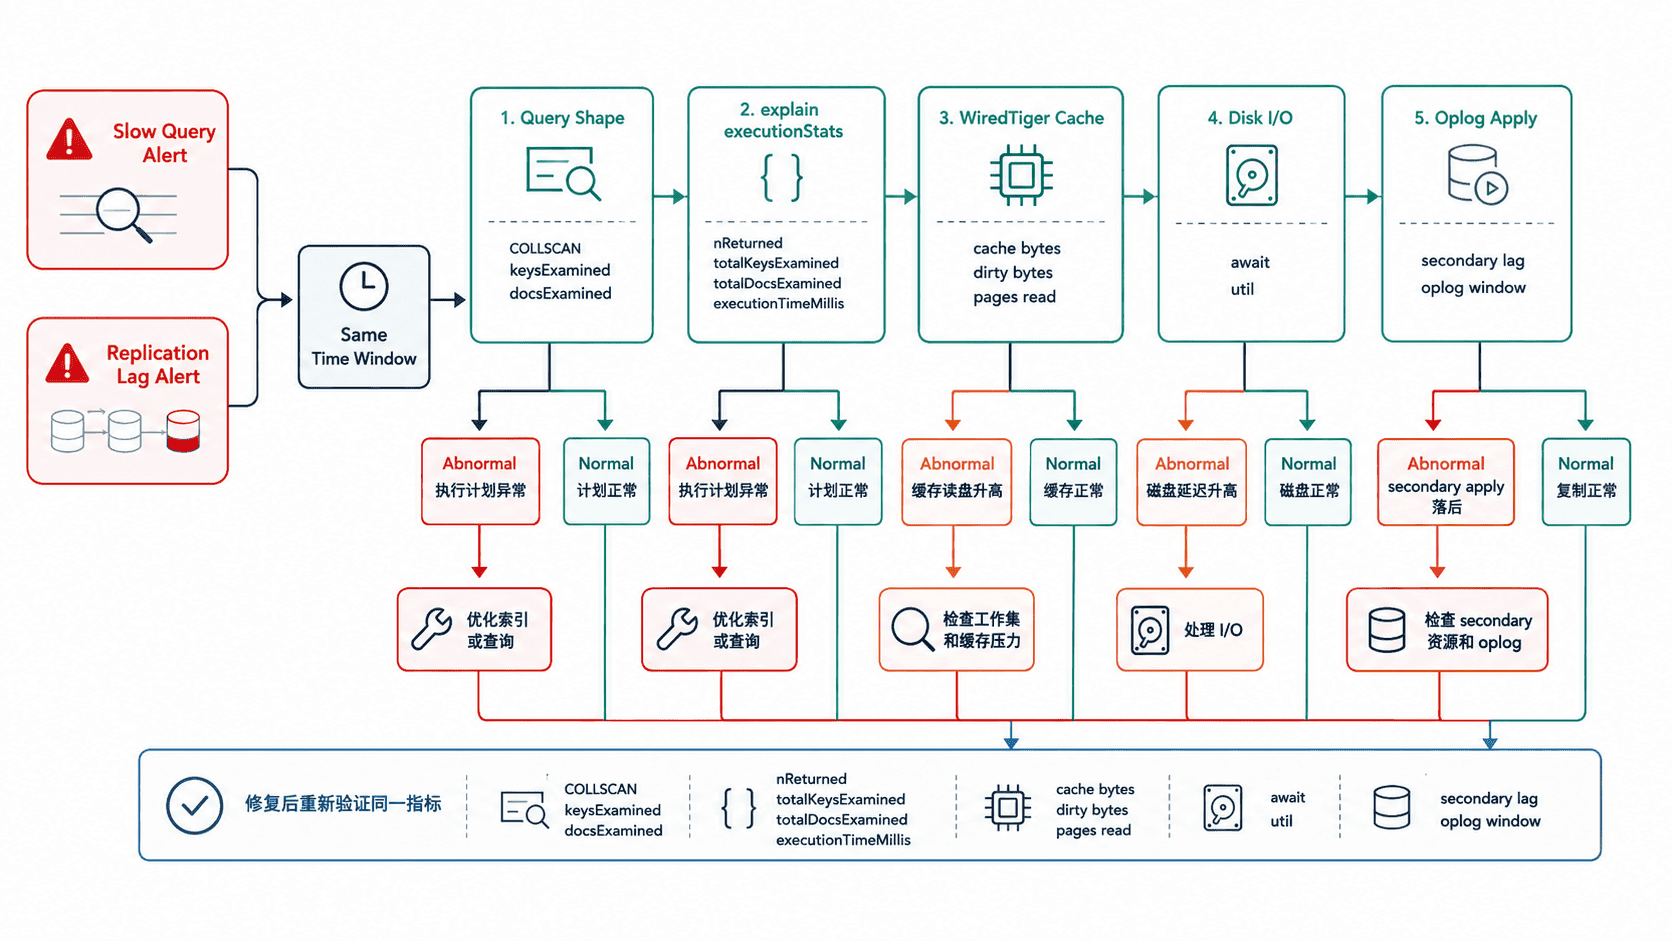
第一步不是立即 explain 任意一条慢 SQL,而是找到高频或高耗时的查询形状。若已启用数据库 profiler,可先读取现有记录;不要为了临时排障在高负载生产库盲目开启全量 profiling。
db.getSiblingDB("<DATABASE>").system.profile
  .find(
    { millis: { $gte: 100 } },
    { ns: 1, millis: 1, planSummary: 1, command: 1 }
  )
  .sort({ ts: -1 })
  .limit(10)
  .toArray()
预期输出
[
  {
    ns: "<DATABASE>.<COLLECTION>",
    millis: <VALUE>,
    planSummary: "<VALUE>",
    command: { ... }
  }
]
把筛选字段、排序字段和范围条件相似的记录归为同一 query shape,再选择最能代表问题的一条进入执行计划分析。
用执行计划确认查询是否浪费工作
假设业务慢查询是按租户和状态筛选订单,再按创建时间倒序取最近 50 条。下面示例使用 executionStats 验证实际扫描量;请把占位数据库、集合和样例值替换为生产中可安全复现的值。
db.getSiblingDB("<DATABASE>").orders
  .find({ tenantId: "<TENANT_ID>", status: "PENDING" })
  .sort({ createdAt: -1 })
  .limit(50)
  .explain("executionStats")
预期输出
{
  queryPlanner: {
    winningPlan: { ... }
  },
  executionStats: {
    nReturned: 50,
    totalKeysExamined: <VALUE>,
    totalDocsExamined: <VALUE>,
    executionTimeMillis: <VALUE>
  }
}
若 totalDocsExamined 远高于 nReturned,或 winning plan 出现 COLLSCAN,查询本身就是首要嫌疑。若扫描量合理而耗时仍高,则继续向缓存和磁盘层下钻,避免只凭“已有索引”就断定数据库没有问题。
检查 WiredTiger 是否把压力推向磁盘
WiredTiger 缓存压力常表现为缓存接近上限、脏数据增加、页面读入频繁,随后磁盘读延迟和查询耗时一起升高。下面命令抽取几个最常用的缓存字段进行现场对比。
mongosh "$MONGODB_URI" --quiet --eval '
const c = db.serverStatus().wiredTiger.cache;
printjson({
  bytesInCache: c["bytes currently in the cache"],
  maxBytes: c["maximum bytes configured"],
  dirtyBytes: c["tracked dirty bytes in the cache"],
  pagesRead: c["pages read into cache"],
  pagesWritten: c["pages written from cache"]
});
'
预期输出
{
  bytesInCache: <VALUE>,
  maxBytes: <VALUE>,
  dirtyBytes: <VALUE>,
  pagesRead: <VALUE>,
  pagesWritten: <VALUE>
}
这些累计计数应结合一段时间内的增速看,而不是只读一个瞬时值。如果 pagesRead 增速在慢查询峰值期间明显放大,说明工作集频繁从磁盘重新读入;此时需要继续验证磁盘延迟,以及是否存在缺失索引、大范围扫描或工作集超过可用内存。
把磁盘瓶颈与复制应用分开
在 Linux 主机上可用 iostat 查看设备层面的服务时间和队列。它反映的是操作系统视角,不应与 MongoDB 的单次查询耗时直接等同,但能验证数据库等待是否伴随 I/O 饱和。
iostat -x 1 5预期输出
Device            r/s     w/s   await  aqu-sz  %util
<DEVICE>        <VALUE> <VALUE> <VALUE> <VALUE> <VALUE>
...
若 primary 的磁盘延迟升高,同时写入量很大,secondary 复制延迟可能只是上游写压力的结果。若 primary 正常而某个 secondary 的磁盘、CPU 或缓存明显更差,则应把复制延迟定位到该 secondary 的资源或 oplog 应用能力。
检查复制延迟和 oplog 余量
在副本集环境中,先查看各成员的复制时间,再确认 oplog 时间窗口是否足够覆盖当前延迟。下面两个命令只读取复制状态。
rs.printSecondaryReplicationInfo()
rs.printReplicationInfo()
预期输出
source: <HOST>
{
  syncedTo: "<TIME>",
  replLag: "<VALUE> secs (<VALUE> hrs) behind the primary"
}
configured oplog size: <VALUE>MB
log length start to end: <VALUE>secs (<VALUE>hrs)
oplog first event time: <TIME>
oplog last event time: <TIME>
now: <TIME>
输出格式会随 mongosh 和 MongoDB 版本略有差异,但应重点关注 secondary 落后时长与 oplog 可覆盖窗口。如果延迟持续接近 oplog 窗口,成员可能面临无法继续增量追赶、最终需要重新同步的风险。
用同一证据链验证修复
修复要针对最早出现异常的层级。query shape 扫描过大就调整索引或查询;缓存抖动来自大范围扫描就先减少无效读取;磁盘长期高延迟则处理 IOPS、吞吐或同机竞争;只有 secondary 落后时,再集中检查该节点的资源、网络和复制应用能力。
修复后必须重复同一时间窗口和同一组检查:nReturned 与扫描量比例改善、查询 P95/P99 回落、WiredTiger 页面读入增速下降、磁盘 await 恢复,并且 secondary lag 持续收敛。这样才能证明“慢查询”和“复制延迟”是被同一根因修复,还是两个恰好同时发生的问题。