
NoSQL 与搜索 / 系统课时
配置连接串与 Read Preference
配置连接串与 Read Preference
本课把复制集 URI、驱动的 Server Selection 与 Read Preference 串成一条完整链路。你会知道 seed list 为什么不是“固定节点列表”,怎样选择 Primary 或 Secondary,以及如何用标签集表达地域和工作负载偏好。
学习目标
- 写出包含多个 seed host 与
replicaSet的复制集连接串 - 理解五种 Read Preference 对候选成员集合的影响
- 用标签集和最大陈旧度约束 Secondary 读取,并验证实际命中的成员
URI 首先描述复制集拓扑
一个典型的自建复制集 URI 应包含多个可达的 seed host,并显式声明复制集名称。驱动连接任一 seed 后,会通过拓扑发现获得当前 Primary、Secondary 与后续成员变化,因此 seed list 是发现入口,不是静态路由表。
mongodb://app:<PASSWORD>@mongodb0.example.net:27017,mongodb1.example.net:27017,mongodb2.example.net:27017/orders?authSource=admin&replicaSet=rs0其中 replicaSet=rs0 必须与服务端配置一致。把多个成员写进 URI 能降低“第一个地址恰好不可达”造成的启动失败风险;真正执行某次操作时,驱动仍会依据操作类型和 Server Selection 规则选择节点。
Read Preference 决定候选成员
Read Preference 只影响读操作的路由意图,默认模式是 primary。五种模式的差异可以先按“优先谁、失败后能否退到另一角色”理解。
| 模式 | 主要读取目标 | 典型用途 |
|---|---|---|
primary |
只读 Primary | 默认选择,需要最新主节点视角的普通业务读取 |
primaryPreferred |
优先 Primary,无 Primary 时可读 Secondary | 希望以 Primary 为主,但短暂切主期间允许降级读取 |
secondary |
只读 Secondary | 报表、离线查询等明确与主节点隔离的读取 |
secondaryPreferred |
优先 Secondary,无可用 Secondary 时回退 Primary | 希望分担读取压力,但不想因 Secondary 全部不可用而直接失败 |
nearest |
在符合条件的 Primary 或 Secondary 中按延迟窗口选择 | 跨地域且业务允许读取非 Primary 的场景 |
Secondary 通过异步复制追赶 Primary,因此非 primary 模式可能读到较旧数据。Read Preference 解决“去哪里读”,不负责替你定义一致性要求;是否允许陈旧、需要哪种 read concern,应由业务语义另外决定。
Server Selection 逐层缩小候选集
驱动通常会为每次操作重新选择合适服务器。对需要从 Secondary 选成员的路径,可以把过程理解为四层筛选:先确认复制集成员和角色,再套用 Read Preference 模式,然后按最大陈旧度与标签集过滤,最后从可接受的延迟窗口中选择服务器。primary 只选择 Primary,不使用标签集过滤。
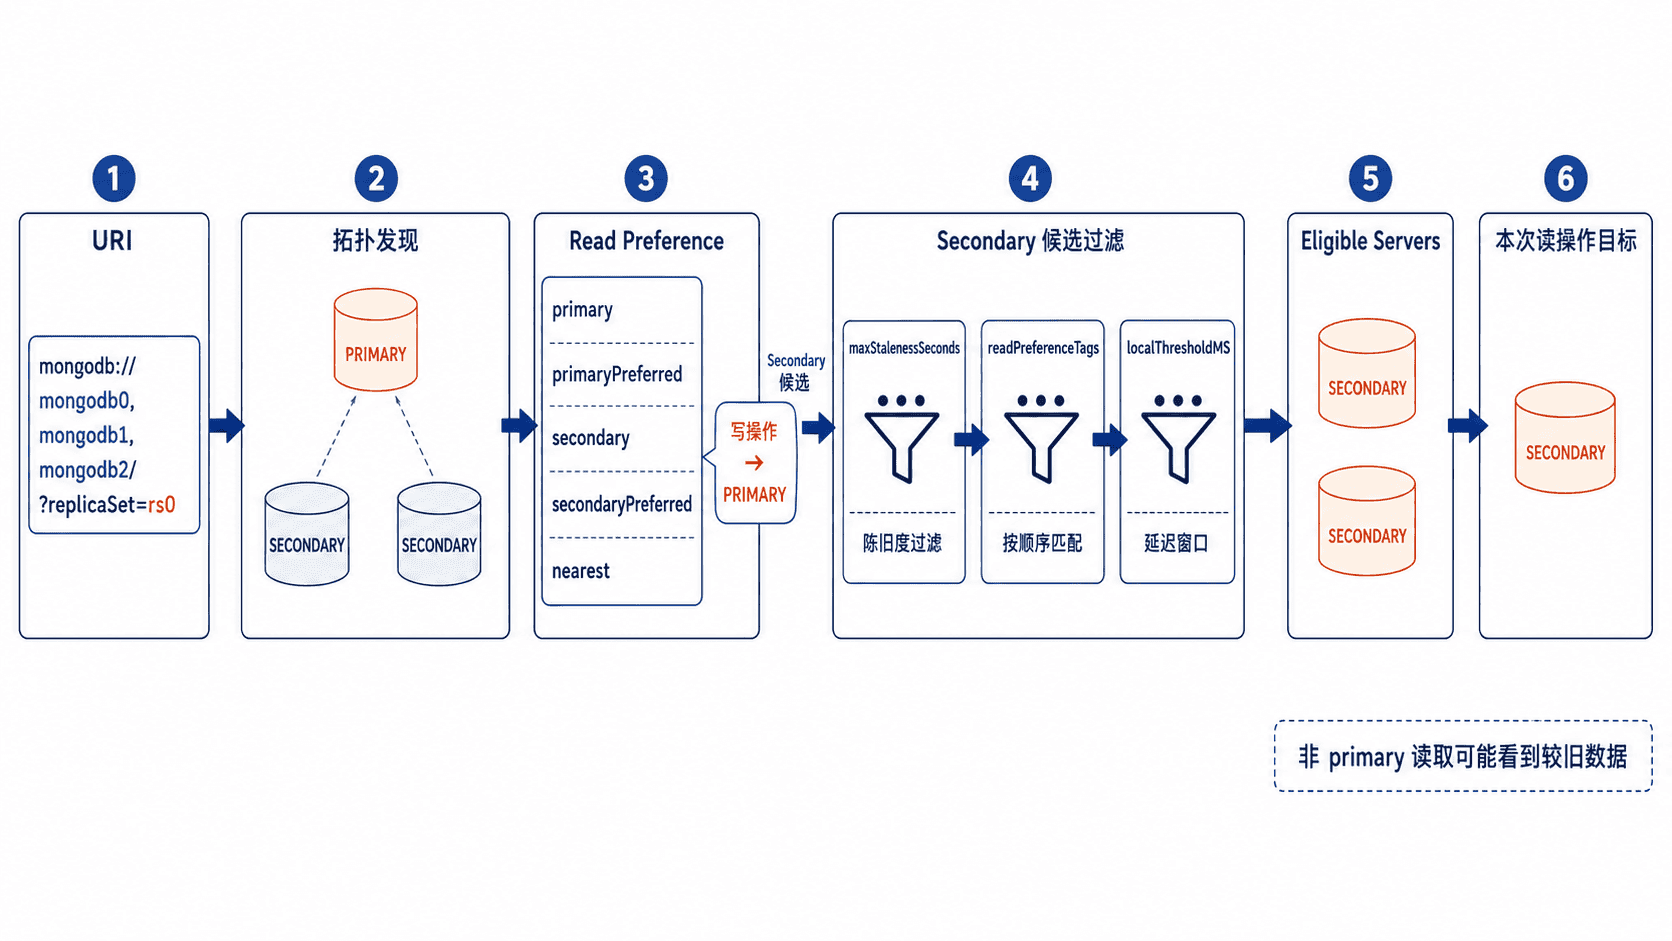
这也解释了为什么 nearest 不是“永远选 RTT 最小的唯一节点”,以及为什么指定 secondary 后不会因为 Primary 更快就把读请求送到 Primary。角色约束、标签和陈旧度先决定谁有资格,延迟窗口只在合格成员中继续选择。
用标签集表达地域和负载意图
标签属于复制集成员配置。例如,可以把两个 Secondary 标记为不同地域,并给它们共同的报表工作负载标签。以下片段在当前 Primary 的 mongosh 中执行。
const cfg = rs.conf()
cfg.members[1].tags = { region: "us-west", workload: "reporting" }
cfg.members[2].tags = { region: "us-east", workload: "reporting" }
rs.reconfig(cfg)
预期输出:
{ ok: 1 }然后可在 URI 中把读取偏好写成“优先读取 us-west 的 reporting Secondary;若没有匹配标签的 Secondary,则回退到任意可用 Secondary”。多个 readPreferenceTags 按顺序尝试,最后的空标签集就是显式兜底。
mongodb://app:<PASSWORD>@mongodb0.example.net:27017,mongodb1.example.net:27017,mongodb2.example.net:27017/orders?authSource=admin&replicaSet=rs0&readPreference=secondaryPreferred&maxStalenessSeconds=120&readPreferenceTags=region:us-west,workload:reporting&readPreferenceTags=该配置的生效行为是:先排除不符合 secondaryPreferred 和最大陈旧度要求的成员,再优先匹配 region:us-west,workload:reporting;没有匹配时,空标签集允许使用其他符合条件的 Secondary,若 Secondary 整体不可用,secondaryPreferred 才会回退 Primary。
要验证驱动实际把 find 发到了哪台机器,可以开启 Node.js Driver 的命令监控。以下示例假设项目已安装 mongodb 包,并把上面的 URI 放入环境变量 MONGODB_URI。
import { MongoClient } from "mongodb";

const uri = process.env.MONGODB_URI;
if (!uri) throw new Error("MONGODB_URI is required");

const client = new MongoClient(uri, { monitorCommands: true });

client.on("commandStarted", (event) => {
  if (event.commandName === "find") {
    console.log(`find -> ${event.address}`);
  }
});

try {
  await client.connect();
  await client.db("orders").collection("read_probe").findOne({});
} finally {
  await client.close();
}
预期输出类似:
find -> <SELECTED_HOST>:27017若 us-west Secondary 健康且符合陈旧度要求,<SELECTED_HOST> 应落在符合该标签的成员;停止该成员后再次执行,驱动会按后续标签集和 secondaryPreferred 的规则重新筛选,而不是继续绑定已失效的地址。
选择策略的边界
把业务主查询无差别改成 secondary 并不是通用的“读写分离优化”。如果请求刚完成写入就必须读到最新状态,Primary 读取通常更直接;如果是可容忍轻微陈旧的报表、搜索辅助或跨地域只读流量,Secondary 与标签集才更有价值。包含读取的事务应使用 primary。
标签也不应替代容量规划。一个被打上 reporting 的 Secondary 如果同时承担备份、索引构建或其他重负载,仍可能成为瓶颈。最终应同时观察复制延迟、节点负载和实际 Server Selection 结果,用 Read Preference 表达业务意图,而不是用它掩盖拓扑或资源问题。