
NoSQL 与搜索 / 系统课时
使用 serverStatus 与 currentOp 排障
使用 serverStatus 与 currentOp 排障
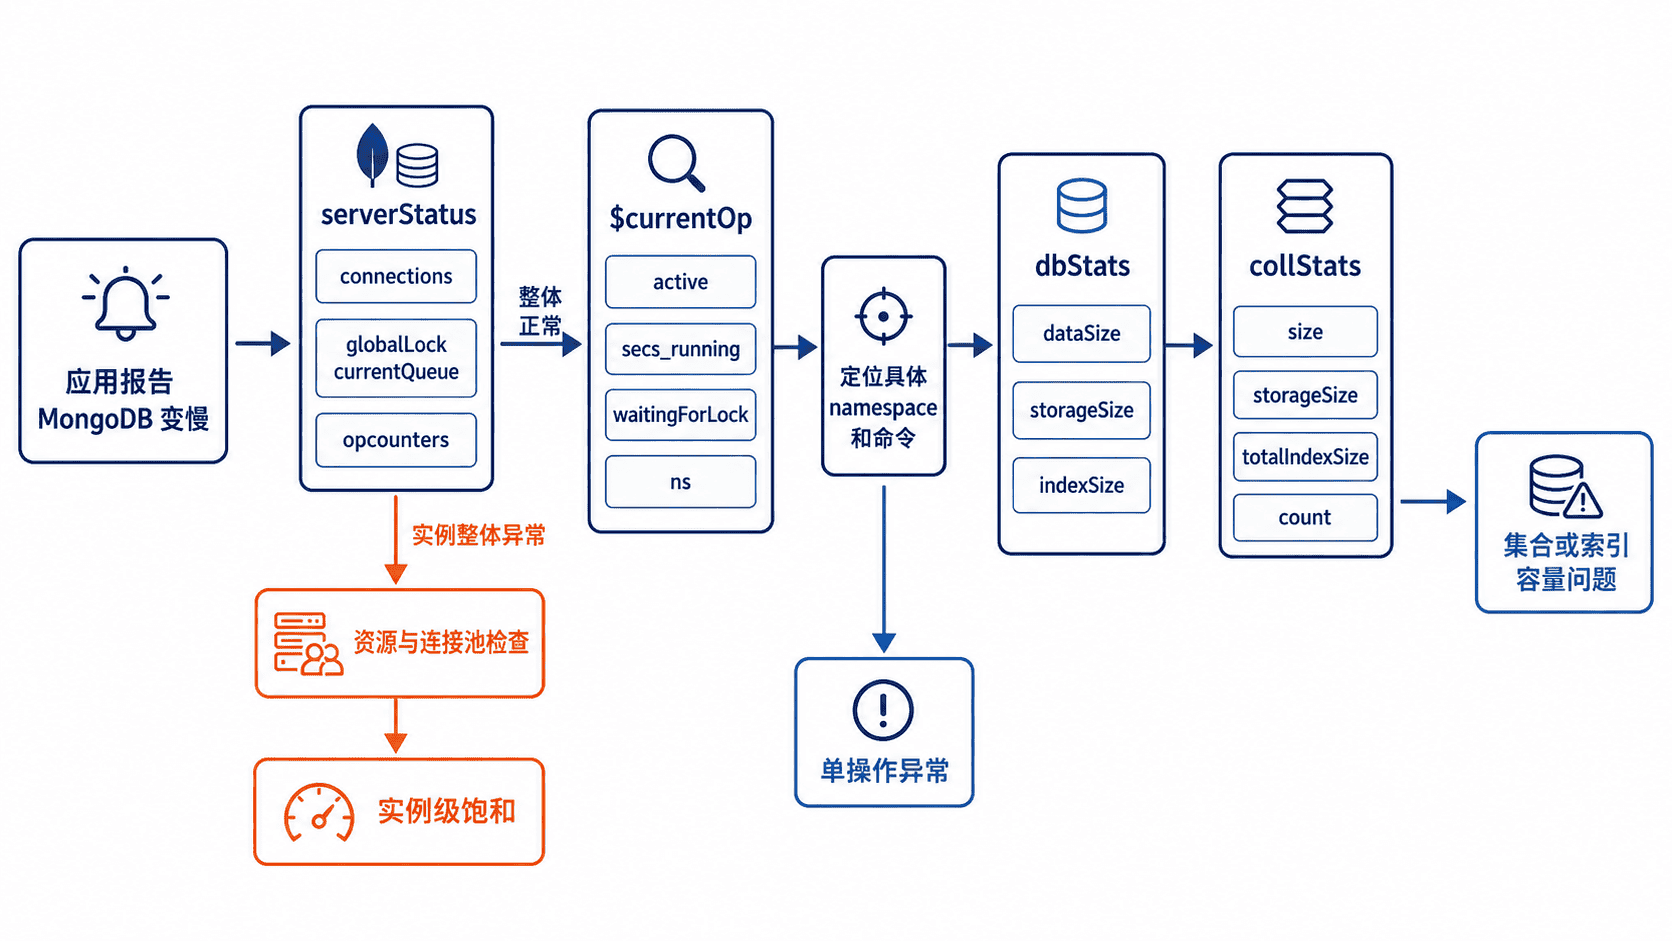
面对“MongoDB 变慢”时,先判断实例是否整体饱和,再定位正在运行的异常操作,最后下钻到数据库与集合状态,能避免一上来就盯某条查询。本课使用 serverStatus、$currentOp、dbStats 与 collStats 建立一条可重复的生产排障路径。
学习目标
- 用
serverStatus判断连接、队列和整体活动是否异常 - 用
$currentOp找出长时间运行或等待中的操作 - 用
dbStats与collStats验证存储、索引和集合级状态
先判断是不是实例级压力
先在 admin 数据库查看连接数、全局锁队列和基本操作计数。单个值很少能直接说明问题,重点是它们是否与延迟上升出现在同一时间窗口。
const admin = db.getSiblingDB("admin");
const s = admin.serverStatus();

printjson({
  connections: s.connections,
  currentQueue: s.globalLock?.currentQueue,
  opcounters: s.opcounters
});
预期输出类似下面的结构,具体字段和值取决于版本与负载:
{
  "connections" : { "current" : <VALUE>, "available" : <VALUE>, ... },
  "currentQueue" : { "total" : <VALUE>, "readers" : <VALUE>, "writers" : <VALUE> },
  "opcounters" : { "insert" : <VALUE>, "query" : <VALUE>, "update" : <VALUE>, ... }
}
实际值可能不同。若连接数快速逼近可用上限,应先排查连接池和连接泄漏;若队列持续非零并伴随延迟升高,说明请求已经开始等待资源;若实例级指标正常,则继续寻找少数异常操作。
用 currentOp 找到正在拖慢系统的操作
现代排障更适合使用聚合阶段 $currentOp,因为它可以继续接 $match 和 $project。下面筛选运行至少 2 秒的活动操作,只保留定位所需字段。
const admin = db.getSiblingDB("admin");

admin.aggregate([
  {
    $currentOp: {
      allUsers: true,
      idleConnections: false
    }
  },
  {
    $match: {
      active: true,
      secs_running: { $gte: 2 }
    }
  },
  {
    $project: {
      opid: 1,
      secs_running: 1,
      op: 1,
      ns: 1,
      waitingForLock: 1,
      client: 1,
      command: 1
    }
  }
]).forEach(printjson);
预期结果是零条或多条当前操作;若有慢操作,会看到操作 ID、运行秒数、命名空间和命令摘要:
{
  "opid" : <ID>,
  "secs_running" : <VALUE>,
  "op" : "<VALUE>",
  "ns" : "<DATABASE>.<COLLECTION>",
  "waitingForLock" : <VALUE>,
  "client" : "<IP>:<PORT>",
  "command" : { ... }
}
实际 ID、客户端地址和命令内容会不同。allUsers: true 需要相应监控权限;权限不足时只能看到允许查看的操作。生产环境不要因为“运行时间长”就立即终止操作,先确认它是不是合法的备份、索引构建、批处理或迁移任务。
再用 dbStats 判断数据库级容量
如果慢操作集中在某个数据库,先看整体体量和索引占用,确认问题是否与容量增长同步。
db.runCommand({
  dbStats: 1,
  scale: 1024 * 1024
});
预期结果中常用字段如下,容量值以 MiB 为单位:
{
  "collections" : <VALUE>,
  "objects" : <VALUE>,
  "dataSize" : <VALUE>,
  "storageSize" : <VALUE>,
  "indexSize" : <VALUE>,
  "ok" : 1
}
若 indexSize 相比数据体量异常增长,应继续检查索引数量和索引设计;若 storageSize 快速增长,则继续下钻到具体集合,而不是把数据库整体体量当成唯一结论。
用 collStats 下钻到目标集合
已经从 $currentOp 得到目标命名空间后,再对具体集合执行 collStats。以下示例检查 orders 集合;实际排障时替换为目标集合名。
db.runCommand({
  collStats: "orders",
  scale: 1024 * 1024
});
预期结果会包含集合文档数、逻辑大小、存储大小和索引大小等信息:
{
  "ns" : "<DATABASE>.orders",
  "count" : <VALUE>,
  "size" : <VALUE>,
  "storageSize" : <VALUE>,
  "totalIndexSize" : <VALUE>,
  "ok" : 1
}这四类工具各自回答不同问题:serverStatus 看“实例整体是否吃紧”,$currentOp 看“现在是谁在占用时间或等待”,dbStats 看“数据库总体有多大”,collStats 看“具体集合的存储与索引状态”。沿着这个顺序逐层缩小范围,通常比直接猜测慢查询根因更快,也更容易保留可复现的证据链。