
NoSQL 与搜索 / 系统课时
理解 Sharded Cluster 架构
理解 Sharded Cluster 架构
Sharded Cluster 把一份逻辑数据库拆到多个分片上,但客户端仍只面对一个查询入口。本课把 mongos、Config Server、Shard Replica Set 与 Balancer 串成一条完整链路,读完后你能解释一次查询为何只打到部分分片,或为什么会退化成广播。
学习目标
- 说清
mongos、Config Server 与各 Shard Replica Set 的职责边界 - 跟踪一次查询从路由、分片执行到结果合并的完整过程
- 用
mongosh验证当前连接是否经过mongos,并查看集群中的分片
核心组件如何分工
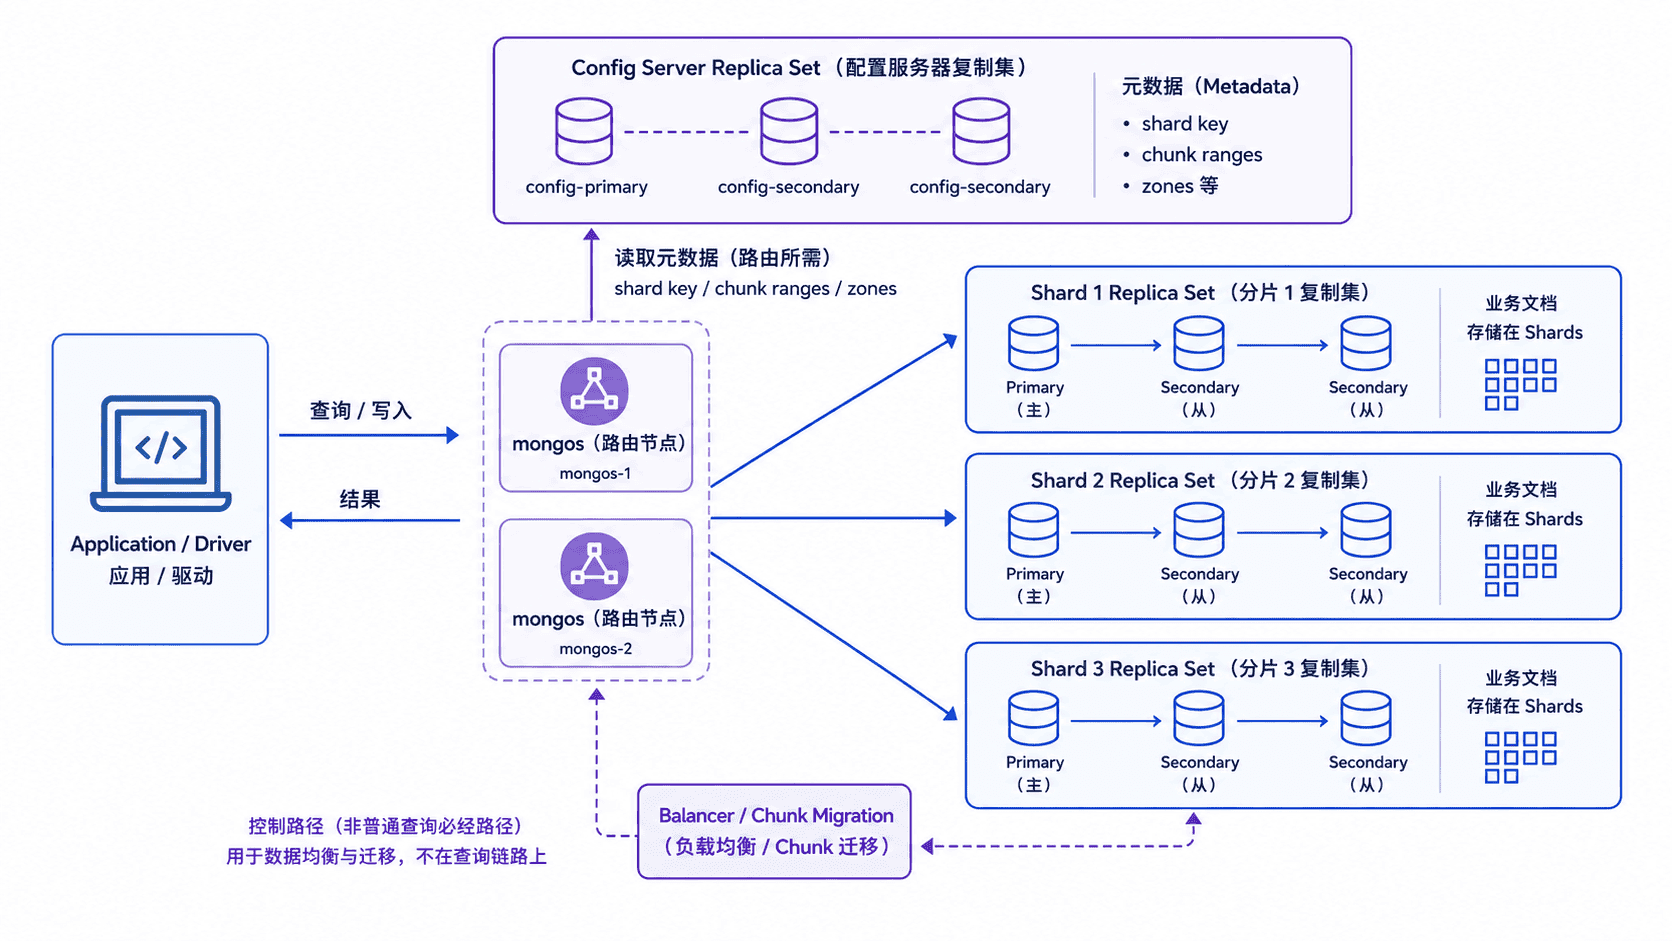
客户端通常连接一个或多个 mongos。它是无状态查询路由器,不保存业务数据;它根据缓存的分片元数据决定请求该去哪些 shard,并在需要时合并各分片返回的局部结果。
Config Server Replica Set 保存分片集群的控制面元数据,例如数据库的 primary shard、集合的 shard key、chunk 范围、zone 与迁移状态。它不承担普通业务文档存储,但路由刷新、DDL 和 chunk 迁移都依赖这些元数据。
每个 shard 在生产环境中通常是一个 Replica Set。真正的业务文档落在这些复制集上,由各自 primary 接收写入,再复制到 secondary。分片解决横向容量,复制集解决单个分片内部的高可用,两者承担的是不同问题。
一次查询如何穿过集群
收到查询后,mongos 先根据 namespace 与过滤条件读取或刷新路由信息。如果条件能利用 shard key 定位到一个或少量 chunk,它只向相关 shard 发请求,这叫 targeted query;如果缺少可用于定位的 shard key 条件,就可能向所有相关 shard 发请求,也就是 scatter-gather。
各 shard 在本地执行匹配、索引扫描和部分聚合,再把结果返回给 mongos。mongos 根据操作需要完成最终合并,例如归并排序、全局 limit 或聚合流水线的 merge 阶段,然后把单一响应返回客户端。因此,有没有好的 shard key 条件,直接决定一次请求的扇出范围。
数据、元数据与迁移分别发生在哪里
需要区分三个容易混淆的“primary”。Replica Set primary 是某个 shard 内当前接收写入的节点;database primary shard 则是某个数据库默认承载未分片集合的 shard。二者名称相近,但一个属于复制协议,一个属于分片元数据。
Balancer 根据 chunk 分布和 zone 约束安排迁移,把 chunk 从一个 shard 搬到另一个 shard,以减少长期不均衡。迁移改变的是数据所在位置和元数据映射,不会改变应用看到的集合名称。正常查询仍然先到 mongos,而不是先经过 Balancer。
用命令观察真实拓扑
下面命令需要在 mongosh 中连接到 mongos 后执行。第一条检查当前服务是否为分片路由器,第二条只提取分片名称和连接串,避免被大量动态元数据干扰。
const hello = db.adminCommand({ hello: 1 });
print(hello.msg);

// listShards 必须对 mongos 执行;只保留最关键的拓扑字段。
const shards = db.adminCommand({ listShards: 1 }).shards
  .map(({ _id, host }) => ({ _id, host }));
printjson(shards);
预期输出(主机名、端口和分片数量以实际环境为准):
isdbgrid
[
  { _id: 'shard01', host: 'shard01/<HOST>:<PORT>,<HOST>:<PORT>,<HOST>:<PORT>' },
  { _id: 'shard02', host: 'shard02/<HOST>:<PORT>,<HOST>:<PORT>,<HOST>:<PORT>' }
]
如果第一行不是 isdbgrid,通常说明你连到的是某个 mongod,而不是 mongos;这时很多分片管理命令不会按预期工作。实际值中的 <HOST>、<PORT> 会随部署环境变化。
架构边界与故障影响
单个 mongos 故障只会影响经过它的连接,因此客户端应配置多个可用路由入口。某个 shard 发生 Replica Set 选主时,主要影响该 shard 上的数据访问;其他 shard 不会因此全部停止,但跨多个 shard 的请求可能被最慢或不可用的分片拖住。
Config Server Replica Set 则是集群控制面的关键依赖。失去多数派后,依赖元数据写入的 DDL、chunk 迁移等操作会受阻;已有路由缓存可能让部分数据操作继续,但这不是可接受的长期运行状态。理解这三层职责后,排查问题时应先判断故障发生在路由层、元数据层还是具体 shard,而不是把整个 Sharded Cluster 当成一个黑盒。