
NoSQL 与搜索 / 系统课时
判断何时需要 Sharding
判断何时需要 Sharding
Sharding 解决的是单个副本集无法继续承载数据容量或吞吐的问题,而不是所有慢查询的通用药方。本课从数据量、工作集、CPU、I/O 和吞吐趋势判断是否逼近单机上限,并先排除索引、模型和容量配置问题,避免过早引入分片复杂度。
学习目标
- 区分“查询需要优化”和“容量必须横向扩展”两类问题
- 用工作集、CPU、I/O、存储与吞吐趋势判断单机资源是否持续触顶
- 在决定分片前验证垂直扩容空间、查询路由特征和可行的 shard key
先问是不是单机容量问题
看到数据增长或延迟升高,不要直接得出“需要分片”。如果慢请求集中在少数缺索引查询、文档模型造成过度读取、连接池配置失衡,或者短时流量尖峰导致资源抖动,增加 shard 只会把原来的低效访问复制到更多机器上。
真正接近分片条件的信号通常是持续性的:数据和索引逼近单机可接受的存储上限;热点工作集长期挤压内存并造成明显 I/O 压力;CPU 或磁盘吞吐在代表性负载下接近容量上限;继续升级单机规格的成本、可用规格或维护窗口已经不合理。
用同一时间窗收集证据
判断应基于一段代表性业务周期,而不是某一秒的快照。先在 Primary 上采集数据库大小、连接数、操作计数和 WiredTiger cache 使用情况,再与主机 CPU、磁盘延迟、IOPS、吞吐和应用 P95/P99 放到同一时间轴上。
const app = db.getSiblingDB("app");
const dbStats = app.stats(1024 * 1024);
const server = db.serverStatus();
const cache = server.wiredTiger?.cache ?? {};

printjson({
  dbSizeMB: dbStats.totalSize,
  dataSizeMB: dbStats.dataSize,
  indexSizeMB: dbStats.indexSize,
  connectionsCurrent: server.connections.current,
  opcounters: server.opcounters,
  wiredTigerCache: {
    bytesCurrentlyInCache: cache["bytes currently in the cache"],
    maximumBytesConfigured: cache["maximum bytes configured"],
    pagesReadIntoCache: cache["pages read into cache"],
    pagesWrittenFromCache: cache["pages written from cache"]
  }
});
预期输出中的数值取决于实际负载,因此只验证字段存在并记录时间序列,不使用示例数值作为阈值。
{
  dbSizeMB: <VALUE>,
  dataSizeMB: <VALUE>,
  indexSizeMB: <VALUE>,
  connectionsCurrent: <VALUE>,
  opcounters: { insert: <VALUE>, query: <VALUE>, update: <VALUE>, delete: <VALUE>, getmore: <VALUE>, command: <VALUE> },
  wiredTigerCache: {
    bytesCurrentlyInCache: <VALUE>,
    maximumBytesConfigured: <VALUE>,
    pagesReadIntoCache: <VALUE>,
    pagesWrittenFromCache: <VALUE>
  }
}
bytes currently in the cache 接近配置上限本身不能单独证明必须分片。更重要的是它是否伴随持续的 cache read、磁盘延迟上升和业务延迟恶化,以及增加内存后是否仍很快再次触顶。
按瓶颈决定下一步
可以把判断拆成四道门:先修查询,再看工作集,再看算力与存储,最后评估横向扩展是否能真正分摊负载。
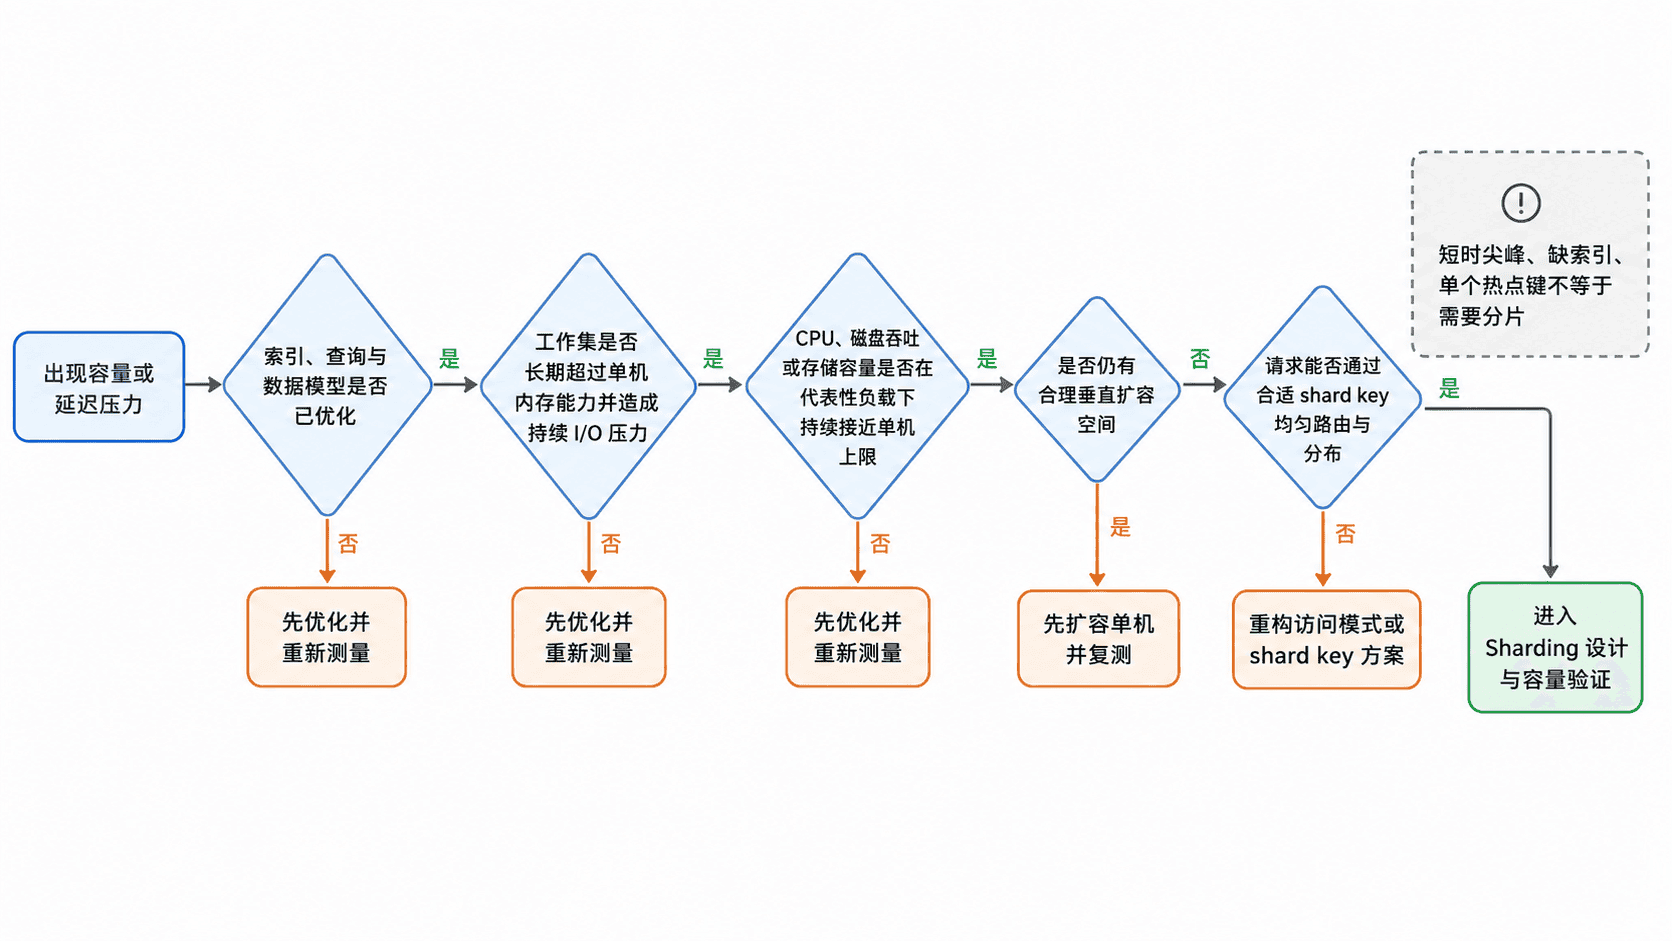
如果瓶颈是 CPU,而且查询能够按不同键值均匀分散,多 shard 有机会把计算分摊到更多节点;如果瓶颈是工作集和存储,分片可以让每个 shard 只承载总数据的一部分。相反,如果所有写入都集中在一个不可拆分的热点键,即使增加 shard,也可能仍由单个 shard 承压。
分片之前先验证 shard key
决定“需要横向扩展”只完成了一半。Sharding 的收益取决于 shard key 能否同时支持数据分布和查询路由。常用查询如果既不包含 shard key,也不包含复合 shard key 的有效前缀,mongos 可能需要向多个 shard 广播请求,节点变多后反而扩大扇出。
候选 shard key 至少要检查三个方面:基数是否足够高,值分布是否会形成明显热点,核心查询是否能够带上用于定向路由的键。对于持续递增的写入键,还要特别评估写流量是否会长期集中到同一数据范围。
形成可执行的决策结论
可以把结论写成容量假设,而不是一句“数据大了就分片”:在代表性高峰下,已完成索引与模型优化;单机 CPU、I/O、内存工作集或存储中的至少一项持续逼近可接受上限;垂直扩容的下一档成本或规格不再合理;并且存在能够把主要读写均匀分布、又支持定向查询的 shard key。
如果这些条件还不成立,继续优化和测量通常比立即引入 mongos、分片元数据、数据均衡和 shard key 运维更简单。只有当瓶颈能够被“多台机器各承担一部分数据与请求”真正拆开时,Sharding 才是在解决根因。