
NoSQL 与搜索 / 系统课时
选择 Skip 与 Range 分页
选择 Skip 与 Range 分页
分页不只是把结果切成几页。数据量变大或列表持续写入后,skip/limit 会同时暴露扫描成本和翻页漂移问题。本课用同一组稳定排序键比较两种分页方式,并实现可以直接用于 API Cursor 的 range pagination。
学习目标
- 判断什么场景适合
skip/limit,什么场景应改用 range pagination - 使用稳定且唯一的复合排序键构造下一页边界
- 理解新增、删除和排序字段变化对翻页一致性的影响
两种分页方式解决的是不同问题
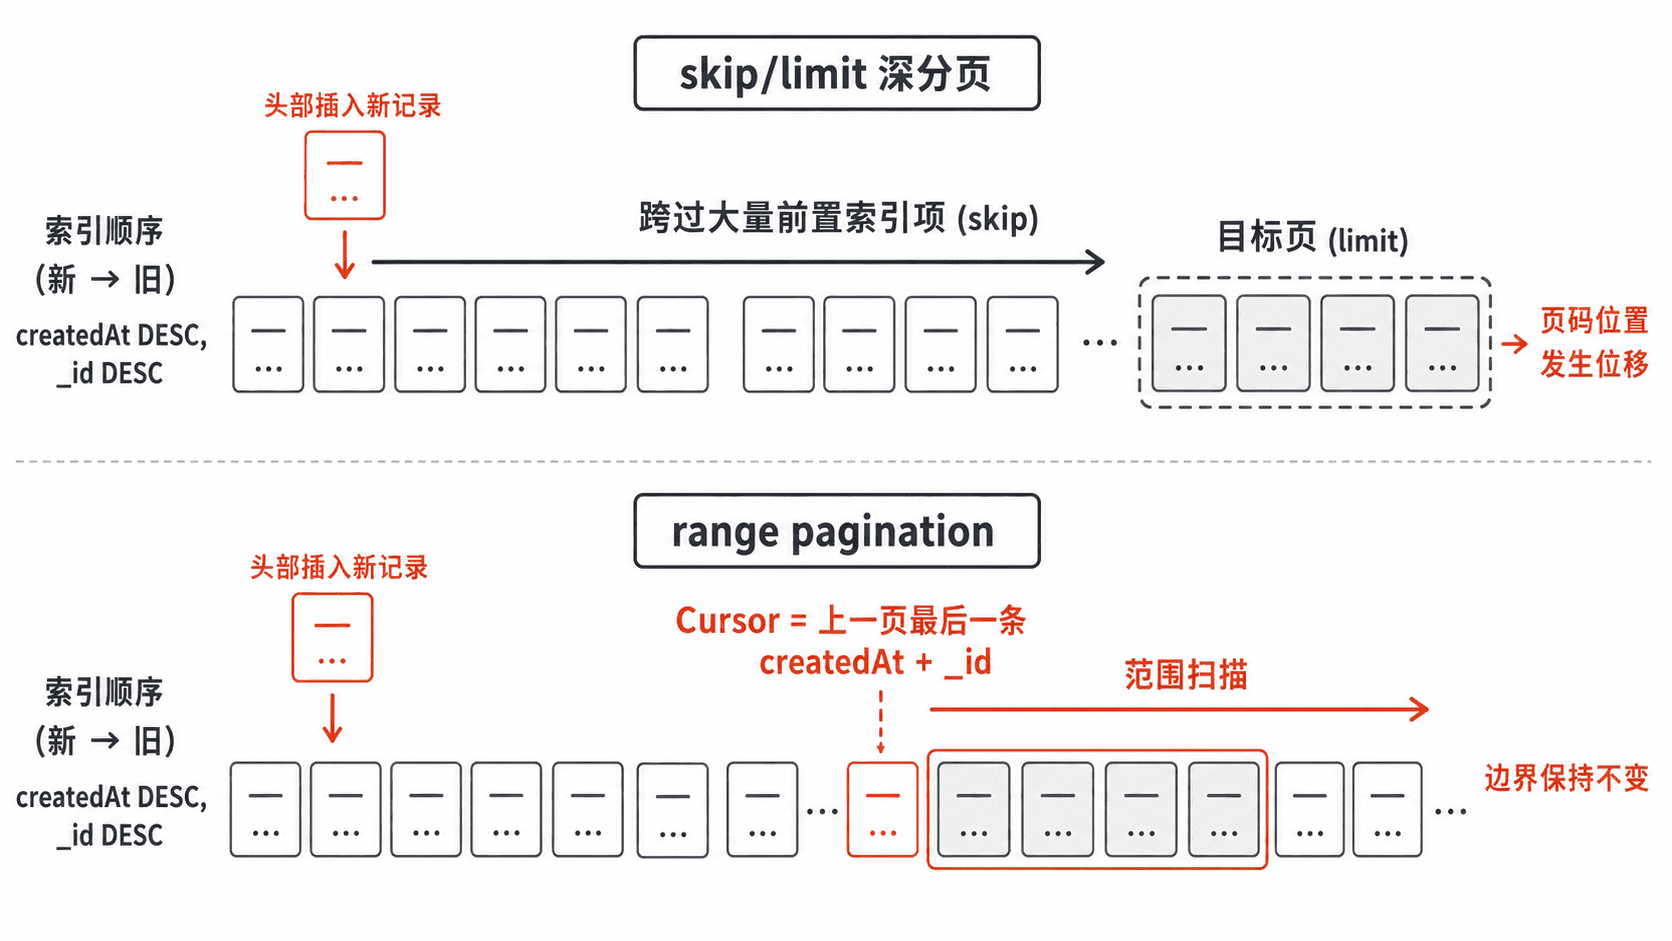
skip/limit 最直观:先按确定顺序排序,再跳过前 N 条。它适合数据量不大、页码跳转有明确产品价值的后台列表,但页码越靠后,需要跨过的记录越多,深分页成本通常越高。
Range pagination 不关心“第几页”,而是记住上一页最后一条记录的排序键,从该边界继续扫描。数据库可以直接从索引中的边界附近开始,因此更适合信息流、订单流和无限滚动等连续翻页场景。
用稳定排序键实现 Range 分页
只按 createdAt 排序并不够,因为多条文档可能拥有相同时间。排序必须追加一个唯一且稳定的 tie-breaker,例如 _id,并让查询与索引采用相同字段顺序。
下面的 mongosh 示例创建复合索引,先读取第一页,再把最后一条记录作为下一页边界。两个字段都按降序排列,因此下一页条件是“时间更小,或者时间相同且 _id 更小”。
db.posts.drop();

db.posts.insertMany([
  { _id: 1, createdAt: ISODate("2026-08-26T12:00:00Z"), title: "A" },
  { _id: 2, createdAt: ISODate("2026-08-26T12:01:00Z"), title: "B" },
  { _id: 3, createdAt: ISODate("2026-08-26T12:02:00Z"), title: "C" },
  { _id: 4, createdAt: ISODate("2026-08-26T12:02:00Z"), title: "D" },
  { _id: 5, createdAt: ISODate("2026-08-26T12:02:00Z"), title: "E" },
  { _id: 6, createdAt: ISODate("2026-08-26T12:03:00Z"), title: "F" }
]);

db.posts.createIndex({ createdAt: -1, _id: -1 });

const firstPage = db.posts
  .find({})
  .sort({ createdAt: -1, _id: -1 })
  .limit(3)
  .toArray();

printjson(firstPage.map(doc => doc._id));

const last = firstPage[firstPage.length - 1];
const secondPage = db.posts
  .find({
    $or: [
      { createdAt: { $lt: last.createdAt } },
      { createdAt: last.createdAt, _id: { $lt: last._id } }
    ]
  })
  .sort({ createdAt: -1, _id: -1 })
  .limit(3)
  .toArray();

printjson(secondPage.map(doc => doc._id));
预期输出:
[ 6, 5, 4 ]
[ 3, 2, 1 ]
这里的关键不是 _id 必须是数字,而是 Cursor 必须保存完整排序键。生产 API 通常把 createdAt 与 _id 编码为不透明 Cursor,客户端只负责原样传回,不自行解释其字段结构。
Skip 的优势是随机跳页
相同数据也可以直接跳过第一页的三条记录。
printjson(
  db.posts
    .find({})
    .sort({ createdAt: -1, _id: -1 })
    .skip(3)
    .limit(3)
    .toArray()
    .map(doc => doc._id)
);
预期输出:
[ 3, 2, 1 ]这使 skip/limit 很适合“直接去第 20 页”这种需求,但代价是偏移量会随页码增长。Range pagination 则无法天然计算任意页号,它优化的是“从当前位置继续读取”。
翻页一致性取决于排序键是否稳定
假设用户读完第一页后,列表头部又插入了一条新记录。第二次执行 skip(3) 时,原有记录的位置整体后移,可能导致上一页末尾的记录再次出现。Range pagination 仍然以 {createdAt, _id} 的旧边界继续,因此头部新增通常不会改变下一页起点。
不过 range pagination 也不是数据库快照。如果已经浏览过的文档被删除,或者某条文档的排序字段被修改到边界另一侧,后续页面仍可能发生变化。因此用于 Cursor 的字段最好不可变;需要严格复现同一批结果时,应额外保存查询截止条件、版本或业务快照,而不是依赖普通分页维持长期快照。
实际选型可以归结为一句话:小结果集和随机页码优先考虑 skip/limit;大结果集、连续翻页和高写入列表优先使用建立在唯一、稳定、已建索引排序键上的 range pagination。