
NoSQL 与搜索 / 系统课时
使用 Query Statistics 分析查询形状
使用 Query Statistics 分析查询形状
单条慢查询只能说明某一次执行出了问题,却不能回答“哪类查询长期消耗最多资源”。本课用 $queryStats 按查询形状汇总调用次数、累计与单次耗时、扫描特征,再把高频低延迟和低频高延迟查询放到同一张优先级表里判断。
学习目标
- 理解查询形状如何把不同字面量的同类查询归为一组
- 使用
$queryStats汇总execCount、执行耗时与扫描指标 - 根据累计成本、平均延迟和执行特征选择真正值得优化的查询
从单次事件转向查询形状
Query Statistics 会把用户提供的部分字面量规范化为类型,因此 { status: "PAID" } 与 { status: "PENDING" } 可以落到相同查询形状,而不是各自成为一条孤立事件。MongoDB 8.0 起还提供 queryShapeHash,便于用稳定的形状标识继续聚合;统计本身保存在内存中的虚拟集合里。:contentReference[oaicite:6]{index=6}
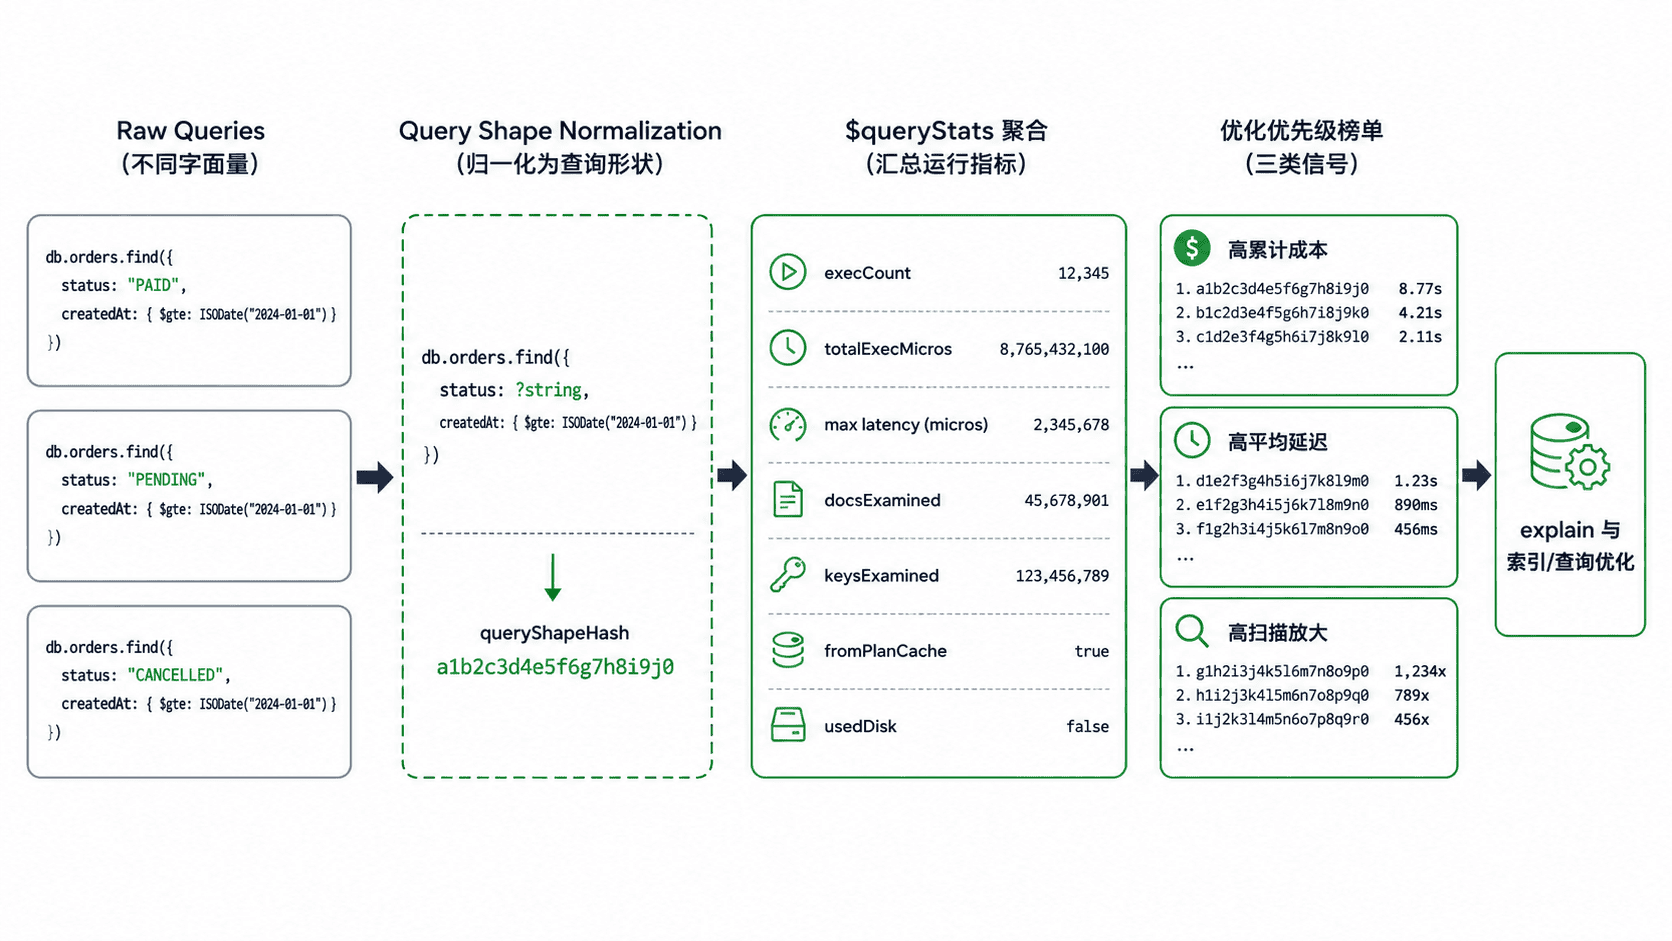
$queryStats 不是针对某个集合执行的普通聚合阶段:流水线必须运行在 admin 数据库,并且 $queryStats 必须是第一阶段。启用访问控制时,执行者还需要 queryStatsRead 权限;内置 clusterMonitor 角色包含读取 Query Statistics 所需的权限。:contentReference[oaicite:7]{index=7}
汇总真正有价值的指标
下面创建一个最小数据集,执行两次只改变 status 值的同形状查询,然后从 admin 读取 Query Statistics。示例以 MongoDB 8.x 为准,因为分组键使用了 queryShapeHash。
const app = db.getSiblingDB("query_stats_lab");

app.orders.drop();
app.orders.insertMany([
  { status: "PAID", createdAt: ISODate("2026-08-20T10:00:00Z") },
  { status: "PENDING", createdAt: ISODate("2026-08-21T10:00:00Z") },
  { status: "CANCELLED", createdAt: ISODate("2026-08-22T10:00:00Z") }
]);
app.orders.createIndex({ status: 1, createdAt: -1 });

// 两次查询只有字面量不同,应归入相同查询形状。
app.orders.find({ status: "PAID" }).sort({ createdAt: -1 }).limit(20).toArray();
app.orders.find({ status: "PENDING" }).sort({ createdAt: -1 }).limit(20).toArray();

const admin = db.getSiblingDB("admin");

admin.aggregate([
  { $queryStats: {} },
  {
    $match: {
      "key.queryShape.cmdNs.db": "query_stats_lab",
      "key.queryShape.cmdNs.coll": "orders"
    }
  },
  {
    $group: {
      _id: "$queryShapeHash",
      shape: { $first: "$key.queryShape" },
      execCount: { $sum: "$metrics.execCount" },
      totalExecMicros: { $sum: "$metrics.totalExecMicros.sum" },
      maxExecMicros: { $max: "$metrics.totalExecMicros.max" },
      docsExamined: { $sum: "$metrics.docsExamined.sum" },
      keysExamined: { $sum: "$metrics.keysExamined.sum" },
      docsReturned: { $sum: "$metrics.docsReturned.sum" }
    }
  },
  {
    $set: {
      avgExecMicros: {
        $cond: [
          { $gt: ["$execCount", 0] },
          { $divide: ["$totalExecMicros", "$execCount"] },
          0
        ]
      }
    }
  },
  { $sort: { totalExecMicros: -1 } }
]).toArray();
预期输出
[
  {
    _id: "<QUERY_SHAPE_HASH>",
    shape: {
      cmdNs: { db: "query_stats_lab", coll: "orders" },
      command: "find",
      filter: { status: { "$eq": "?string" } },
      sort: { createdAt: -1 },
      limit: "?number"
    },
    execCount: NumberLong(2),
    totalExecMicros: <VALUE>,
    maxExecMicros: <VALUE>,
    docsExamined: <VALUE>,
    keysExamined: <VALUE>,
    docsReturned: <VALUE>,
    avgExecMicros: <VALUE>
  }
]
执行时间和扫描量会随机器、缓存状态与版本变化,但关键验证点不变:两个不同 status 值应归并到同一形状,execCount 反映累计执行次数,totalExecMicros.sum 表示该组查询累计消耗的执行时间。$queryStats 还提供 lastExecutionMicros、fromPlanCache、hasSortStage、usedDisk 等运行特征,可在需要时加入聚合。:contentReference[oaicite:8]{index=8}
用总成本而不是单一延迟排序
优化优先级至少要同时看三个维度。totalExecMicros / execCount 很高,说明单次调用慢;totalExecMicros 很高但平均值一般,说明它可能靠高频累积成主要资源消费者;docsExamined 或 keysExamined 持续远高于返回量,则提示扫描放大,需要进一步检查索引前缀、过滤选择性或排序是否被索引覆盖。
只看最大延迟也容易误判。一个一天只出现一次的 2 秒查询,可能不如每秒执行数百次、单次 20 ms 的形状值得优先优化。反过来,如果 maxExecMicros 明显高于平均值,则应保留代表性参数继续检查数据倾斜、缓存冷热、锁等待或计划不稳定,而不是用平均数掩盖尾延迟。
与 Profiler 和 explain 形成闭环
Query Statistics 适合回答“先查哪一类查询”,Profiler 适合查看具体慢操作上下文,explain("executionStats") 则用于验证候选索引或查询改写后的执行路径。三者的顺序通常是:先按形状找高累计成本,再取代表性参数复现,最后用执行计划验证改动是否真的减少扫描与耗时。
当一项优化上线后,应再次观察同一 queryShapeHash 的累计时间、平均时间和扫描量是否下降。这样性能治理才从“追一条慢日志”升级为“按查询形状持续管理工作负载”。