
NoSQL 与搜索 / 系统课时
设计成员角色与故障域
设计成员角色与故障域
复制集拓扑设计的目标不是“多放几台机器”,而是让选举多数派、可成为 primary 的成员和特殊用途副本分布在独立故障域中。正确配置 priority、votes、hidden 与 secondaryDelaySecs,可以避免单个可用区故障被放大成整组不可写。
学习目标
- 说明
priority、votes、hidden与secondaryDelaySecs各自改变什么行为。 - 为跨可用区复制集安排投票成员、可选主成员和特殊用途成员。
- 识别会破坏多数派或拖慢提交点的错误拓扑。
先把选举成员与特殊成员分开
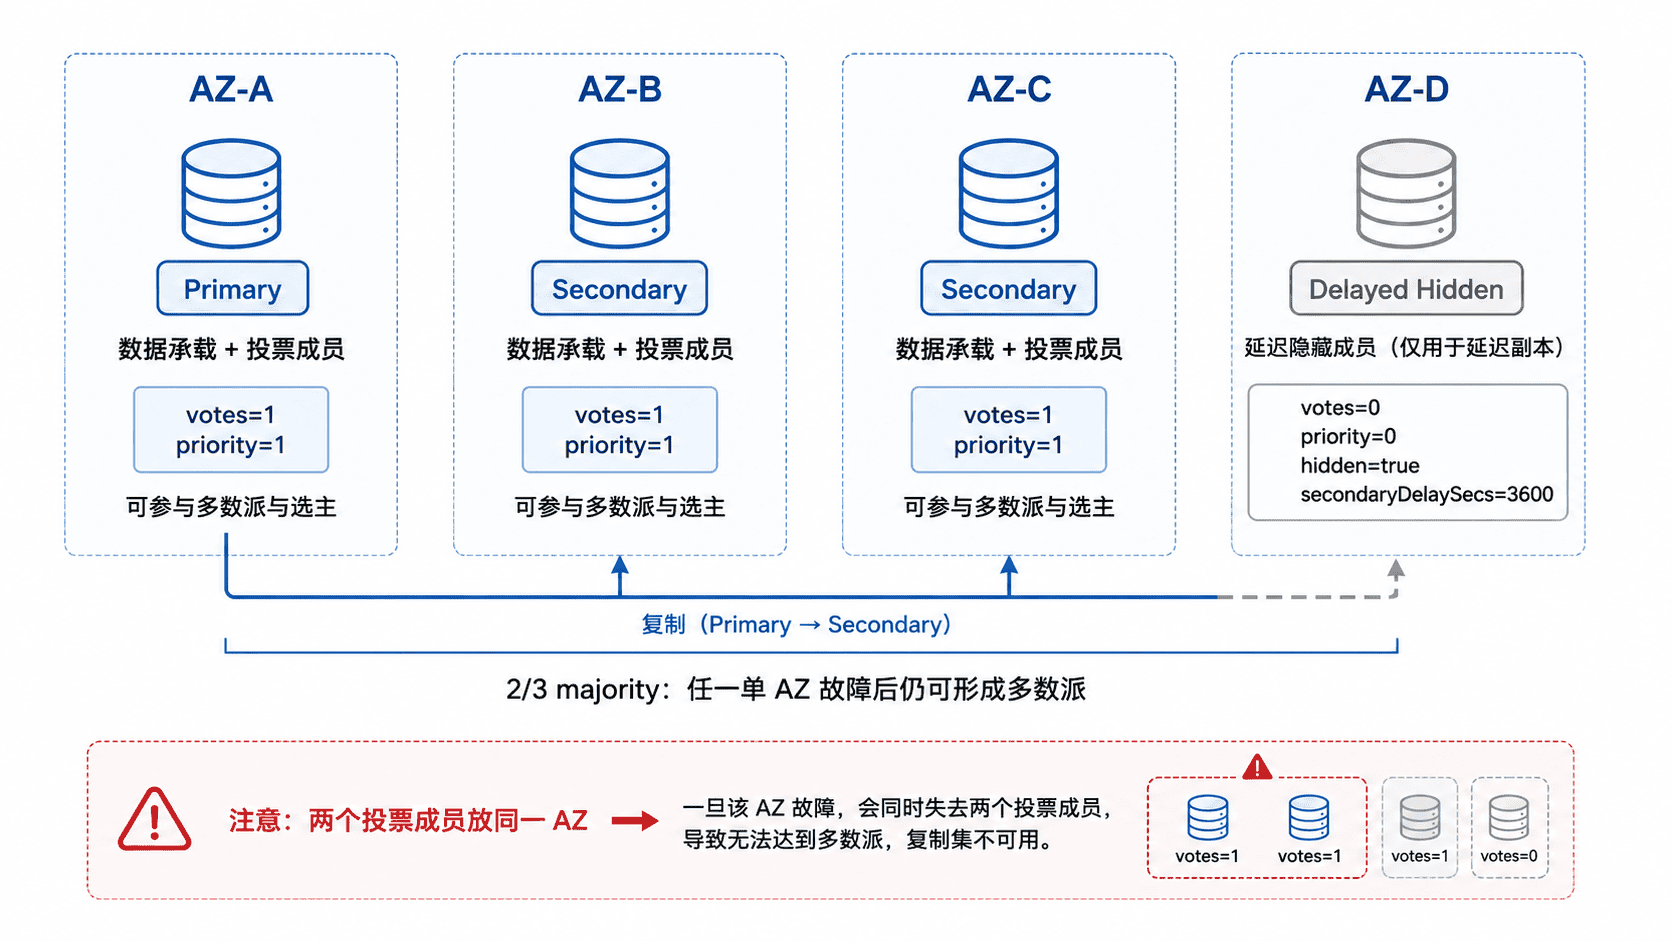
votes 决定成员是否参与选举多数派,priority 决定成员是否有资格以及多大倾向成为 primary。priority: 0 的成员不能成为 primary;非投票成员也必须是 priority: 0。隐藏成员同样必须为 priority: 0,适合备份或专用读取等不希望被普通客户端发现的用途。:contentReference[oaicite:2]{index=2}
延迟成员通过 secondaryDelaySecs 故意保留过去时点的数据。MongoDB 建议延迟成员同时设置为 hidden、priority: 0,并在需要避免其影响 majority 提交时使用非投票配置;延迟时长还必须小于可用的 oplog window。:contentReference[oaicite:3]{index=3}
用故障域决定投票布局
最常见且容易推理的基线是三个数据承载、可投票成员分别放在三个独立可用区。多数派为 2,只损失任意一个可用区时仍能选出 primary。若把两个投票成员放在同一故障域,表面上仍有三节点,实际上该域故障可能一次带走多数派。
priority 不应被当作“故障域权重”。除非有明确的数据驻留、延迟或主库位置要求,否则让三个正常投票成员保持相同优先级更简单。只有确实希望某些节点永不接管 primary 时,才把它们设为 priority: 0。
配置一个三投票加延迟成员的拓扑
下面示例假设四个成员已经加入复制集,并且当前连接的是 primary。前三个成员跨三个故障域参与选举;第四个成员作为一小时延迟副本,不投票、不参与选主,也不向普通客户端暴露。
const cfg = rs.conf();

function member(host) {
  const found = cfg.members.find((m) => m.host === host);
  if (!found) throw new Error(`未找到成员 ${host}`);
  return found;
}

for (const host of ["mongo-a:<PORT>", "mongo-b:<PORT>", "mongo-c:<PORT>"]) {
  const m = member(host);
  m.votes = 1;
  m.priority = 1;
  m.hidden = false;
  m.secondaryDelaySecs = 0;
}

const delayed = member("mongo-d:<PORT>");
delayed.votes = 0;
delayed.priority = 0;
delayed.hidden = true;
delayed.secondaryDelaySecs = 3600;

rs.reconfig(cfg);

printjson(rs.conf().members.map((m) => ({
  host: m.host,
  votes: m.votes,
  priority: m.priority,
  hidden: m.hidden ?? false,
  secondaryDelaySecs: m.secondaryDelaySecs ?? 0
})));
预期输出
[
  { host: 'mongo-a:<PORT>', votes: 1, priority: 1, hidden: false, secondaryDelaySecs: 0 },
  { host: 'mongo-b:<PORT>', votes: 1, priority: 1, hidden: false, secondaryDelaySecs: 0 },
  { host: 'mongo-c:<PORT>', votes: 1, priority: 1, hidden: false, secondaryDelaySecs: 0 },
  { host: 'mongo-d:<PORT>', votes: 0, priority: 0, hidden: true, secondaryDelaySecs: 3600 }
]
<PORT> 替换为实际端口。rs.reconfig() 可能触发选举或连接切换,应在维护窗口执行,并先确认当前多数派健康。
避免几种会放大故障的配置
不要把“大多数投票权”集中在同一机架、宿主机或可用区,否则故障域与选举多数派不一致。也不要为了“增加保险”随意加入投票成员;投票成员越多并不等于可用性线性增加,关键仍是它们是否跨独立故障域。
延迟成员更不应承担正常故障转移职责。它保存的是刻意滞后的数据,若让它参与正常应用读取或多数派提交,会把恢复用途与在线可用性耦合起来。隐藏、非投票、priority: 0 能让它的职责更单一。
用故障演练验证拓扑
配置完成后,先检查 rs.status() 中三个位于独立故障域的正常成员都健康,再逐个模拟单一故障域不可用。验收标准不是“节点还活着”,而是剩余成员仍能形成多数派、选出合适的 primary,并且应用能恢复写入。
最终应能一句话解释每个成员为什么存在:哪些节点负责形成多数派,哪些节点允许成为 primary,哪些节点只承担备份或延迟恢复。只要这三件事与物理故障域一致,复制集拓扑才真正具备可预期的故障行为。