
NoSQL 与搜索 / 系统课时
执行 Resharding 并排查热点
执行 Resharding 并排查热点
Resharding 不是“换个 shard key”这么简单:它同时改变数据分布与路由行为。本课以 commerce.orders 为例,完成变更前检查、执行与进度监控,并用查询采样区分 scatter-gather、单调写入热点和 jumbo 范围。
学习目标
- 能规划并执行
reshardCollection,理解资源与变更窗口要求 - 能用
$currentOp和analyzeShardKey判断迁移进度与路由热点 - 能针对 scatter-gather、热点分片和 jumbo 选择正确修复手段
先把 Resharding 当成一次数据迁移
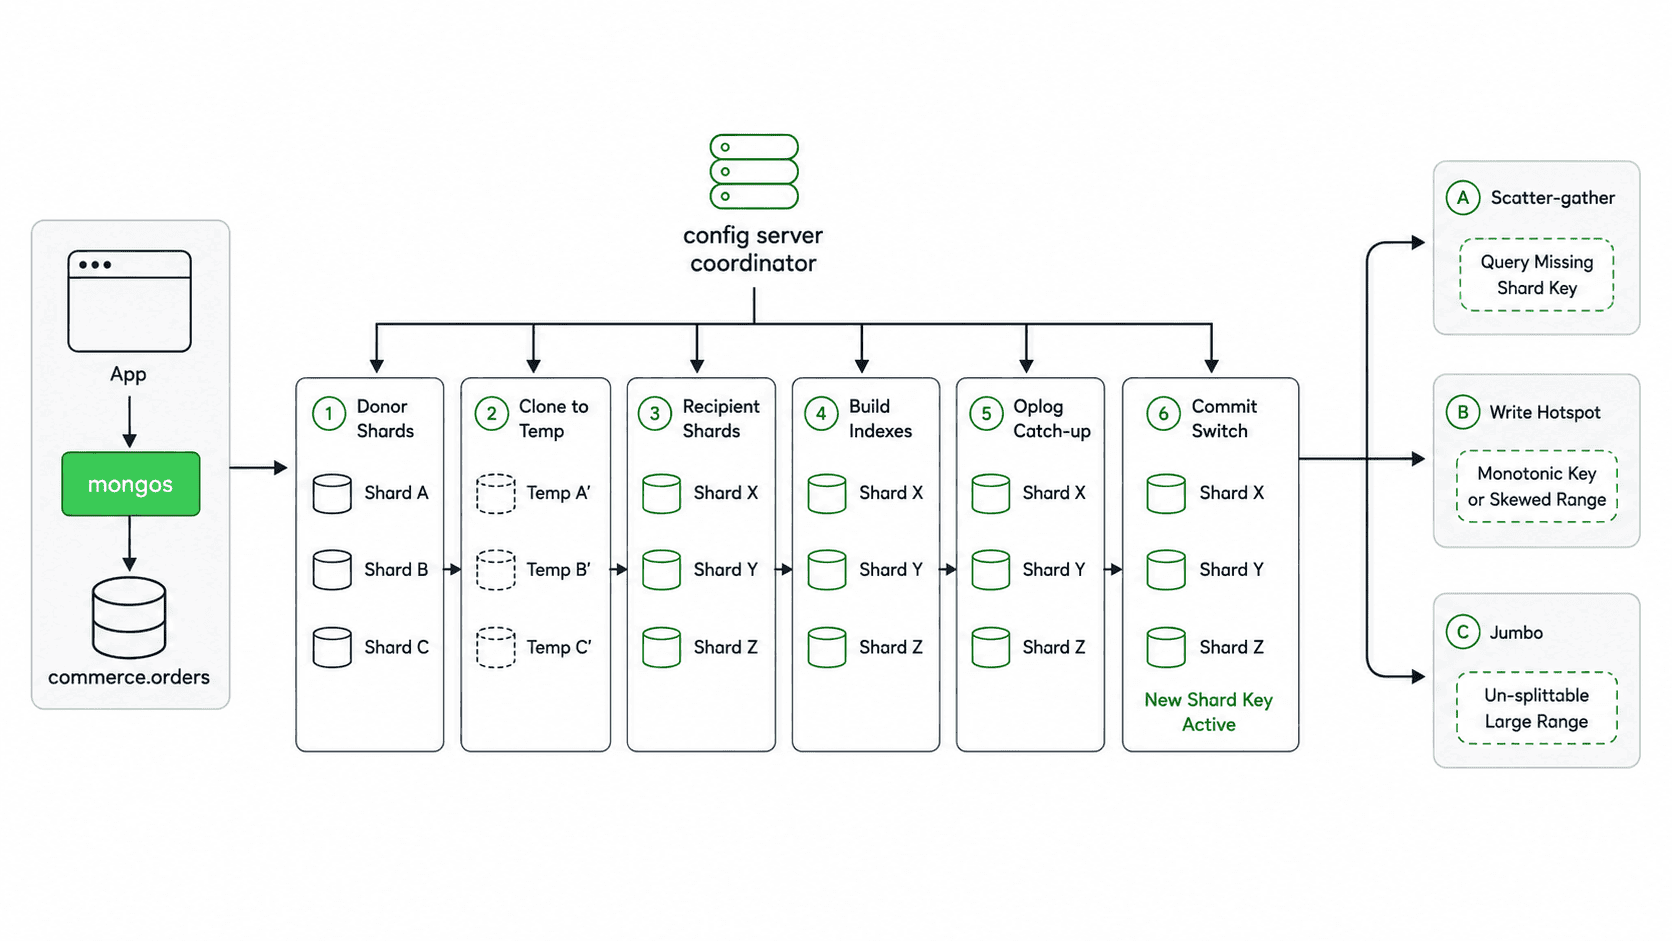
MongoDB 8.0 的 Resharding 会由 config server 主节点协调 donor 与 recipient:先计算新分布,再克隆数据、构建索引、追赶 oplog,最后提交并切换集合。官方要求一次只 Reshard 一个集合,开始前暂停 balancer,并确保没有正在进行的索引构建。:contentReference[oaicite:0]{index=0}
容量不能只看“当前集合还能放下”。每个 recipient shard 需要为新副本和索引预留额外空间,官方基线为 ((collection_storage_size + index_size) * 2) / shard_count;同时建议把 I/O 使用率压到 50% 以下、CPU 压到 80% 以下。在线变更还要让应用在过渡期兼容旧、新 shard key 的查询路由。:contentReference[oaicite:1]{index=1}
执行并监控迁移
假设当前查询经常按 tenantId 定位租户,而订单号需要打散写入,可将新 key 设计为 { tenantId: 1, orderId: "hashed" }。连接到 mongos 后执行命令;Resharding 会自动在索引阶段构建兼容新 shard key 的索引,不要在迁移进行中并发创建索引。:contentReference[oaicite:2]{index=2}
db.adminCommand({
  reshardCollection: "commerce.orders",
  key: { tenantId: 1, orderId: "hashed" }
})
预期输出
{ ok: 1, ... }实际输出还会包含集群时间等字段。ok: 1 表示命令成功完成;如果需要观察运行中的阶段,应在另一个 mongosh 会话通过 $currentOp 查询。
db.getSiblingDB("admin").aggregate([
  { $currentOp: { allUsers: true, localOps: false } },
  {
    $match: {
      type: "op",
      "originatingCommand.reshardCollection": "commerce.orders"
    }
  }
])
预期输出
{
  ns: 'commerce.orders',
  totalOperationTimeElapsedSecs: Long('<VALUE>'),
  remainingOperationTimeEstimatedSecs: Long('<VALUE>'),
  documentsCopied: Long('<VALUE>'),
  bytesCopied: Long('<VALUE>'),
  provenance: 'reshardCollection',
  ...
}
<VALUE> 会随实时进度变化。重点看剩余时间是否持续下降、复制字节是否增长,以及业务延迟、CPU、磁盘与 oplog 是否同时出现异常;只盯“chunk 数是否均匀”不足以判断迁移健康。$currentOp 会暴露 Resharding 的剩余时间、复制文档数与字节数等字段。:contentReference[oaicite:3]{index=3}
用采样区分三类热点
热点排查先回答两个问题:请求被路由到几个 shard,以及请求是否集中在少数 shard key 范围。mongos 对缺少 shard key 的查询可能广播到所有 shard,形成 scatter-gather;分片数量越多,这类请求的额外开销越明显。:contentReference[oaicite:4]{index=4}
先开启有限速率的查询采样,再分析候选 shard key。以下命令应连接 mongos 执行;采样需要覆盖有代表性的业务时段,否则热点判断会失真。
db.getSiblingDB("commerce").orders.configureQueryAnalyzer({
  mode: "full",
  samplesPerSecond: 5
})
预期输出
{ ok: 1 }采样覆盖到代表性业务流量后,再分析候选 shard key。
db.getSiblingDB("commerce").orders.analyzeShardKey(
  { tenantId: 1, orderId: "hashed" },
  {
    keyCharacteristics: true,
    readWriteDistribution: true,
    sampleSize: 100000
  }
)
预期结果
{
  keyCharacteristics: {
    monotonicity: { type: '<VALUE>', ... },
    ...
  },
  readWriteDistribution: {
    readDistribution: {
      percentageOfScatterGatherReads: <VALUE>,
      numReadsByRange: [ <VALUE>, ... ],
      ...
    },
    writeDistribution: {
      numWritesByRange: [ <VALUE>, ... ],
      ...
    }
  },
  ok: 1
}
analyzeShardKey 的读写分布来自已采样查询;没有先配置 query analyzer 时,相关指标可能缺失或没有分析价值。重点观察 percentageOfScatterGatherReads、范围读写分布是否严重偏斜,以及 monotonicity.type 是否为 monotonic。:contentReference[oaicite:5]{index=5}
按根因修复而不是搬 chunk
scatter-gather 高时,先检查高频 find、aggregate、updateMany 是否缺少 shard key 或其可路由前缀;能改请求模型就让过滤条件带上 shard key,并为实际过滤与排序补合适索引。单纯继续加 shard,只会让一次广播访问更多节点。
写热点如果来自单调递增或递减的 range key,新写入会持续落到拥有 MaxKey 或 MinKey 范围的 shard,使单个 shard 成为写入上限。此时应重新设计 key,例如引入高基数字段、复合维度或 hashed 部分,而不是靠手工 moveChunk 追着热点搬。:contentReference[oaicite:6]{index=6}
jumbo 表示某个超大范围无法按当前边界正常拆分或迁移。优先判断该范围是否可拆分;可拆分时先 split。若范围因低基数等原因本质上不可拆,应该 refine 或再次 Reshard shard key。直接清除 jumbo 标记并不会缩小范围,MongoDB 后续仍可能再次把它标成 jumbo;forceJumbo 迁移还会阻塞集合写入,不应作为常规修复。:contentReference[oaicite:7]{index=7}
验证新的路由是否真正变好
完成后不要只看数据“更平均”。用同一组代表性请求重新做 explain 与 query sampling,确认单 shard 请求占比上升、scatter-gather 下降、numReadsByRange 与 numWritesByRange 不再高度集中,并观察各 shard 的 CPU、磁盘与延迟是否收敛。
如果分布看起来均衡但业务延迟仍高,问题通常已经从“数据在哪个 shard”转成“查询是否可定向、索引是否命中、某个租户是否天然超大”。Resharding 解决的是分布与路由边界,只有把真实访问模式一起纳入 shard key,水平扩展才会持续有效。