
NoSQL 与搜索 / 系统课时
规划容量与连接池
规划容量与连接池
容量规划要把“现在有多少数据”改写成可验证的资源预算:数据与索引决定磁盘,热数据与热索引决定内存,峰值数据库操作率与延迟决定并发,连接池再把并发约束落实到每个应用实例。最终目标不是把机器配到最大,而是在峰值和增长期仍保留可恢复余量。
学习目标
- 用数据量、索引体积、工作集与增长率估算内存和磁盘需求。
- 用峰值数据库操作率与延迟估算并发,再分配到应用连接池。
- 通过 MongoDB 运行指标和压测结果校准 CPU、磁盘与池大小。
先把容量拆成可测量的变量
容量评估至少同时看五组量:数据与索引体积、工作集、数据库操作率与延迟、CPU 与磁盘利用率、连接数。只看数据库文件大小会漏掉索引、oplog、临时空间和增长余量;只看 QPS 又无法判断单次请求是否包含多个数据库操作。
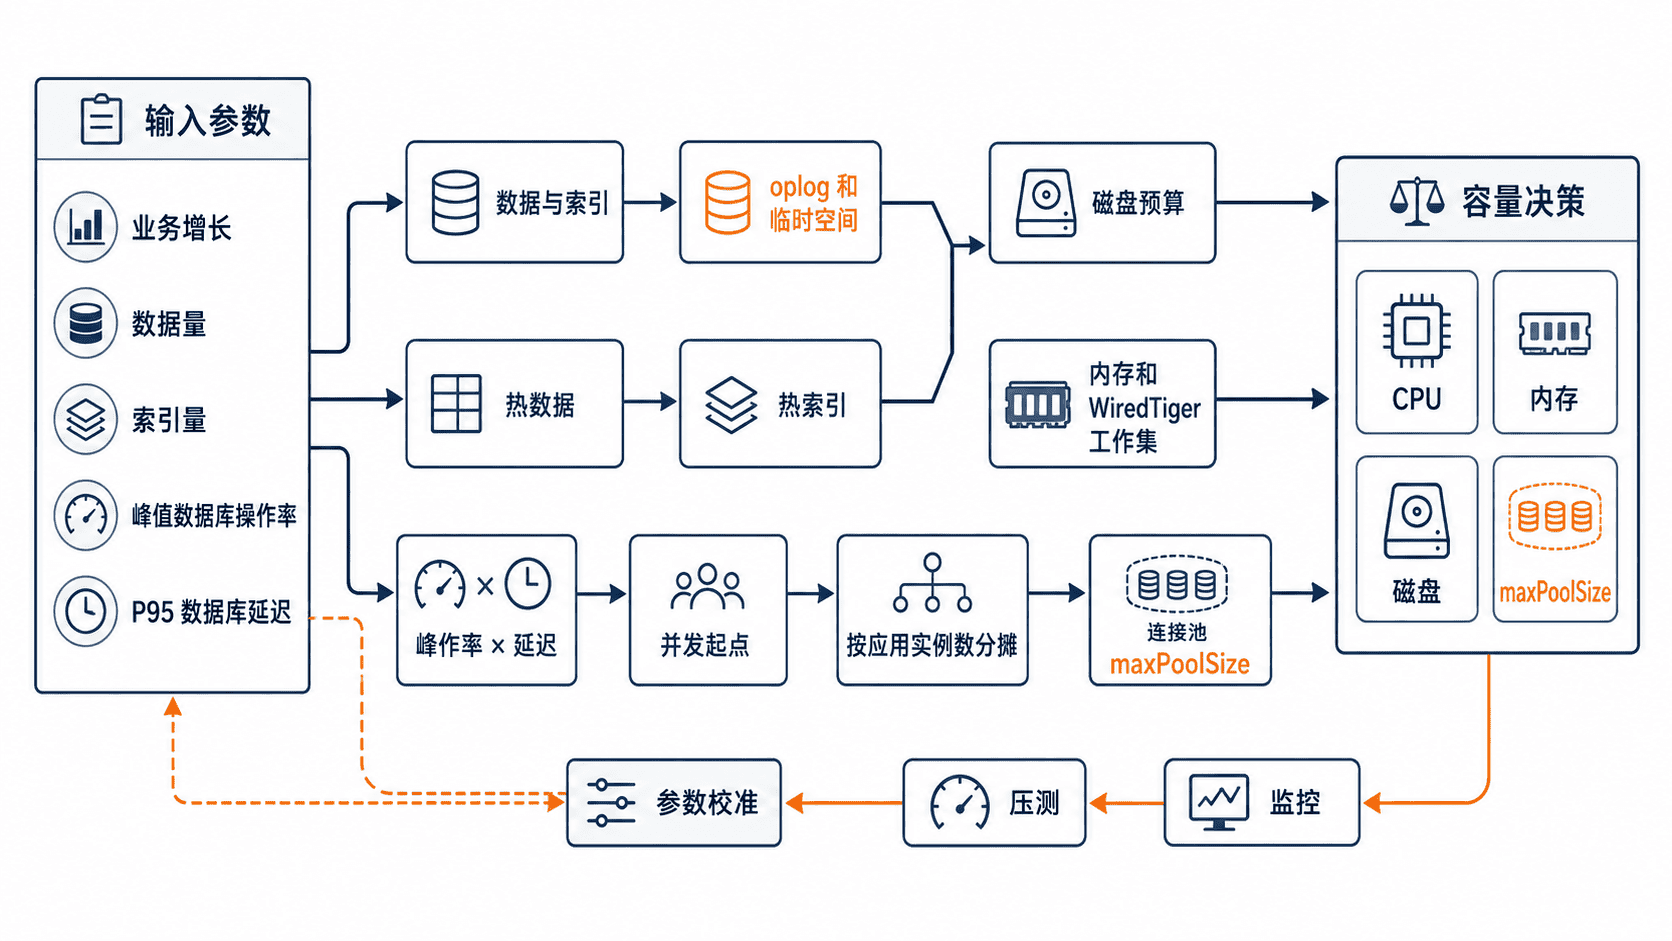
磁盘可用一个简单预算式做第一轮估算:目标磁盘 = (数据 + 索引 + oplog + 临时空间) × 增长系数 ÷ 目标最高利用率。例如把最高利用率策略设为 70%,本质上是在容量中预留约 30% 空间给突发增长、索引构建、压缩与维护,而不是把 70% 当作 MongoDB 的固定阈值。
用运行统计建立当前基线
下面的 mongosh 示例从业务数据库读取数据、存储和索引体积,同时从当前 mongod 读取连接数与 WiredTiger 缓存上限。把 app 改成实际数据库名;分片集群应按 shard 分别采集,因为单个节点的内存、磁盘和连接压力可能并不均匀。
const dbName = "app";
const GiB = 1024 ** 3;
const appDb = db.getSiblingDB(dbName);
const adminDb = db.getSiblingDB("admin");

const dbStats = appDb.runCommand({ dbStats: 1, scale: GiB });
const serverStatus = adminDb.serverStatus();
const wtCache = serverStatus.wiredTiger?.cache;

printjson({
  db: dbName,
  dataGiB: dbStats.dataSize,
  storageGiB: dbStats.storageSize,
  indexGiB: dbStats.indexSize,
  connections: {
    current: serverStatus.connections.current,
    available: serverStatus.connections.available
  },
  wiredTigerCacheGiB: wtCache
    ? wtCache["maximum bytes configured"] / GiB
    : null
});
预期输出
{
  db: 'app',
  dataGiB: <VALUE>,
  storageGiB: <VALUE>,
  indexGiB: <VALUE>,
  connections: { current: <VALUE>, available: <VALUE> },
  wiredTigerCacheGiB: <VALUE>
}
<VALUE> 会随数据规模、部署规格和实时负载变化。这里最重要的不是某个瞬时值,而是把这些指标按小时和业务高峰持续记录,再与 CPU、磁盘 IOPS、读写延迟及页面换入换出趋势一起观察。
把工作集映射到内存与磁盘
工作集不是数据库总大小,而是高频访问的文档页和索引页。若热点索引与热点数据能长期留在内存,读请求更少触发磁盘;如果工作集持续超过可用内存,常见表现是磁盘读放大、尾延迟上升,即使平均 QPS 没变也会出现抖动。
因此内存规划应优先回答“峰值时真正热的页面有多少”,而不是简单要求全部数据进内存。磁盘规划则同时看容量和性能:空间够但随机 IOPS 或写延迟已经饱和,同样需要扩容、换更快介质,或通过索引和查询治理降低压力。
用并发估算连接池起点
连接池大小不应直接等于峰值 QPS。更有用的起点是按数据库操作级别估算并发:并发起点 ≈ 峰值数据库操作率 × 单次数据库操作耗时。例如峰值为 1500 次数据库操作/秒、P95 为 40 ms,可先按约 60 个并发操作估算;若有 6 个应用实例,平均约 10 个并发/实例,再为突发和后台任务留出余量。
下面是驱动连接字符串的配置片段,不是独立命令。数值只是上述示例的起始配置,必须结合应用实例数、拓扑和压测再调整。
mongodb://<HOST1>:<PORT>,<HOST2>:<PORT>,<HOST3>:<PORT>/app?replicaSet=<REPLICA_SET>&maxPoolSize=20&minPoolSize=5&maxConnecting=2&waitQueueTimeoutMS=2000这组配置把每个服务器连接池的上限限制为 20,并限制连接建立并发与等待时间。实际总连接数还受应用实例数量、MongoDB 拓扑和驱动监控连接影响,因此不能用 应用实例数 × maxPoolSize 当作整个集群的精确连接数。
用压测校准资源边界
先用接近真实的读写比例、索引命中方式和请求分布压到目标峰值,再观察三类信号:CPU 是否长期接近饱和、磁盘延迟是否随负载陡增、连接池是否出现持续等待。如果池等待明显而服务器资源仍有余量,可以小步增加池;如果服务器已经饱和,继续放大池只会让排队从应用侧转移到数据库侧。
容量计划最终应保留“当前基线、增长假设、峰值目标、告警阈值、扩容触发条件”五项记录。这样当数据量或 QPS 变化时,可以重新代入同一套模型验证,而不是靠一次性的机器规格猜测长期容量。