
NoSQL 与搜索 / 系统课时
搭建三成员复制集
搭建三成员复制集
本课把三个可互相访问的 mongod 组成一个可选主的复制集:统一配置 replSetName,初始化成员,检查 rs.status(),再主动触发 Primary 切换并验证使用复制集 URI 的客户端仍能发现新主节点。
学习目标
- 为三个成员配置一致的复制集名称并完成初始化
- 用
rs.status()和读写探针确认 Primary、Secondary 与复制链路 - 主动执行 Primary step down,并验证客户端的拓扑发现与故障转移
让三个成员共享同一复制集身份
以下以三台 Linux 主机 mongodb0.example.net、mongodb1.example.net、mongodb2.example.net 为例,每台机器运行一个 mongod。三个主机名必须能彼此解析,27017 端口也必须在成员之间可达。生产环境应使用稳定 DNS 名称,不要把会变化的地址写进成员配置。
每台机器的配置文件都要使用同一个 replication.replSetName,但 net.bindIp 应包含本机实际可达的主机名。下面是配置模板,<HOSTNAME> 与 <PATH> 按当前机器替换。
storage:
  dbPath: <PATH>
net:
  port: 27017
  bindIp: localhost,<HOSTNAME>
replication:
  replSetName: rs0
该配置生效后,三个进程仍是未初始化的复制集成员。若使用 systemd 管理进程,可重启并检查服务状态。
sudo systemctl restart mongod
systemctl is-active mongod
预期输出:
active如果服务无法启动,优先检查三件事:dbPath 是否存在且可写、bindIp 中的主机名是否属于本机、三个成员的 replSetName 是否完全一致。
初始化成员并检查状态
只在一个成员上执行一次 rs.initiate()。下面从 mongodb0.example.net 连接,并把三个成员写入同一个复制集配置。
rs.initiate({
  _id: "rs0",
  members: [
    { _id: 0, host: "mongodb0.example.net:27017" },
    { _id: 1, host: "mongodb1.example.net:27017" },
    { _id: 2, host: "mongodb2.example.net:27017" }
  ]
})
预期输出:
{ ok: 1 }初始化会触发选举。等待几秒后,用精简表达式查看角色,避免被 rs.status() 的大量心跳字段淹没。
rs.status().members.map(({ name, stateStr }) => ({ name, stateStr }))预期输出类似:
[
  { name: '<PRIMARY_HOST>:27017', stateStr: 'PRIMARY' },
  { name: '<SECONDARY_HOST_1>:27017', stateStr: 'SECONDARY' },
  { name: '<SECONDARY_HOST_2>:27017', stateStr: 'SECONDARY' }
]
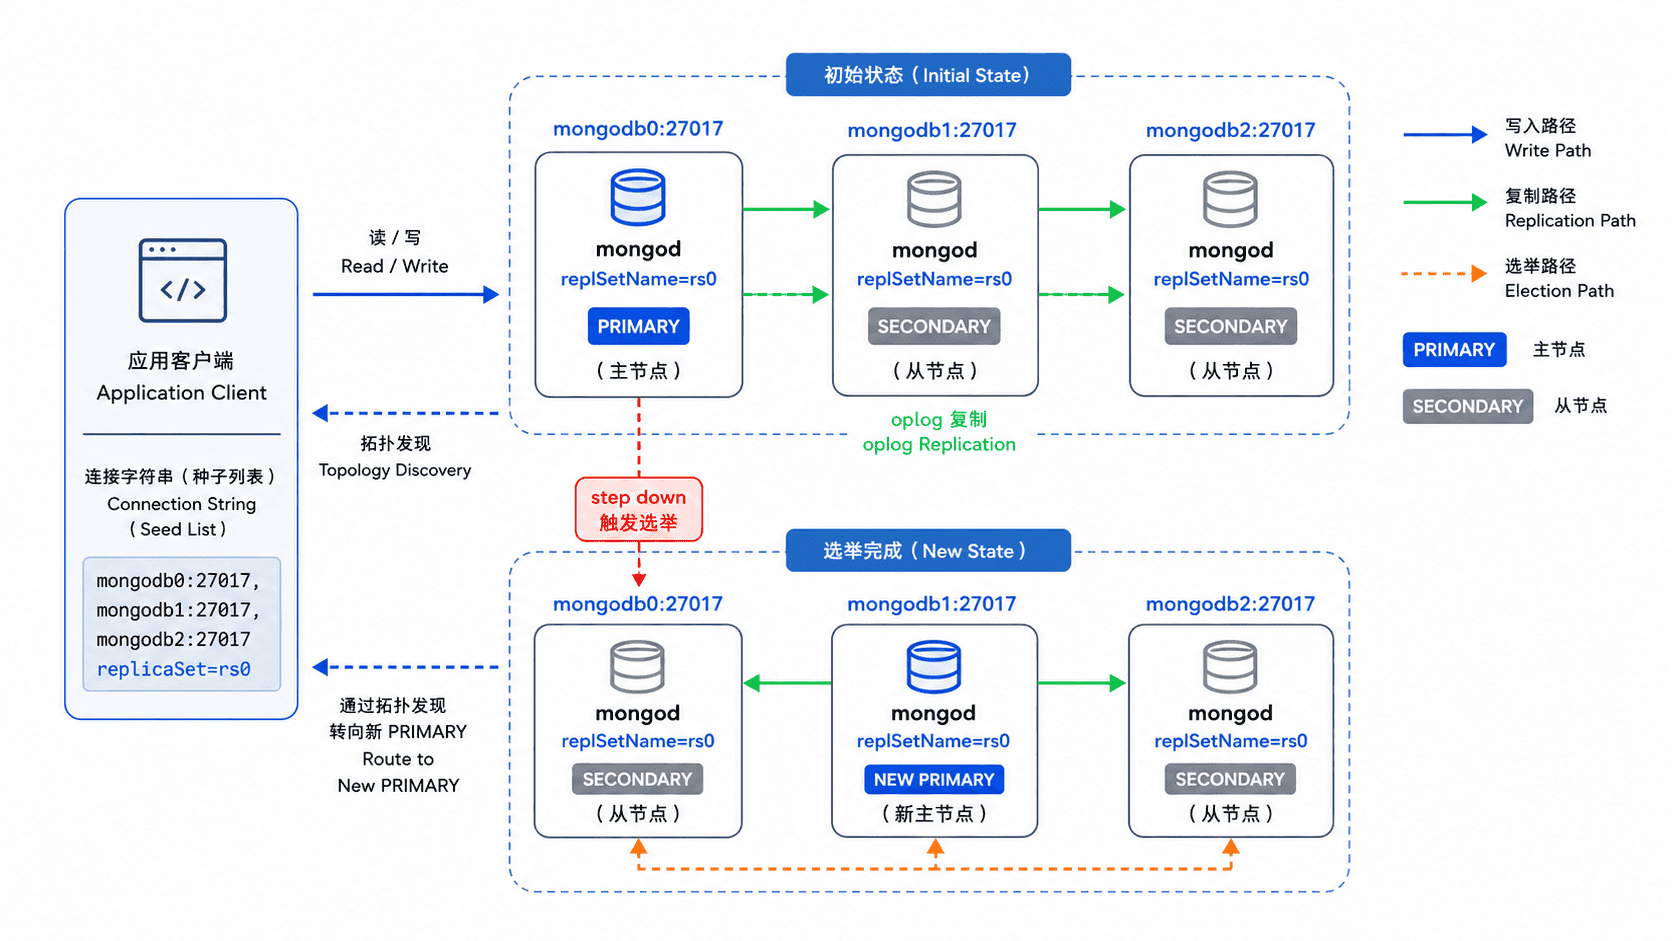
实际谁成为 Primary 可能不同,但健康的三成员复制集应稳定为一个 PRIMARY 和两个 SECONDARY。如果成员长期停在 STARTUP2、RECOVERING 或不可达状态,应先处理复制、磁盘、DNS 或网络问题,再做故障切换测试。
验证复制链路
客户端不要只写一个固定主机,而应使用多个 seed host 加 replicaSet=rs0。下面通过复制集 URI 连接后写入探针,再强制从 Secondary 读取同一文档。
use("rs_lab")
db.health.insertOne({ _id: "probe-1", message: "replicated" })
db.health.find({ _id: "probe-1" }).readPref("secondary").limit(1).toArray()
预期输出:
{ acknowledged: true, insertedId: 'probe-1' }
[ { _id: 'probe-1', message: 'replicated' } ]
第二条查询能返回文档,说明数据已经复制到至少一个可读 Secondary。由于复制是异步的,刚写完立刻读 Secondary 时可能短暂无结果;验证时可以稍后重试,而不要把 Secondary 读取当成“读到最新写入”的保证。
强制切换 Primary 并观察客户端
先用复制集 URI 建立一个正常客户端连接。种子列表的作用是帮助驱动发现完整拓扑,不代表每次操作都会固定访问列表中的第一个地址。
mongodb://mongodb0.example.net:27017,mongodb1.example.net:27017,mongodb2.example.net:27017/?replicaSet=rs0随后连接当前 Primary,在 mongosh 中让它 60 秒内不能重新成为 Primary。
rs.stepDown(60)预期结果:
原 PRIMARY 降级为 SECONDARY;一个符合选举条件的 SECONDARY 被选为新的 PRIMARY。回到使用复制集 URI 的客户端,再查看拓扑中的主节点并执行一次写入。
db.hello().primary
db.getSiblingDB("rs_lab").health.insertOne({ _id: "probe-after-failover", ok: true })
预期输出类似:
<NEW_PRIMARY_HOST>:27017
{ acknowledged: true, insertedId: 'probe-after-failover' }
选举期间可能出现短暂不可写窗口,因此测试重点不是“零瞬时错误”,而是确认驱动能重新发现 Primary、连接串无需修改,并在新主节点可用后继续操作。若客户端写死单节点地址,或 URI 缺少正确的 replicaSet 名称,就无法获得完整的复制集拓扑语义。
生产部署要补上的边界
三成员复制集解决的是冗余、选举与故障转移,不等于完成生产高可用。三个有投票权的成员应尽量分布在独立故障域,并持续监控复制延迟、心跳、磁盘与选举频率。计划内维护 Primary 时可以主动 step down,但不要把频繁切主当成普通负载均衡手段。
应用侧还要使用能够识别复制集的官方驱动,并设置合适的超时、重试、write concern 与 read concern。完成这些约束后,复制集才不仅是“三个进程都在线”,而是一个客户端能够正确感知并利用的高可用拓扑。