
NoSQL 与搜索 / 系统课时
使用 Change Streams 订阅变更
使用 Change Streams 订阅变更
Change Streams 让应用持续接收 MongoDB 已提交的数据变化,而不必轮询集合。本课会建立带过滤的变更流,保存 resume token,并设计可恢复、可重放的消费循环,最终可直接作为缓存失效或事件驱动流程的数据源。
学习目标
- 使用
watch()订阅集合变更并过滤事件 - 正确保存和恢复 resume token,避免断线后从头消费
- 处理重连、历史窗口丢失与重复消费边界
Change Streams 在订阅什么
Change Streams 依赖复制集或分片集群的复制日志,因此不能在独立的 standalone mongod 上使用。应用调用 watch() 后会得到一个长期存在的游标;每次匹配到变化,MongoDB 返回包含 operationType、documentKey、命名空间以及 _id 的事件,其中事件 _id 就是可用于恢复位置的 resume token。
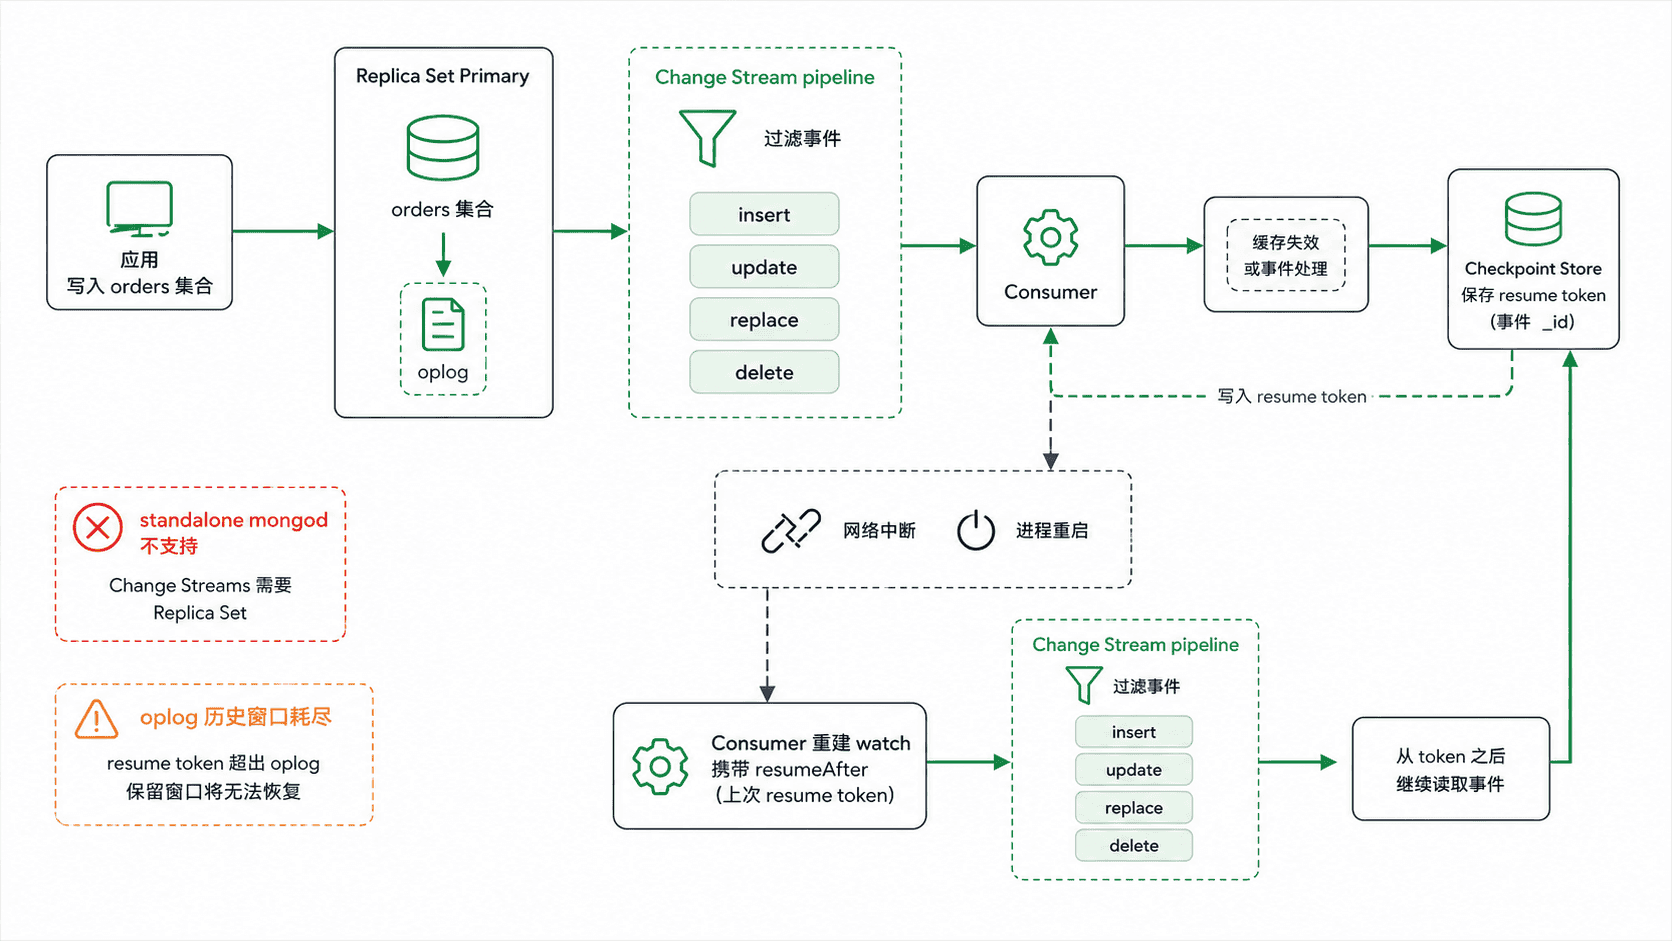
这里最重要的边界是:Change Stream 不是业务消息队列,也不自动提供“恰好一次”业务处理。它提供可恢复的变更位置;应用仍要决定何时提交检查点,以及如何让下游副作用具备幂等性。
建立带过滤和检查点的消费循环
下面示例假设项目已安装 Node.js MongoDB 驱动,并连接到名为 rs0 的复制集。检查点直接保存到 MongoDB 的另一个集合,resume token 以 BSON 原值写入,避免自行序列化时破坏类型。
import { MongoClient } from "mongodb";

const uri =
  process.env.MONGODB_URI ??
  "mongodb://localhost:27017/?replicaSet=rs0";

const client = new MongoClient(uri);
const checkpointId = "orders-cache-invalidator";

async function invalidateCache(change) {
  // 示例副作用:生产环境可替换为删除缓存、发布事件等幂等操作。
  console.log(
    `event=${change.operationType} key=${JSON.stringify(change.documentKey)}`
  );
}

async function run() {
  await client.connect();

  const db = client.db("shop");
  const orders = db.collection("orders");
  const checkpoints = db.collection("change_stream_checkpoints");

  const saved = await checkpoints.findOne({ _id: checkpointId });
  let resumeToken = saved?.token;

  const pipeline = [
    {
      $match: {
        operationType: { $in: ["insert", "update", "replace", "delete"] }
      }
    }
  ];

  while (true) {
    const stream = orders.watch(pipeline, {
      fullDocument: "updateLookup",
      ...(resumeToken ? { resumeAfter: resumeToken } : {})
    });

    try {
      for await (const change of stream) {
        await invalidateCache(change);

        // 先完成副作用,再保存 token;崩溃时最多重放,不会静默跳过事件。
        await checkpoints.updateOne(
          { _id: checkpointId },
          { $set: { token: change._id, updatedAt: new Date() } },
          { upsert: true }
        );
        resumeToken = change._id;
      }
    } catch (error) {
      if (error?.code === 286) {
        throw new Error(
          "Change stream history lost; rebuild state from a fresh snapshot",
          { cause: error }
        );
      }

      console.error(`change stream interrupted: ${error.message}`);
      await new Promise((resolve) => setTimeout(resolve, 1000));
    } finally {
      await stream.close().catch(() => {});
    }
  }
}

run().catch(async (error) => {
  console.error(error);
  await client.close();
  process.exit(1);
});
预期结果:
进程保持运行并等待 orders 集合的匹配变更;没有新事件时不会输出事件行。在另一个 mongosh 会话写入测试数据:
use shop
db.orders.insertOne({ _id: "o-1001", status: "CREATED", total: 199 })
预期输出:
{ acknowledged: true, insertedId: 'o-1001' }订阅进程会输出:
event=insert key={"_id":"o-1001"}实际主机、端口、事件时间和 token 内容会随环境变化。检查点集合中随后会出现 _id: "orders-cache-invalidator" 与对应 token。
正确选择恢复位置
resumeAfter 表示从某个已处理事件之后继续,是最常用的重启方式。生产代码应把最近一次“业务副作用成功后”的事件 _id 持久化,再在新建 Change Stream 时传回。
如果流已经收到 invalidate 事件并需要在其后重新建立流,应使用 startAfter 而不是普通的 resumeAfter。只有在没有 token、但知道一个有效操作时间点时,才考虑 startAtOperationTime;它不是 token 的等价替代。
resume token 只能在对应的 oplog 历史仍可访问时恢复。消费者停机时间超过 oplog 保留窗口,就可能遇到 ChangeStreamHistoryLost。此时不要无限重试旧 token,而应从权威数据源重新构建缓存或投影,再建立新的变更流。
过滤、完整文档与重复消费
过滤应尽量放进 watch() 的 pipeline,让服务器只向消费者传回需要的事件。例如缓存只受订单写入影响时,没有必要把无关操作送到应用层再判断。
fullDocument: "updateLookup" 会在更新事件发生后额外读取文档当前值,适合需要完整对象的消费者,但会增加读取成本,而且得到的是查找时的当前文档,不应被当作精确的历史快照。
检查点放在副作用之后可以避免“token 已前移但业务动作尚未完成”造成漏处理,但进程仍可能在副作用完成、检查点写入之前崩溃,于是恢复后再次看到同一事件。因此缓存删除通常天然安全;发送通知、扣减额度等操作则应以事件 token 或业务主键建立幂等记录。Change Streams 负责可靠恢复位置,业务端负责把重放变成可接受的重复,而不是数据错误。