
NoSQL 与搜索 / 系统课时
排查排序与聚合内存压力
排查排序与聚合内存压力
MongoDB 查询出现高延迟、临时磁盘暴涨或内存限制错误时,常见根因是没有索引支持的阻塞排序,或 $group 等阶段积累了过大的工作集。本课从执行阶段定位压力,并用索引、管道缩减和 allowDiskUse 的正确边界逐层修复。
学习目标
- 识别
$sort、$group等阻塞阶段为什么会产生显著内存压力 - 判断
allowDiskUse是安全阀还是性能优化,并识别磁盘 spill - 通过复合索引和管道顺序减少参与排序、分组的数据量
先确认压力来自哪个阶段
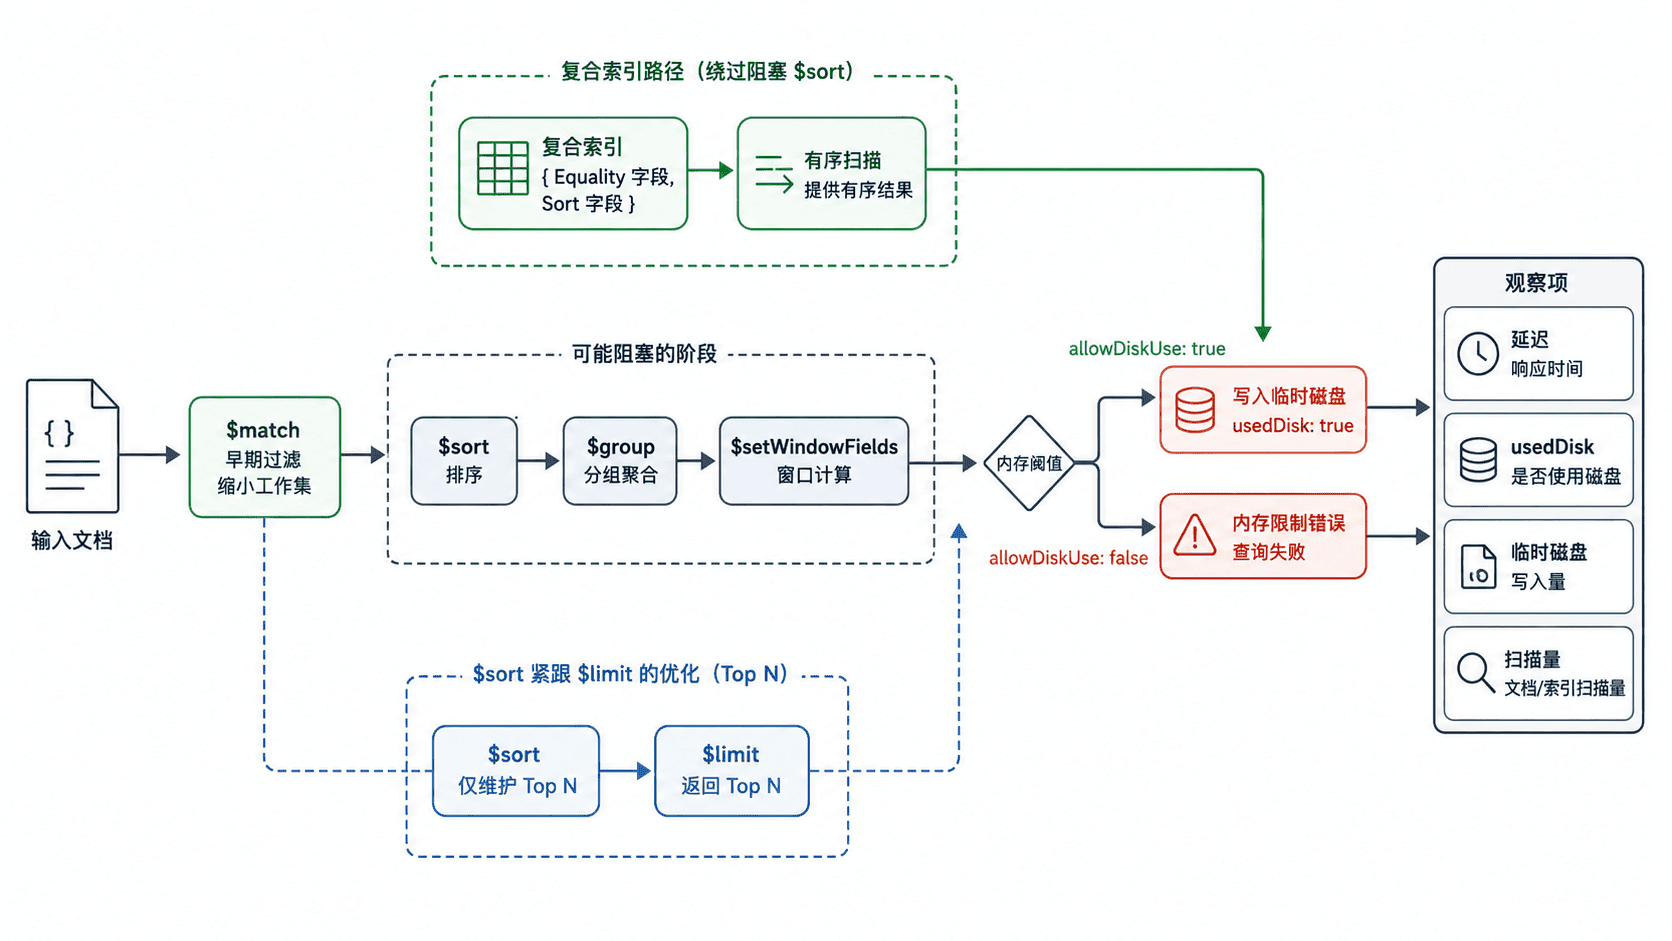
当排序无法利用索引时,MongoDB 必须维护额外的排序工作集;$group、$bucket、$setWindowFields 等阶段也可能在输出前保存大量状态。MongoDB 6.0 之后,超过 100 MB 内存限制的相关阶段是否写临时文件,受 allowDiskUseByDefault 和单次命令的 allowDiskUse 覆盖值共同控制。
如果允许落盘,查询可能从“内存限制错误”变成大量临时 I/O;如果禁止落盘,超过限制的阶段会直接报错。Profiler 与诊断日志中的 usedDisk 可以帮助确认执行过程中是否发生了 spill。
用复合索引消掉阻塞排序
最有效的修复通常不是增加内存,而是让索引同时服务过滤与排序。对“租户内查询已完成订单,并按时间倒序取最近几条”的模式,可以把等值过滤字段放在前面,再接排序字段,使索引天然输出需要的顺序。
下面的示例创建 { tenantId: 1, status: 1, createdAt: -1 },然后执行 $match、$sort、$limit。数据规模很小,但查询形状与生产中的“等值过滤 + 排序 + Top N”一致。
const app = db.getSiblingDB("shop");

app.sales.drop();
app.sales.insertMany([
  { _id: 1, tenantId: "t1", status: "PAID", createdAt: ISODate("2026-08-20T10:00:00Z"), total: 40 },
  { _id: 2, tenantId: "t1", status: "PAID", createdAt: ISODate("2026-08-22T10:00:00Z"), total: 80 },
  { _id: 3, tenantId: "t1", status: "CANCELLED", createdAt: ISODate("2026-08-23T10:00:00Z"), total: 20 },
  { _id: 4, tenantId: "t1", status: "PAID", createdAt: ISODate("2026-08-21T10:00:00Z"), total: 60 },
  { _id: 5, tenantId: "t1", status: "PAID", createdAt: ISODate("2026-08-24T10:00:00Z"), total: 100 }
]);

app.sales.createIndex(
  { tenantId: 1, status: 1, createdAt: -1 },
  { name: "tenant_status_created" }
);

const rows = app.sales.aggregate([
  { $match: { tenantId: "t1", status: "PAID" } },
  { $sort: { createdAt: -1 } },
  { $limit: 3 },
  { $project: { _id: 1, createdAt: 1, total: 1 } }
]).toArray();

printjson(rows);
预期输出
[
  { _id: 5, createdAt: ISODate('2026-08-24T10:00:00.000Z'), total: 100 },
  { _id: 2, createdAt: ISODate('2026-08-22T10:00:00.000Z'), total: 80 },
  { _id: 4, createdAt: ISODate('2026-08-21T10:00:00.000Z'), total: 60 }
]
生产排查时再对真实查询运行 explain("executionStats"):如果计划中仍出现阻塞 SORT,说明当前索引没有为该排序提供顺序,或前置阶段已经破坏了可利用索引的条件。不要只看“有 IXSCAN”,因为查询可能先走索引过滤,随后仍在内存中排序。
让更少的数据进入阻塞阶段
管道越早减小工作集,后续阶段越轻。可利用索引的 $match 应尽量靠前;只需要 Top N 时,让 $sort 后尽快出现 $limit。没有改变文档数量的中间阶段存在时,优化器可以把 $limit 合并进 $sort,使排序过程只维护前 N 个候选结果。
| 症状 | 优先调整 | 原因 |
|---|---|---|
$sort 扫描大量文档 |
建立匹配过滤与排序顺序的复合索引 | 直接按索引顺序读取,避免阻塞排序 |
$sort 后只取少量结果 |
尽早保留 $limit |
可触发 Top N 型排序优化,降低工作集 |
$group 输入过大 |
提前 $match,减少不必要的 $unwind |
先减少进入分组的文档和状态数量 |
如果 $group 的业务只是按某字段排序后取每组第一条或最后一条,还应检查是否能通过匹配排序顺序的索引与 $first、$last 模式减少分组成本。相反,先大规模 $unwind 再过滤,往往会把本可控的数据量放大后才交给阻塞阶段。
正确使用 allowDiskUse
allowDiskUse: true 适合做容量安全阀:当短时峰值无法完全避免时,允许查询使用临时磁盘,比直接因内存限制失败更可控。但它会把压力转移到存储 I/O 和临时空间,多个重型聚合并发 spill 时仍可能拖慢整个实例。
allowDiskUse: false 则适合压测或治理阶段,用来尽早暴露本应被索引或管道结构消除的高内存操作。无论默认值如何,生产判断都应同时看执行延迟、扫描文档数、usedDisk、磁盘利用率与并发数量,不能只以“查询最终成功”为验收条件。
排查顺序应保持稳定:先定位具体阻塞阶段,再减少输入数据,随后让索引提供排序顺序,最后才决定是否允许临时落盘。这样修复的是工作量本身,而不是把内存瓶颈迁移成磁盘瓶颈。