
NoSQL 与搜索 / 系统课时
执行滚动维护与故障演练
执行滚动维护与故障演练
滚动维护的目标不是“把节点逐台重启完”,而是在保持副本集多数派可用的前提下,验证选主、节点恢复、参数变更和驱动重试是否符合业务容忍度。本课用三节点副本集完成一套可重复演练,并把成功标准落到状态、延迟与错误率上。
学习目标
- 按 Secondary 优先、Primary 最后的顺序执行滚动维护
- 使用
rs.stepDown()和单节点停机验证选主与恢复链路 - 观察驱动重试、写入中断时间和节点追平状态,形成可验收的演练记录
先定义维护成功标准
开始前先确认三件事:副本集至少有一个健康且可选举的 Secondary;业务连接串包含完整副本集成员并指定 replicaSet;监控能够看到 Primary 变化、复制延迟、请求错误率和 P95/P99 延迟。生产环境还应确认备份与回滚方案可用。
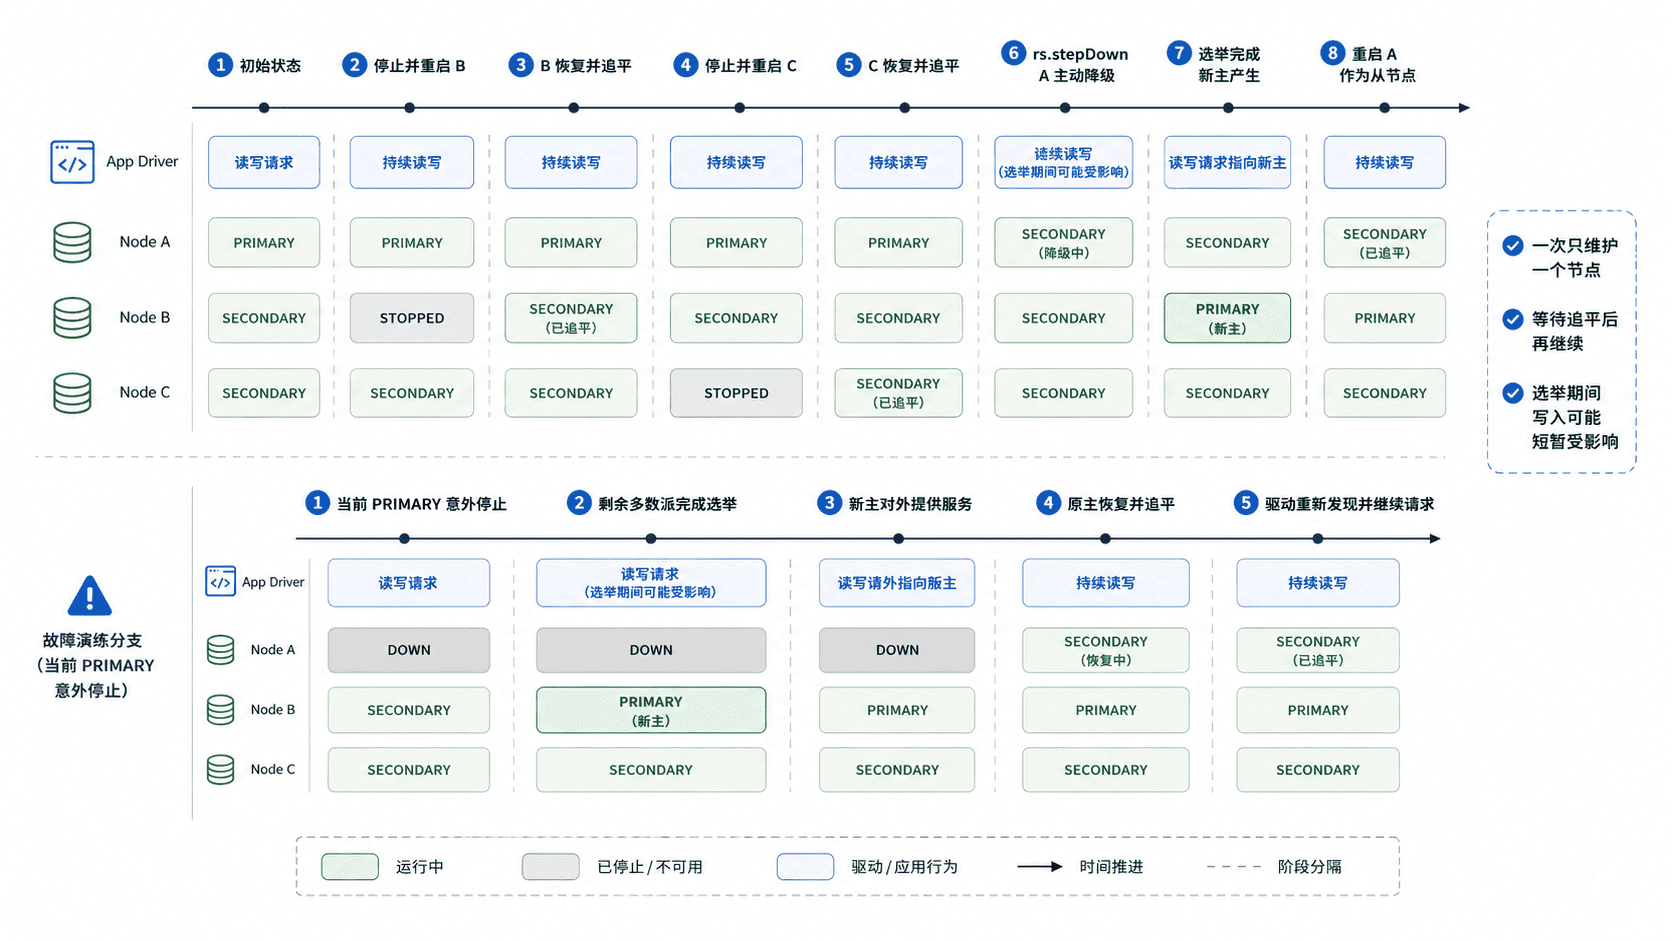
滚动操作必须一次只处理一个成员。先维护一个 Secondary,等它重新进入 SECONDARY 且复制追平,再处理下一个成员;最后主动让 Primary step down,再维护已经退位的旧 Primary。这样可以避免把多数派同时带离线。
主动切换 Primary
先连接当前 Primary,确认成员状态,再让它在一段时间内主动退位。rs.stepDown(60, 10) 表示退位 60 秒,并最多等待 10 秒让可选举 Secondary 追上;如果没有足够新且可选举的 Secondary,命令会失败,而不是强行制造不安全切换。
mongosh "$MONGODB_URI" --quiet --eval 'rs.stepDown(60, 10)'
sleep 2
mongosh "$MONGODB_URI" --quiet --eval 'print(db.hello().primary)'预期结果:MONGODB_URI 应包含副本集名称与多个成员地址。成功后第二条命令打印新的 Primary;主机名与端口按环境变化。
<HOST_B>:<PORT>不要把 force 当作常规演练手段。计划内切换的价值在于验证“存在可接班节点时能否平滑完成选主”,而不是绕过追平条件。
逐台重启并验证恢复
对 Secondary 做配置或版本维护时,一次只重启一个节点。下面以使用 systemd 的自管 Linux 节点为例;其他服务管理器使用等价的停止、启动和状态检查命令。
sudo systemctl stop mongod
sudo systemctl start mongod
sudo systemctl is-active mongod
预期输出:
active进程恢复不等于副本集已经恢复。重新连接该节点或任一健康成员,确认被维护节点回到 SECONDARY,并检查 optimeDate 与当前 Primary 的差距已经回到日常基线后,才能继续下一台。
对于需要重启才能生效的配置,应先在一个 Secondary 上变更并验证。例如实验环境可以临时提高全局日志详细度,观察配置经滚动重启是否一致;生产环境不要为了演练随意提高日志量。
systemLog:
  verbosity: 1
该片段是配置示例,不单独执行。重启后读取进程解析后的启动配置,确认目标值已经生效,并在验证结束后按变更计划恢复目标值。
注入单节点故障并观察驱动
计划内 stepDown 验证的是受控切换;还应在预生产环境测试“节点直接消失”。停止一个 Secondary 时,业务通常不应失去写入能力,但副本集容错余量会下降。停止当前 Primary 时,写入需要等待新 Primary 选出,期间可能出现延迟尖峰或可重试错误。
使用官方驱动时,应通过副本集 URI 连接,并明确保留可重试写入。下面的 Node.js 脚本持续执行单文档更新,便于在故障注入前后观察延迟和异常。
import { MongoClient } from "mongodb";

const uri = process.env.MONGODB_URI;
if (!uri) throw new Error("MONGODB_URI is required");

const client = new MongoClient(uri, {
  retryWrites: true,
  serverSelectionTimeoutMS: 10000
});

await client.connect();
const counters = client.db("ops_lab").collection("counters");

for (let i = 1; i <= 20; i += 1) {
  const started = Date.now();
  try {
    await counters.updateOne(
      { _id: "rolling-test" },
      { $inc: { value: 1 } },
      { upsert: true }
    );
    console.log(`ok seq=${i} latencyMs=${Date.now() - started}`);
  } catch (error) {
    console.log(`error seq=${i} name=${error.name}`);
  }
  await new Promise(resolve => setTimeout(resolve, 1000));
}

await client.close();
预期输出不应按固定毫秒数验收。正常切换可能只表现为一两次延迟升高;若选主超过驱动等待窗口,也可能看到一次错误。动态值以实际环境为准。
ok seq=1 latencyMs=<VALUE>
ok seq=2 latencyMs=<VALUE>
ok seq=3 latencyMs=<VALUE>
...用业务指标而不是节点状态验收
演练结束后同时检查数据库和应用两层。数据库侧确认恰好一个 PRIMARY、其余数据节点处于 SECONDARY、复制延迟恢复基线;应用侧对比演练前后的成功率、P95/P99、超时数和重试数,并确认没有重复业务副作用。
如果节点都恢复了,但业务在每次选主时仍出现大量超时,问题通常不在“副本集会不会选主”,而在驱动连接参数、超时预算、不可重试操作或业务幂等设计。滚动维护真正完成的标志,是下一次故障发生时影响范围已经被量化,而且恢复路径经过验证。