
NoSQL 与搜索 / 系统课时
设计多对多关系
设计多对多关系
多对多关系真正难的不是“能不能存 ID”,而是两侧都要查询、关系本身可能带状态、更新时还要避免重复与失配。本节以用户加入团队为例,比较双向引用、关系文档和反规范化快照,并落地一套可索引、可维护的结构。
学习目标
- 根据查询方向和关系基数选择双向引用或独立关系文档
- 为关系文档设计唯一约束与双向查询索引
- 区分关系事实与只为读性能保留的反规范化快照
先从访问模式决定关系放在哪里
假设一个用户可以加入多个团队,一个团队也有多个用户。常见读取有两类:查看“某用户加入了哪些团队”,以及查看“某团队有哪些成员”。如果成员关系还带 role、joinedAt、邀请状态等字段,那么关系已经不只是两个 ID 的连接,而是有自己生命周期的数据。
双向引用会在 users.groupIds 与 groups.userIds 两边都保存 ID。它的优势是两侧读取直接,但一次加入或退出需要同时修改两个文档;如果业务要求强一致,就必须把两次写入放进事务或设计补偿机制。数组若会持续增长,还会把父文档拖向无界增长。
独立关系文档则把每条成员关系保存到 memberships。用户和团队仍各自独立,关系状态只维护一份;代价是读取展示字段时可能需要第二次查询或 $lookup。
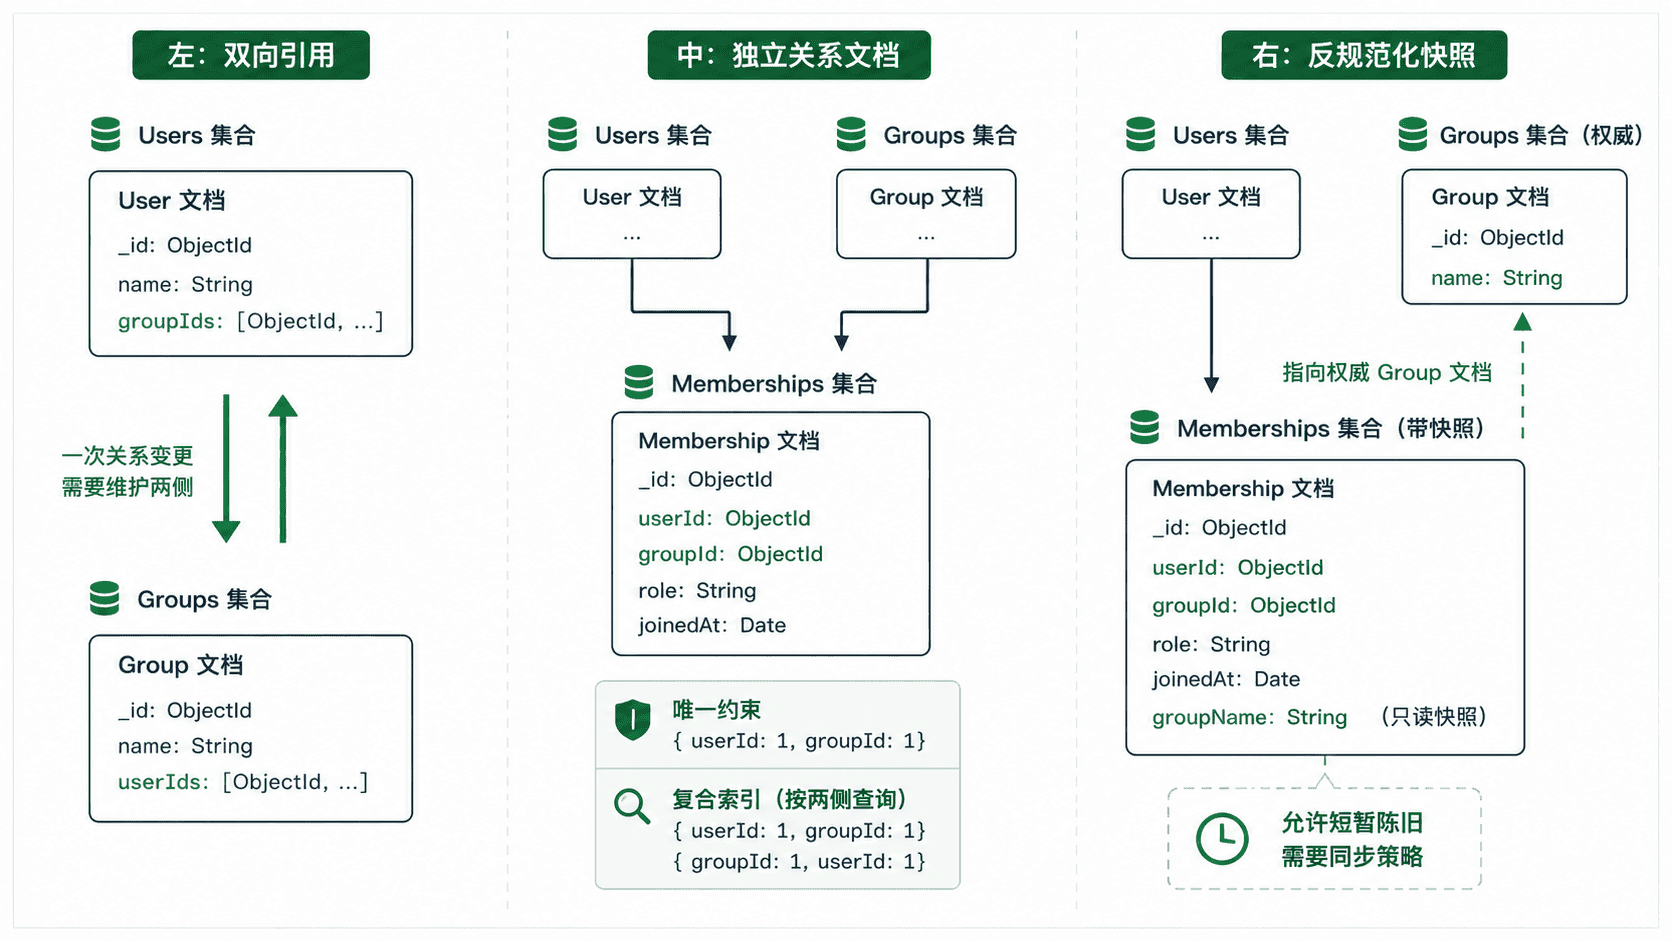
用关系文档承载可变边属性
当关系有属性、两侧基数可能很大,或加入退出很频繁时,优先让关系成为独立文档。下面的 memberships 既保存边属性,也用复合唯一索引阻止同一用户重复加入同一团队。
db.users.drop();
db.groups.drop();
db.memberships.drop();

db.users.insertMany([
  { _id: "u1", name: "Lin" },
  { _id: "u2", name: "Mina" }
]);

db.groups.insertMany([
  { _id: "g1", name: "Editors" },
  { _id: "g2", name: "Reviewers" }
]);

db.memberships.insertMany([
  { userId: "u1", groupId: "g1", role: "owner", joinedAt: ISODate("2026-08-01T00:00:00Z") },
  { userId: "u1", groupId: "g2", role: "member", joinedAt: ISODate("2026-08-02T00:00:00Z") },
  { userId: "u2", groupId: "g1", role: "member", joinedAt: ISODate("2026-08-03T00:00:00Z") }
]);

// 唯一索引同时服务“按用户查团队”,反向索引服务“按团队查成员”。
db.memberships.createIndex({ userId: 1, groupId: 1 }, { unique: true });
db.memberships.createIndex({ groupId: 1, userId: 1 });

db.memberships.aggregate([
  { $match: { userId: "u1" } },
  { $lookup: { from: "groups", localField: "groupId", foreignField: "_id", as: "group" } },
  { $unwind: "$group" },
  { $project: { _id: 0, groupId: 1, groupName: "$group.name", role: 1 } },
  { $sort: { groupId: 1 } }
]);
预期输出
{ groupId: 'g1', role: 'owner', groupName: 'Editors' }
{ groupId: 'g2', role: 'member', groupName: 'Reviewers' }
前面的写入和建索引命令还会返回确认对象与索引名;这里列出最后一条聚合的稳定结果。若再次插入相同的 userId 与 groupId,唯一索引会拒绝重复关系。
让索引跟着查询方向走
{ userId: 1, groupId: 1 } 的前缀可以支持按用户查全部关系,也能快速定位某一对用户与团队;但它不能高效覆盖“只按 groupId 查成员”的方向,所以需要 { groupId: 1, userId: 1 }。如果列表还按 joinedAt 排序,应把排序字段纳入对应方向的索引,而不是盲目再建多个单字段索引。
关系文档还有一个维护优势:修改 role 只改一条关系记录,不必在用户和团队两端寻找并同步同一个嵌入对象。删除用户或团队时,则要明确级联策略,例如由应用删除相关 memberships,或者通过后台任务清理孤儿关系。
反规范化只复制读热点
如果列表几乎每次都需要团队名称,可以在 memberships 中额外保存 groupName 快照,减少 $lookup。但 groupId 仍应是关系事实,groups.name 仍是名称的权威来源;团队改名后,快照允许短暂陈旧时可异步回填,不能接受陈旧则应同步更新或直接查询权威集合。
选择标准可以归结为一句话:关系事实只保留一个权威位置,读取热点才做有边界的复制。双向引用适合规模小且数组有明确上限的关系;独立关系文档适合复杂、高基数或带边属性的关系;反规范化字段用于减少高频读取成本,而不是制造第二份事实。