
NoSQL 与搜索 / 系统课时
从访问模式反推文档边界
从访问模式反推文档边界
MongoDB 建模的关键不是先问“有哪些实体”,而是先确认业务最常怎样读取和修改数据。本课用订单详情作为主示例,把高频读取、写入频率、结果形状和一致性要求转换成可执行的嵌入与引用决策。
学习目标
- 根据高频访问模式判断哪些数据应放进同一文档
- 用写入独立性和一致性要求区分嵌入与引用
- 识别数组无界增长、热点写入等会破坏文档边界的信号
先写访问模式,再画实体关系
假设订单详情页的高频请求是“按订单号读取状态、收货地址、商品行和总金额”。这些字段几乎总是一起返回,而且订单创建后,商品名称与成交价应保留当时快照;相反,客户资料和商品目录会独立变化,不应该为了修改头像或商品介绍而重写历史订单。
因此,文档边界应围绕一次业务聚合来确定:需要一起读取、一起保持一致、生命周期接近的数据,优先放在同一文档;独立增长、独立修改或被大量文档共享的数据,更适合通过标识符引用。
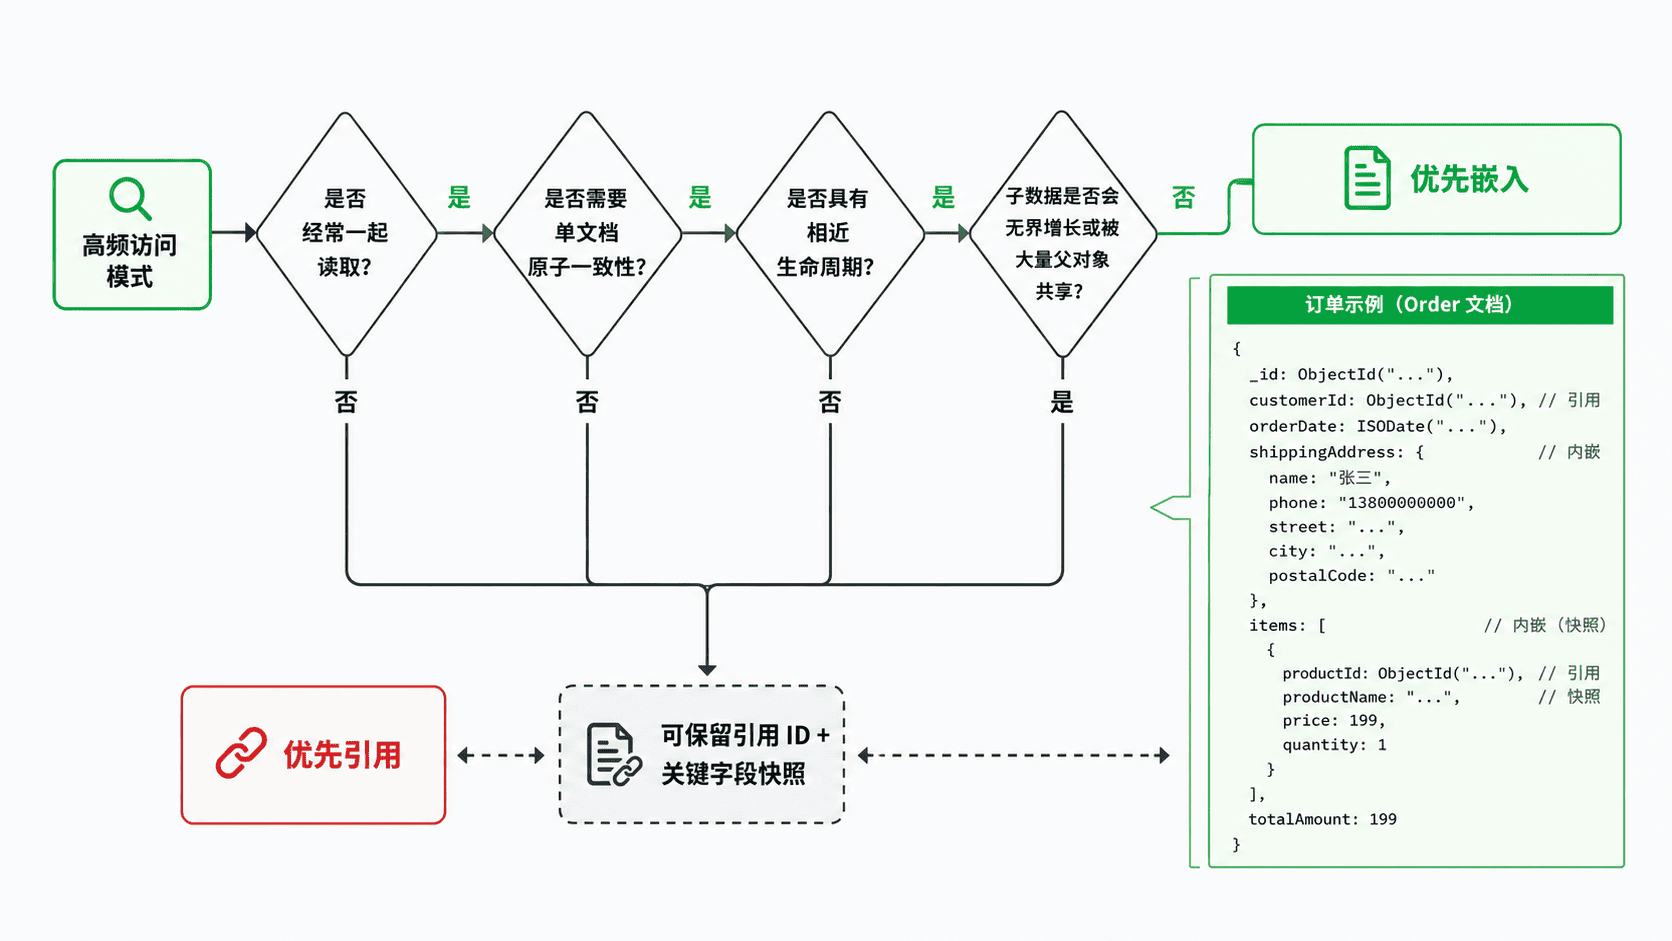
这张图不是在给出机械规则,而是在强调优先级:先从真实读写路径出发,再用一致性、生命周期和增长上限校正文档边界。实体关系只是输入之一,不能单独决定是否嵌入。
用订单详情落地边界
下面示例把收货地址和订单商品行直接嵌入订单,同时保留 customerId 与每个商品的 productId。nameSnapshot 与 unitPrice 是成交时快照,即使商品目录以后变化,历史订单仍能保持原始语义。
(() => {
  const orders = db.getSiblingDB("anystack_lab").orders_model_lab;

  orders.deleteMany({ orderNo: "O-1001" });
  orders.insertOne({
    orderNo: "O-1001",
    customerId: "C-10",
    status: "PAID",
    shippingAddress: {
      city: "Seattle",
      street: "1st Ave"
    },
    items: [
      {
        productId: "P-1",
        nameSnapshot: "Keyboard",
        unitPrice: 599,
        quantity: 1
      }
    ],
    totalAmount: 599
  });

  // 高频详情查询一次即可拿到页面需要的稳定结果形状。
  return orders.findOne(
    { orderNo: "O-1001" },
    {
      _id: 0,
      orderNo: 1,
      status: 1,
      shippingAddress: 1,
      items: 1,
      totalAmount: 1
    }
  );
})()
预期输出
{
  orderNo: 'O-1001',
  status: 'PAID',
  shippingAddress: { city: 'Seattle', street: '1st Ave' },
  items: [
    {
      productId: 'P-1',
      nameSnapshot: 'Keyboard',
      unitPrice: 599,
      quantity: 1
    }
  ],
  totalAmount: 599
}这个模型让订单详情只读一个文档,并且地址、商品行和金额可以在同一个文档更新中保持原子性。与此同时,customerId 和 productId 仍保留了与外部主数据的关联,需要最新客户或商品资料时再按引用查询。
用四个问题检查边界
判断一个字段或子结构是否应该嵌入,可以依次问四个问题:
- 这个数据是否经常与父对象一起读取,并且结果形状稳定?
- 它是否需要与父对象在一次写入中保持一致?
- 它的生命周期是否通常跟随父对象创建、归档或删除?
- 它是否会无限增长、被大量父对象共享,或被独立高频更新?
前三个问题多为“是”且第四个为“否”,通常适合嵌入。第四个问题一旦成为主要矛盾,就应认真考虑引用,或者采用“引用 ID + 必要快照”的混合方式。MongoDB 的单文档原子性很有价值,但不能用它换来一个持续膨胀、不断被局部改写的巨大文档。
识别边界已经失效的信号
如果嵌套数组会持续增长到不可预测规模,例如把用户全部行为日志永久塞进一个用户文档;或者某个子对象被成千上万个父文档共享,并且它自身更新频繁;又或者多个团队需要独立维护同一块数据,那么最初的嵌入边界很可能已经失效。
反过来,也不要因为“未来可能增长”就把所有关系都拆成引用。对订单地址、订单行快照这类有明确上限、几乎总随订单读取的数据,嵌入通常能减少查询次数并让一致性边界更自然。真正可靠的做法,是用线上高频查询、写入频率和文档增长情况持续校正文档边界,而不是照搬关系数据库的表拆分习惯。