
架构与系统设计 / 系统课时
对齐三套系统的核心概念
对齐三套系统的核心概念
同样是“订单事件发出去,库存和审计分别处理”,三套系统需要创建的对象并不相同。本篇用存储、路由、消费和分组四个维度建立对照,避免把同名术语直接替换,导致消息被错误分流或无法回看。
学习目标
- 按职责对应 RabbitMQ、Kafka 与 RocketMQ 的核心对象。
- 区分同一业务的实例分工与不同业务的独立订阅。
- 说明消费确认、消费进度和消息保留之间的区别。
先限定比较范围
这里比较 RabbitMQ 的 AMQP 0-9-1 普通队列模式、Kafka 的常规 KafkaConsumer 消费组,以及 RocketMQ 的 DefaultMQPushConsumer 集群消费模式。RabbitMQ 的普通队列包括 classic、quorum,不包含可重复读取日志的 Streams。([RabbitMQ][9])
Kafka 的 share group 是另一种消费模型;RocketMQ 不同客户端也可能采用不同的负载分配方式。下面关于“分区或队列分配”的结论,只针对上述范围,不能扩大到产品的全部能力。([Apache Kafka][10])
按职责映射,不按名称翻译
先问每个对象解决什么问题,再看它叫什么。下面的“对应”是比较角色,不表示 API、存储实现或可靠性语义完全等价。
| 比较维度 | RabbitMQ | Kafka | RocketMQ |
|---|---|---|---|
| 发布目标 | Exchange | Topic | Topic |
| 消息的可消费存储单位 | Queue | Partition | Message Queue |
| 路由或筛选依据 | Exchange 类型、Binding、Routing Key | Topic 与分区选择;内容通常在客户端筛选 | Topic 与订阅过滤,如 Tag |
| 消费入口 | 订阅投递,也可主动获取 | poll 拉取记录 |
SDK 拉取后调用监听器 |
| 独立消费边界 | 分别创建的 Queue | 不同的消费组 | 不同的 Consumer Group |
| 同一业务的实例分工 | 多消费者竞争同一 Queue | 在组内分配 Partition | 在组内分配 Message Queue |
RabbitMQ 的 Exchange 负责路由,待消费消息保存在 Queue;它不是 Kafka 那种由分区承载记录的 Topic。RocketMQ 的 Message Queue 在分片角色上更接近 Kafka Partition,而不是 RabbitMQ 的独立业务队列。([RabbitMQ][11])
RabbitMQ 普通队列没有一个需要填写的 Kafka 式 group.id;共同消费同一 Queue 就构成竞争消费关系。Kafka 的记录键通常参与分区选择,不等于 RabbitMQ 的 Routing Key,也不是 RocketMQ 的 Tag 过滤条件。([RabbitMQ][12])
用同一事件检查订阅是否独立
假设库存服务有两个实例,审计服务有一个实例;两个业务都必须处理订单确认事件。下面是固定的消息体示例,不是中间件配置,也不需要启动服务执行。
{
  "eventId": "evt-demo-1",
  "eventType": "OrderConfirmed",
  "orderId": "order-demo-1"
}预期结果:两个业务最终都能得到这份事件内容,库存的两个实例负责分工。eventType 只是我们定义的业务字段,不会因为出现在 JSON 中就自动创建路由、标签或消费组。
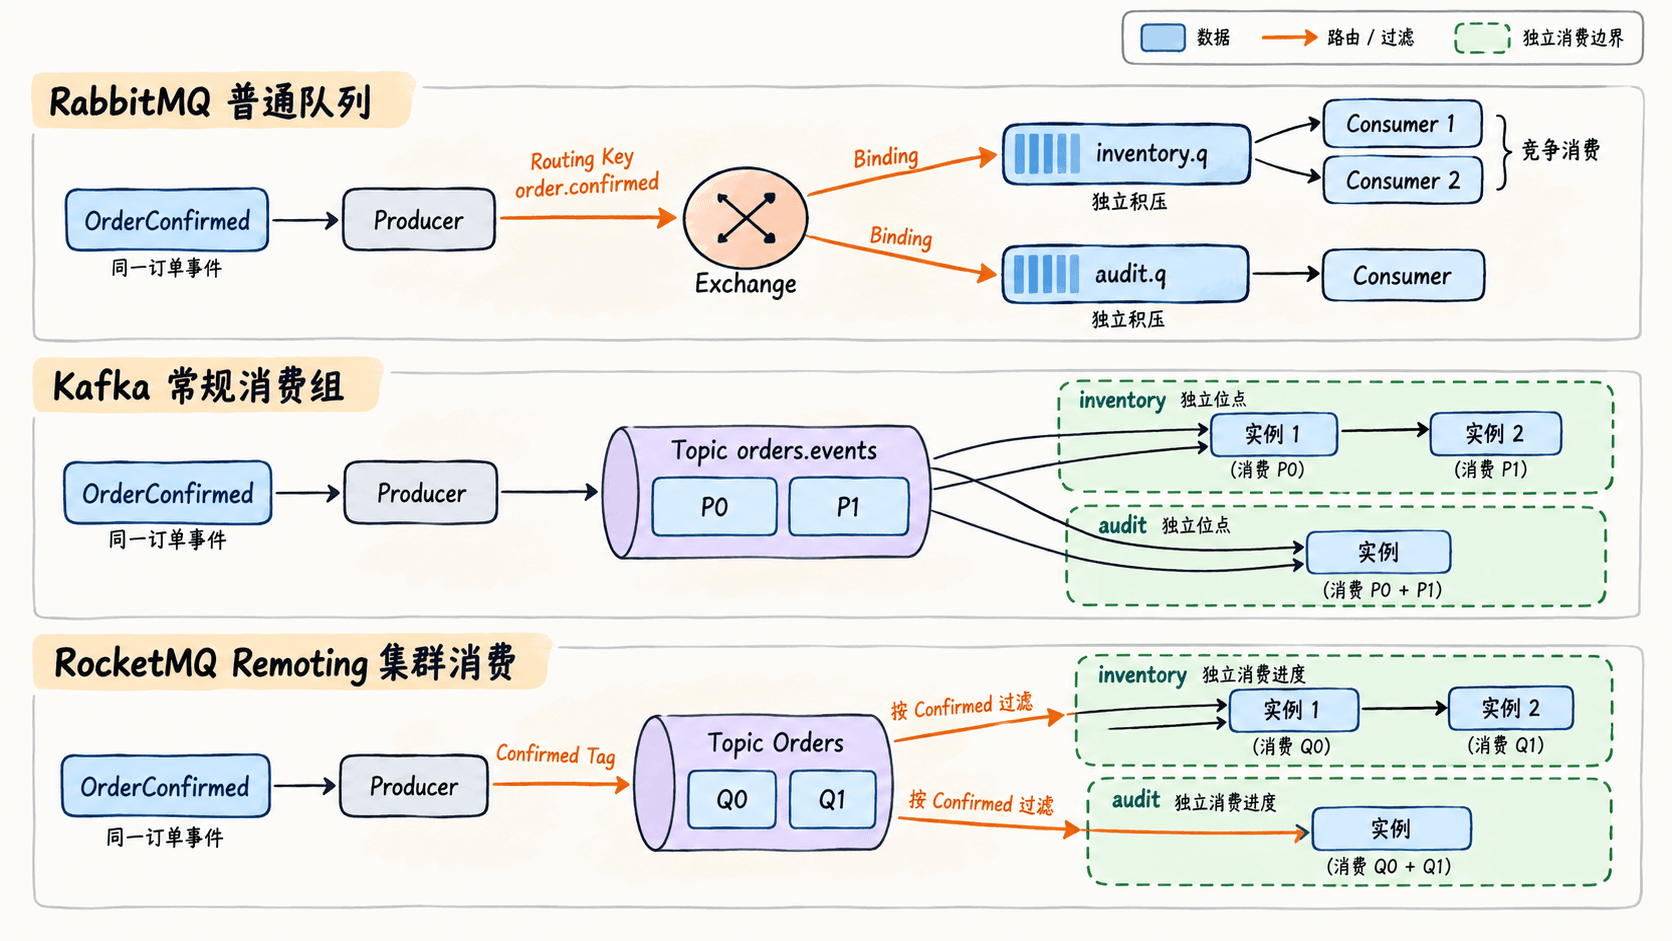
RabbitMQ 需要在发送前准备两条队列,并将它们绑定到同一 Exchange、匹配同一 Routing Key。库存实例共同消费库存队列,审计消费审计队列。改变消费者的名字,并不会让同一条队列自动变成两份独立订阅。([RabbitMQ][11])
Kafka 与 RocketMQ 可以让两个业务订阅同一 Topic,但使用不同消费组。库存的两个实例加入同一个库存组,审计使用独立审计组;RocketMQ 同组还必须保持一致的订阅与过滤规则。([Apache Kafka][13])
验证时看业务覆盖,而不是连接数量:库存和审计是否都处理了 evt-demo-1?把审计误接到库存队列或库存消费组,只增加了竞争者,没有建立独立的业务订阅。重试可能造成重复投递,不能把“组内分工”理解为恰好执行一次。([RabbitMQ][12])
消费确认不等于同一种删除
RabbitMQ 普通队列收到成功确认后,可以移除该队列中的对应消息;另一条队列中的消息不会因此被确认。Kafka 提交的是消费组在分区上的恢复位置,不是要求删除已读记录的命令。([RabbitMQ][12])
RocketMQ 的成功消费结果用于推进该组的消费进度,不会立即删除所有组共享的原始消息。历史记录能否再次读取,要看数据是否还在有效保留范围,以及消费起点或重置设置,不能仅看是否“消费成功”。([RocketMQ][6])
因此,“明天增加审计业务,并处理昨天的订单”并不是简单新增一个消费者:RabbitMQ 普通队列不能补收它建立并绑定之前的发布;Kafka 和 RocketMQ 则还需确保历史数据仍被保留,并正确选择起点。RabbitMQ Streams 的回放能力属于另一模型,不能据此混淆普通队列语义。([RabbitMQ][14])
比较最终要落在三个问题上:消息实际存在哪里,哪些实例共享消费进度,处理成功究竟改变什么。把这三个问题说清楚,才能把同一业务需求正确转换为三套系统中的对象关系。