
架构与系统设计 / 系统课时
消费延迟和积压怎么区 分
消费延迟和积压怎么区分
积压减少了,用户仍在等待,往往不是监控失效,而是几张图测量的对象不同。本篇把消息年龄、Kafka 位点差距与 RabbitMQ 队列深度拆开,用固定快照说明为什么队列看似清空,业务仍可能已经超时。
学习目标
- 用单位、时间起点和采集位置区分三种读数。
- 识别已投递未确认、提交滞后和热点分区造成的误判。
- 计算样本差距,并判断它是否足以证明业务正常。
先确认数值的单位和起点
不要只使用“消费延迟”这个含糊名称。面板应写清是在测量时间、位点还是消息条数;同一个数值配上不同单位,表达的是完全不同的问题。
| 读数 | 单位 | 本篇采用的口径 |
|---|---|---|
| 消息年龄 | 秒 | 当前观察时刻减原始业务事件时间 |
| 消费位点差距 | 位点跨度 | 指定末端减已提交位点或当前消费位置 |
| 队列深度 | 条 | 指定队列、指定状态的当前消息数量 |
本篇从原始业务事件时间计算年龄;若从 Broker 写入时刻计算,应另标“入队后年龄”。收到消息时的年龄不包含后续处理耗时,成功完成时的年龄才对应本例定义的端到端延迟。
数量反映工作规模,年龄反映已经过去多久。假设两个队列都积压 1000 条,一组刚刚产生,另一组已经等待十分钟;数量相同,不能据此判断它们具有相同的超时风险。
RabbitMQ 与 Kafka 各自数什么
RabbitMQ 普通队列采用手动确认时,messages_ready 是待投递数量,messages_unacknowledged 是已投递未确认数量,messages 为两者之和。只看待投递数量,会漏掉已经交给消费者但尚未确认的消息。([RabbitMQ][2])
Kafka 普通消费者组中,消费位置表示下一次返回记录的位置,已提交位点用于故障恢复。末端减这两种位置会得到不同差距,必须注明口径;提交位点是否代表业务完成,取决于应用何时提交。([Apache Kafka][6])
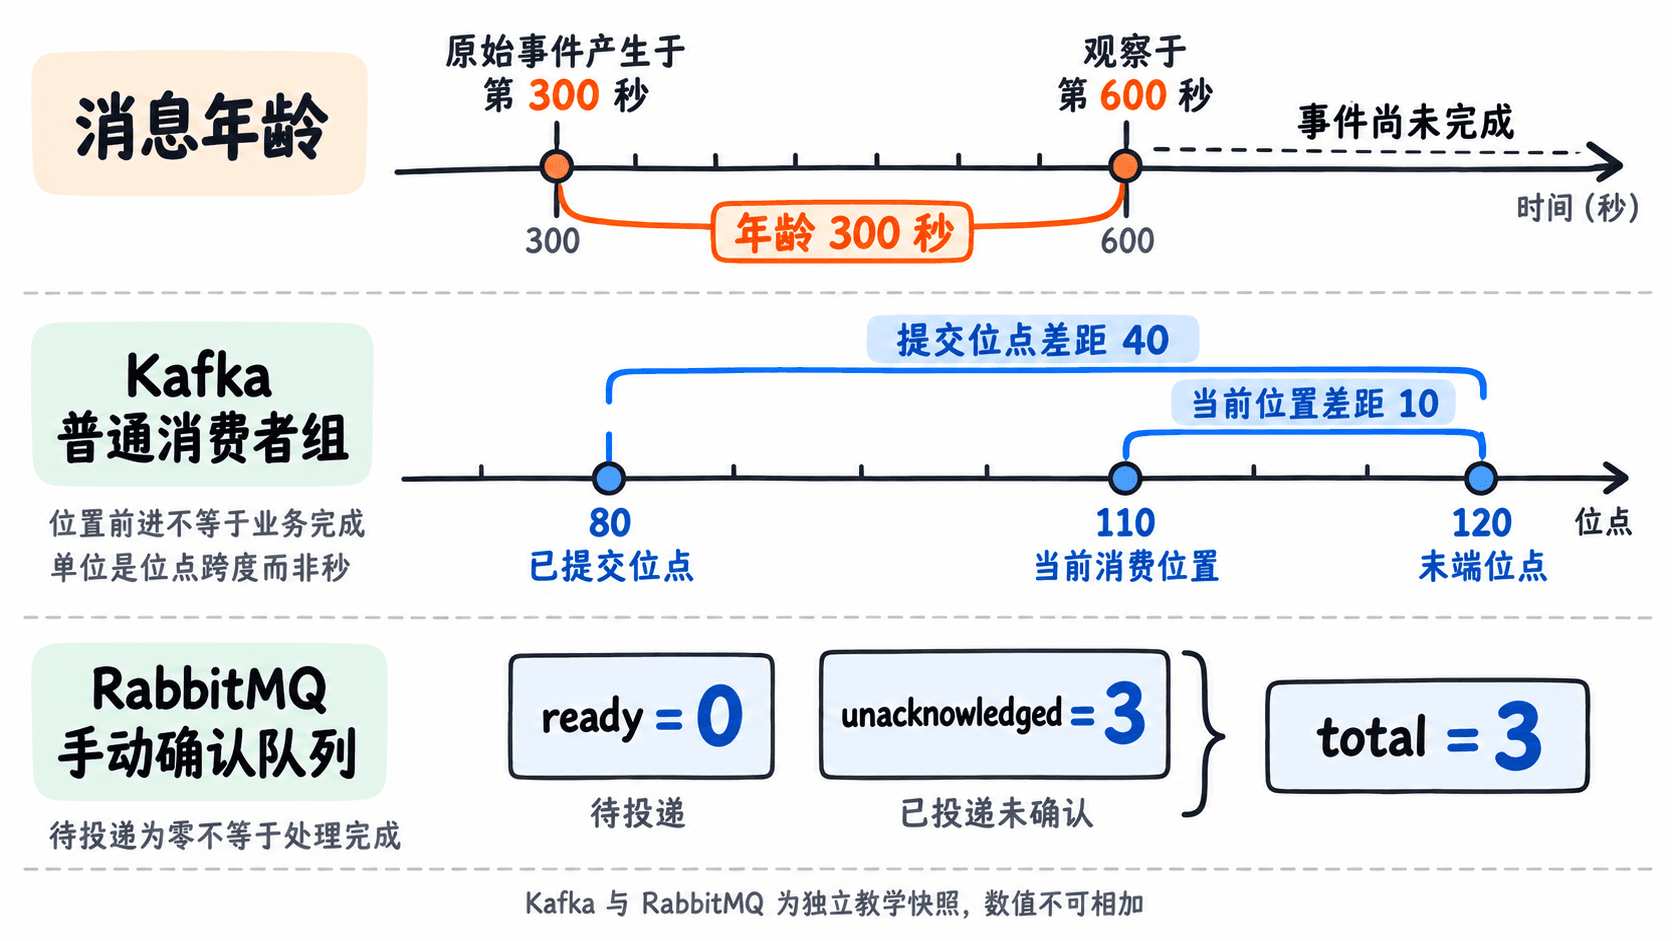
用固定快照重现零待投递但已超时
仅需 Python 3,将代码保存为 lag_snapshot.py,使用 python3 lag_snapshot.py 运行。时间是固定的相对秒数;Kafka 和 RabbitMQ 是独立样本,不能相加。
created_s 代表本例由业务侧完整追踪的三条未完成消息的原始时间,不是 RabbitMQ 默认导出的字段。真实系统只有已知覆盖全部未完成消息时,才能据此声称得到了全局最大年龄。
def main() -> None:
    # 固定相对时间,单位为秒;三条消息都尚未完成业务处理。
    now_s = 600
    created_s = [300, 595, 599]
    ready, unacknowledged = 0, len(created_s)
    ages = [now_s - timestamp for timestamp in created_s]
    if any(age < 0 for age in ages):
        raise ValueError("消息时间晚于观察时间,请检查时钟和单位")

    # Kafka 是独立快照:位点连续,无事务和压缩形成的空洞。
    end_offset, position, committed = 120, 110, 80
    if not 0 <= committed <= position <= end_offset:
        raise ValueError("教学快照位点不一致")

    print(f"RabbitMQ: ready={ready}, unacknowledged={unacknowledged}")
    print(f"RabbitMQ: total={ready + unacknowledged}")
    # 空集合代表本例已确认没有待处理消息,不代表采集失败。
    if ages:
        oldest_age = max(ages)
        print(f"最老未完成消息年龄={oldest_age} 秒")
        print(f"超过 60 秒业务期限={oldest_age > 60}")
    else:
        print("最老未完成消息年龄=不适用")
    print(f"Kafka: 提交位点差距={end_offset - committed}")
    print(f"Kafka: 当前消费位置差距={end_offset - position}")

if __name__ == "__main__":
    main()
预期输出:
RabbitMQ: ready=0, unacknowledged=3
RabbitMQ: total=3
最老未完成消息年龄=300 秒
超过 60 秒业务期限=True
Kafka: 提交位点差距=40
Kafka: 当前消费位置差距=10
RabbitMQ 样本的待投递量为零,但仍有三条消息未完成业务,最大年龄为 300 秒,超过本例的 60 秒期限。注意:真实系统的“未确认”也可能包含已经处理成功、确认尚未到达 Broker 的消息。([RabbitMQ][1])
Kafka 两种差距相差 30,仅表示已返回给应用、尚未体现在提交位点中的跨度,其中可能混有处理中与已成功未提交的记录。不能把 40 或 10 当成秒数,也不能直接把差值当成正在执行业务的条数。([Apache Kafka][6])
读数矛盾时先检查采集口径
Kafka 客户端的 records-lag-max 基于当前消费位置,而不是已提交位点,并记录窗口内的分区最大差距;它不是消费组提交位点差距的总和。查看总量之外,还应下钻各分区,判断是否只是局部热点。([Apache Kafka][7])
示例假定位点连续。压缩主题和事务控制记录可能造成位点空洞,跨度未必等于可消费记录条数;read_committed 的可读末端还受最后稳定位点限制。对比两张面板之前,要统一末端定义和采样时刻。([Apache Kafka][6])
只在收到或处理成功时采集年龄,会在消费停滞后失去新样本。应同时跟踪最后成功时间、在途任务年龄,必要时使用业务未完成记录或链路探针补充;没有新样本不能当作延迟为零。([Prometheus][5])
重试应保留原始事件时间,不能用重发时刻覆盖。若时间差为负,先检查时钟和时间单位;乱序时,刚收到的消息也未必最老,观测不到完整集合就应标明采样范围,而不是宣称全局无超时。
积压不能直接换算成消息年龄
假设未完成量为 600 条,每秒新增 8 条、成功完成 10 条,且速率稳定、统计范围一致,按净处理速度预计需要 300 秒清空;停止新增则约需 60 秒。这个估计回答“还要多久”,不是“已经等了多久”。
因此,告警名至少写清对象、单位和时间边界,例如“订单查询更新:最老未完成事件年龄超过 60 秒”,而不是只写“消费延迟过高”。