
架构与系统设计 / 系统课时
消息告警阈值怎么设才有效
消息告警阈值怎么设才有效
队列一涨就告警会制造噪声,只盯失败率又可能漏掉完全停止消费。本篇把业务期限、流量基线、统计窗口和持续时间组合成判断条件,并用可回放的规则测试验证短暂尖峰、持续故障和低流量三种情况。
学习目标
- 为积压、失败率和延迟选择不同的判断口径。
- 用流量门槛和持续时间降低误报,同时保留低流量保护。
- 编写并测试 Prometheus 告警规则,明确通知与处置边界。
先从业务期限反推告警预算
先问业务还能等待多久,再看正常波动有多大。历史基线应按消费组、时段和流量等级拆开观察,覆盖高峰、低谷与批处理。告警尽量针对业务受影响的症状,而不是每个底层指标一越线就叫醒人。([Prometheus][8])
以下是教学假设:库存投影必须在订单确认后 10 分钟内完成,平时只需数秒。如果最老未完成消息超过 2 分钟后再持续等待 2 分钟才告警,已经用掉约 4 分钟,还要扣除采集、评估、通知和修复时间。
阈值与持续时间必须一起审查。 不要把当前高峰简单乘一个系数就作为永久阈值;新消费者上线、流量结构变化或下游容量改变后,都应重新验证原来的时间预算。
不同信号负责发现不同风险
下表数值均为上述教学场景的起点,不是通用默认配置。普通性能劣化先发预警,接近业务期限或确定无法自动恢复时再升级。
| 信号 | 示例条件 | 必须保留的保护 |
|---|---|---|
| 积压压力 | 估算净清空时间超过 120 秒,持续 5 分钟 | 有积压但停止消费时另行判断 |
| 最老未完成年龄 | 超过 120 秒,持续 2 分钟 | 不加最低流量门槛 |
| 处理失败率 | 近 5 分钟超过 2%,尝试量至少 100,持续 5 分钟 | 另设最终失败或死信保护 |
| 完成延迟 P99 | 近 5 分钟超过 60 秒,完成量至少 1000,持续 5 分钟 | 与未完成年龄一起看 |
积压数量不能脱离吞吐理解。假设速率保持稳定,积压 12000 条、每秒完成 200 条、每秒新到 150 条,净清空时间约为 240 秒,而不是 60 秒。净处理能力不大于零时,不能继续用这个除法估算恢复时间。
这里把完成延迟定义为“原始事件创建到业务处理完成”,重试不重置起点。只统计已完成消息会漏掉一直卡住的消息,因此另行维护最老未完成年龄,覆盖排队和处理中状态;为空时报告零,而不是让序列消失。
把统计窗口和持续时间分开配置
rate(...[5m]) 使用滚动窗口估计速率;for: 5m 要求同一告警标签集合连续满足表达式。首次满足进入 pending,持续时间达到后才进入 firing,不是每隔五分钟触发一次,也不是固定等待十分钟。([Prometheus][9])
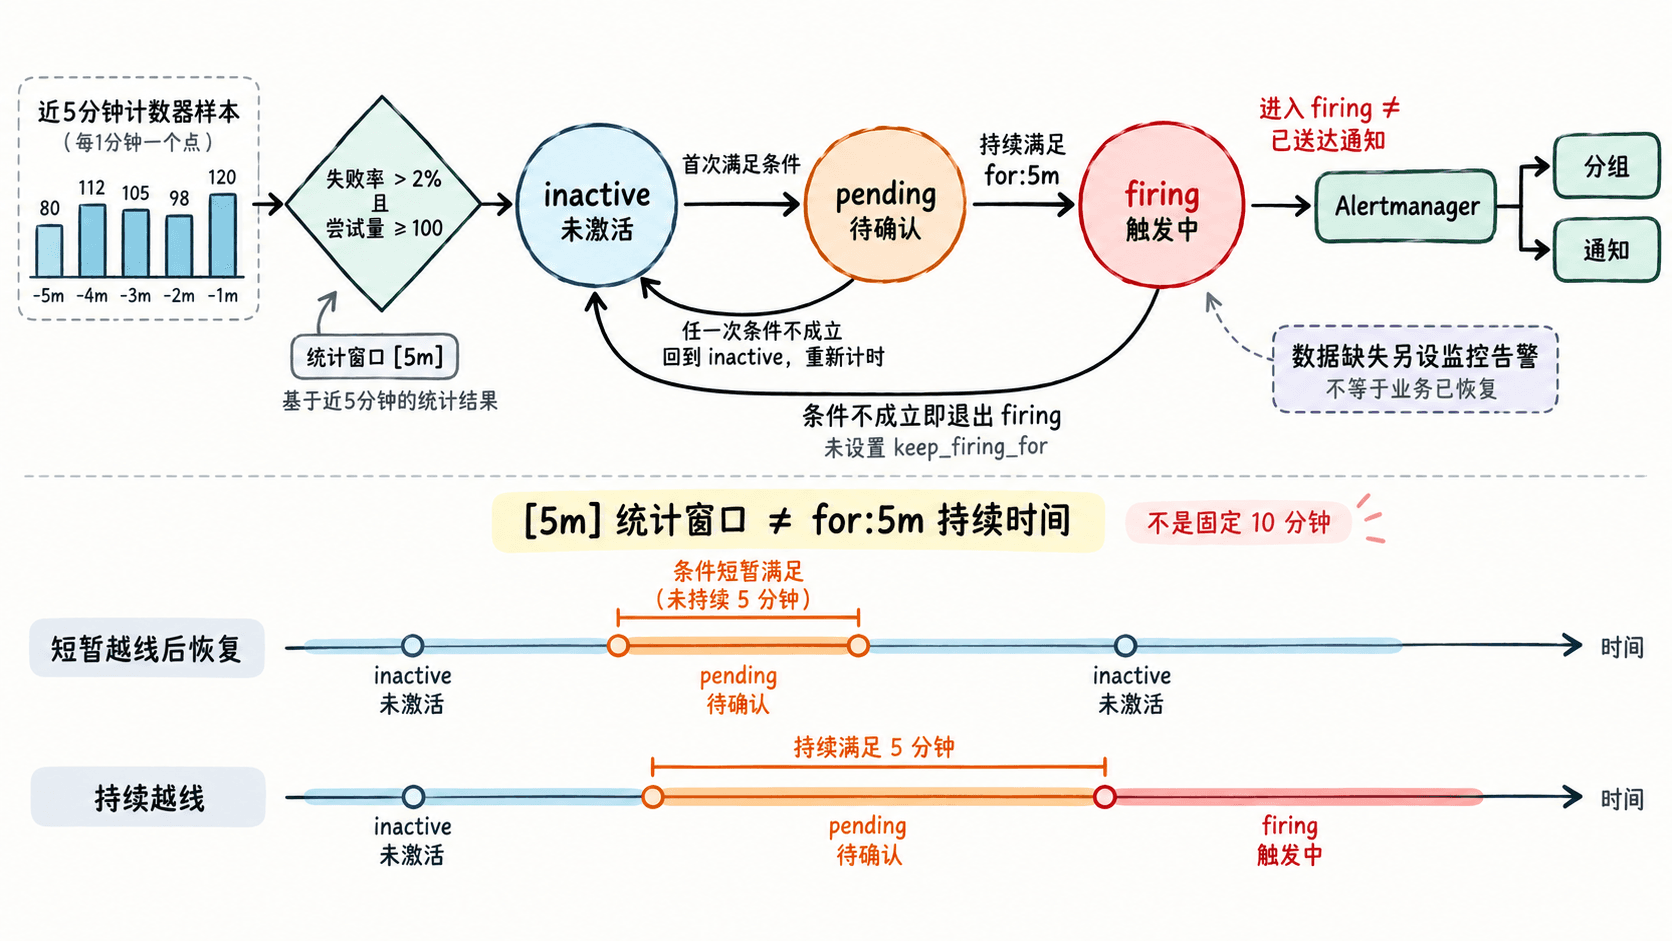
下面只完整实现失败率这一条规则。先准备与现有 Prometheus 配套的 promtool;本地规则测试不需要运行真实消费者。线上则必须已经采集应用自定义计数器 app_message_attempts_total,它不是中间件自带指标。
该计数器每结束一次处理尝试加一,outcome 只取 success 或 failure,两类序列都应初始化为零;同一消息重试会产生多次尝试。保留 cluster、topic、consumer_group 标签,避免把不同消费链路混算。
将下面完整规则保存为 message-alerts.yml:
groups:
  - name: message-observability
    interval: 1m
    rules:
      - alert: MessageFailureRateHigh
        # 先计算各实例的速率,再按同一消费链路聚合。
        expr: |
          (
            sum by (cluster, topic, consumer_group) (
              rate(app_message_attempts_total{outcome="failure"}[5m])
            )
            /
            sum by (cluster, topic, consumer_group) (
              rate(app_message_attempts_total[5m])
            )
          ) > 0.02
          and on (cluster, topic, consumer_group)
          (
            sum by (cluster, topic, consumer_group) (
              increase(app_message_attempts_total[5m])
            ) >= 100
          )
        # 连续满足全部条件才进入 firing。
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: 消息处理失败率持续偏高
预期结果:每分钟评估一次,只有失败率和最低尝试量同时满足并持续五分钟才触发。先对各实例执行 rate 再聚合,可处理各自的计数器重置;increase 有外推行为,最低量是监控估算,不是审计级精确计数。([Prometheus][9])
这里衡量的是尝试失败率,不是最终业务失败率。低流量条件被过滤并不代表业务正常。可对“有积压且完成速率连续一分钟为零”单独预警;最终失败按业务影响升级,不等尝试量凑满。
回放尖峰、持续故障和低流量
在同一目录保存 message-alerts.test.yml。0+96x10 表示从零开始,后续十个采样点各增加 96;本例每分钟采样一次。测试断言检查指定时刻已经进入 firing 的告警集合。([Prometheus][10])
rule_files:
  - message-alerts.yml
evaluation_interval: 1m
tests:
  - interval: 1m
    input_series:
      # steady:每分钟 100 次尝试,持续 4% 失败。
      - series: 'app_message_attempts_total{cluster="demo",topic="steady",consumer_group="inventory",outcome="success"}'
        values: '0+96x10'
      - series: 'app_message_attempts_total{cluster="demo",topic="steady",consumer_group="inventory",outcome="failure"}'
        values: '0+4x10'
      # brief:只有第一分钟新增 10 次失败,之后不再失败。
      - series: 'app_message_attempts_total{cluster="demo",topic="brief",consumer_group="inventory",outcome="success"}'
        values: '0+100x10'
      - series: 'app_message_attempts_total{cluster="demo",topic="brief",consumer_group="inventory",outcome="failure"}'
        values: '0 10 10 10 10 10 10 10 10 10 10'
      # low:失败比例高,但五分钟总尝试量不足 100。
      - series: 'app_message_attempts_total{cluster="demo",topic="low",consumer_group="inventory",outcome="success"}'
        values: '0+1x10'
      - series: 'app_message_attempts_total{cluster="demo",topic="low",consumer_group="inventory",outcome="failure"}'
        values: '0+1x10'
    alert_rule_test:
      - eval_time: 4m
        alertname: MessageFailureRateHigh
        exp_alerts: []
      - eval_time: 6m
        alertname: MessageFailureRateHigh
        exp_alerts:
          - exp_labels:
              cluster: demo
              topic: steady
              consumer_group: inventory
              severity: warning
            exp_annotations:
              summary: 消息处理失败率持续偏高
预期结果:第 4 分钟没有触发中的告警,第 6 分钟只有 steady 触发;brief 的短暂异常未持续足够久,low 未达到最低尝试量。测试中的分钟数是固定场景参数,不是实际运行时钟。
在这两个文件所在目录执行:
set -eu
# 校验失败时显示诊断,成功时输出固定验收标记。
report=$(promtool check rules message-alerts.yml 2>&1) || { printf '%s\n' "$report"; exit 1; }
report=$(promtool test rules message-alerts.test.yml 2>&1) || { printf '%s\n' "$report"; exit 1; }
printf '%s\n' 'alerts_validated'
预期输出如下;出现规则错误或断言不匹配时,命令会输出诊断并以非零状态结束。
alerts_validated这些测试验证表达式与持续时间,不验证通知送达。上线前还应补充计数器重置、采集缺失和故障恢复场景,并在隔离环境演练消费者停止时的保护告警。
让告警能送达,也能被处理
片段示例:将下面配置合并进已有 prometheus.yml,保留其他规则和采集配置。将规则文件一并部署到实例可访问的位置,核对相对路径,再通过现有发布流程重新加载;本地校验成功不代表线上已经加载。([Prometheus][11])
# 加入已有配置,保留其他规则文件和原有采集任务。
rule_files:
  - message-alerts.yml
预期结果:运行中的 Prometheus 加载该规则组,并按组内一分钟间隔评估。验证时检查实际加载的规则及其评估状态;模拟触发后,还要确认 Alertmanager 路由与真实接收端均收到通知。规则评估和通知分发属于不同环节。([Prometheus][12])
降噪应针对同一事故做分组、抑制和有到期时间的静默,而不是无限提高阈值。按消费链路聚合通知,在说明中写明负责人、当前影响及检查消费者和下游错误的入口;不要把不断变化的数值放进告警标签。([Prometheus][13])
另外用 up 及按预期消费组定义的序列缺失检查监控采集本身。业务表达式没有结果,可能只是没有数据,不能据此证明恢复。规则是否有效,最终看它能否在业务期限之前推动正确处置,而不只是每天少发了几条消息。([Prometheus][9])