
架构与系统设计 / 系统课时
Kafka 适合解决哪些问题
Kafka 适合解决哪些问题
同一批订单事件既要实时风控,也要送入分析系统,故障后还要补算,仅考虑“谁来执行任务”并不够。本篇用分区日志和两个消费者组,判断 Kafka 何时值得引入,以及它不能自动提供哪些保证。
学习目标
- 根据持续写入、多下游消费和历史重读需求判断 Kafka 的适配度。
- 解释分区、消费者组与消费位点对顺序和并行度的影响。
- 验证同一批事件可以被两个消费者组分别读取。
用可重读的事件流服务多个下游
假设订单系统提出三个要求:风控持续处理新事件,对账每天批量读取,分析规则修改后重算最近七天。这里需要保存一份可重复读取的业务事实,而不只是把某项任务分配给一个执行者。
Kafka 将事件追加到 Topic 的分区日志中。消费者读取后,记录不会因为“已经被读过”而立即删除;不同应用可以按各自进度读取仍保留的数据。日志采集、业务事件集成和实时流处理因此是值得评估的场景。([Apache Kafka][1])
分区决定顺序,消费者组决定分工
本文讨论普通消费者组。一个分区在同一组内同一时刻分配给一个消费者,一个消费者可以负责多个分区。若只订阅两个分区,组内增加到三个消费者,也不能让三个都获得分区;另一组仍可独立读取全部分区。([Apache Kafka][2])
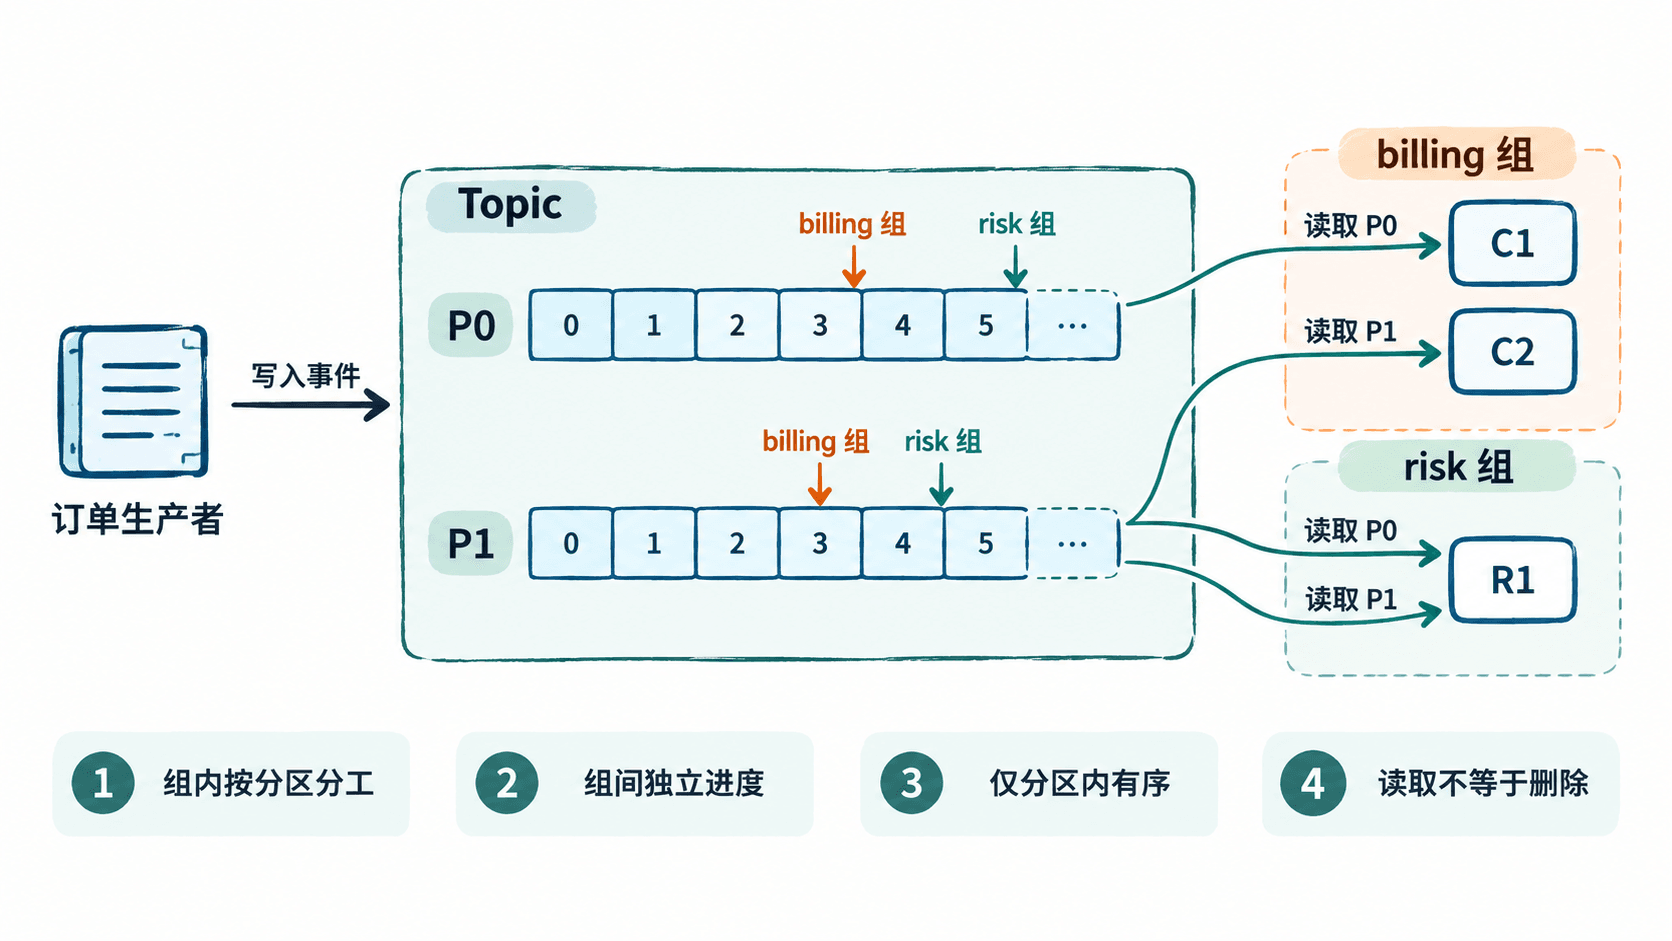
消费位点 offset 表示分区内的位置,提交值应指向下一条要处理的记录,用于恢复进度而不是删除记录。组间进度独立不代表资源完全隔离,它们仍可能竞争集群的磁盘和网络。([Apache Kafka][2])
需要订单内有序时,应采用稳定的按订单键分区规则,并保持相应处理顺序;跨分区没有统一总顺序。改变分区数可能改变键到分区的映射,扩容不能只改数量而忽略业务顺序。([Apache Kafka][1])
高吞吐来自顺序追加、批量传输和分区并行等机制,不是无条件的性能承诺。批量等待会影响延迟,热点键也可能使单个分区成为瓶颈;增加消费者未必解决这种问题。([Apache Kafka][3])
保留策略定义补算窗口
采用 cleanup.policy=delete 时,retention.ms 和 retention.bytes 决定旧日志段何时可被清理,容量上限按分区计算。清理不会等待所有消费者追上,也不是每条记录到期后立即精确删除。([Apache Kafka][4])
compact 则围绕消息键压缩旧值,不能拿它保证完整事件历史。要求回放七天时,应为停机和追赶留出余量,核算保留数据、副本与磁盘空间,并监控消费落后程度。([Apache Kafka][4])
用两个消费者组验证独立读取
准备 Linux、macOS 或 WSL 的 Bash,以及可拉取镜像的 Docker。实验固定使用 apache/kafka:4.1.2;容器名 eda-kafka-lab 必须未被占用。客户端全部在容器内执行,无需发布宿主机端口。([Apache Kafka][5])
将下面完整脚本保存为 kafka-lab.sh,执行 bash kafka-lab.sh。脚本创建一个分区,写入两条固定测试消息,再让两个全新组分别读取;结束时删除实验容器和临时数据。
set -euo pipefail
name=eda-kafka-lab

# 客户端也在容器内运行,不向宿主机发布端口。
docker run -d --name "$name" apache/kafka:4.1.2 >/dev/null
trap 'docker rm -fv "$name" >/dev/null 2>&1 || true' EXIT

# 以实际管理请求判断就绪,失败时输出日志供定位。
ready=false
for attempt in {1..30}; do
  if docker exec "$name" /opt/kafka/bin/kafka-topics.sh \
    --bootstrap-server localhost:9092 --list >/dev/null 2>&1; then
    ready=true
    break
  fi
  sleep 2
done
if [ "$ready" != true ]; then
  docker logs "$name"
  exit 1
fi

# 一个分区便于观察顺序;一天保留期只用于本实验。
docker exec "$name" /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 --create --topic order-events \
  --partitions 1 --replication-factor 1 \
  --config cleanup.policy=delete --config retention.ms=86400000 >/dev/null

printf '%s\n' 'OrderConfirmed:demo-1' 'OrderConfirmed:demo-2' |
  docker exec -i "$name" /opt/kafka/bin/kafka-console-producer.sh \
    --bootstrap-server localhost:9092 --topic order-events \
    --producer-property acks=all

# 两个全新组各自从仍保留的最早位置读取,而不是分走一半。
for group in billing-lab risk-lab; do
  printf 'group=%s\n' "$group"
  docker exec "$name" /opt/kafka/bin/kafka-console-consumer.sh \
    --bootstrap-server localhost:9092 --topic order-events \
    --group "$group" --from-beginning \
    --max-messages 2 --timeout-ms 30000
done
预期输出:以下是业务标准输出;工具可能另外向标准错误输出处理条数或运行日志。
group=billing-lab
OrderConfirmed:demo-1
OrderConfirmed:demo-2
group=risk-lab
OrderConfirmed:demo-1
OrderConfirmed:demo-2
两组都读取到两条消息,说明第一组消费没有删除日志。这里的 demo-1、demo-2 是固定测试标识,不是随机生成的 ID。实验只验证消费模型,不代表已验证吞吐或故障恢复能力。
--from-beginning 不是强制重置已有组位点的按钮。组已有有效提交位点时,会从提交位置继续;这里使用全新组,才能从仍保留的最早位置开始。保留窗口以外的数据也无法靠这个参数找回。([Apache Kafka][6])
把选型理由写成可验收的约束
评估时不要只写“需要高吞吐”。应明确峰值事件量、消息大小、允许延迟、最长中断时间、补算窗口和顺序范围,再测试热点分区与消费者追赶能力。单节点演示中的 acks=all 也不能提供节点故障容错。([Apache Kafka][4])
位点提交与外部数据库更新并不天然原子化:处理后尚未提交位点就崩溃,可能重复处理;过早提交又可能漏掉业务操作。Kafka 的事务能力不能直接等同于任意外部业务效果恰好发生一次。([Apache Kafka][3])
据此,持续事件流、多个独立下游和可控历史回放,是优先评估 Kafka 的理由。若主要需求是逐任务确认、灵活路由、优先级或延迟调度,应先比较任务队列模型,而不是因为“吞吐高”就让所有业务适应分区日志。