
架构与系统设计 / 系统课时
分区和队列数量怎么规划
分区和队列数量怎么规划
分区或队列太少,业务增长后可能无法增加有效并行;数量太多,又会抬高复制与运维成本。本篇先区分 Kafka 和 RabbitMQ 的消费模型,再用流量、顺序要求和资源预算计算候选规模,避免凭经验直接填写数量。
学习目标
- 区分分区数量、队列数量与消费者并行度之间的关系。
- 根据目标流量、实测能力和增长空间计算候选规模。
- 识别热点键、复制成本及扩容后顺序变化的风险。
先确认分片与消费者的关系
Kafka 普通消费者组中,一个分区在同组内只分配给一个消费者。采用每消费者同步串行处理时,可同时承担工作的消费者数量不会超过所订阅的分区总数;这里不讨论 Share Group 或分区内部异步处理。([Apache Kafka][1])
RabbitMQ 普通队列可以连接多个竞争消费者,不能把消费者数量直接当成队列数量。需要按订单有序时,可按订单键固定路由到多个队列,并让每个队列只有一个活跃消费者串行处理;还需处理重投递对顺序的影响。([RabbitMQ][2])
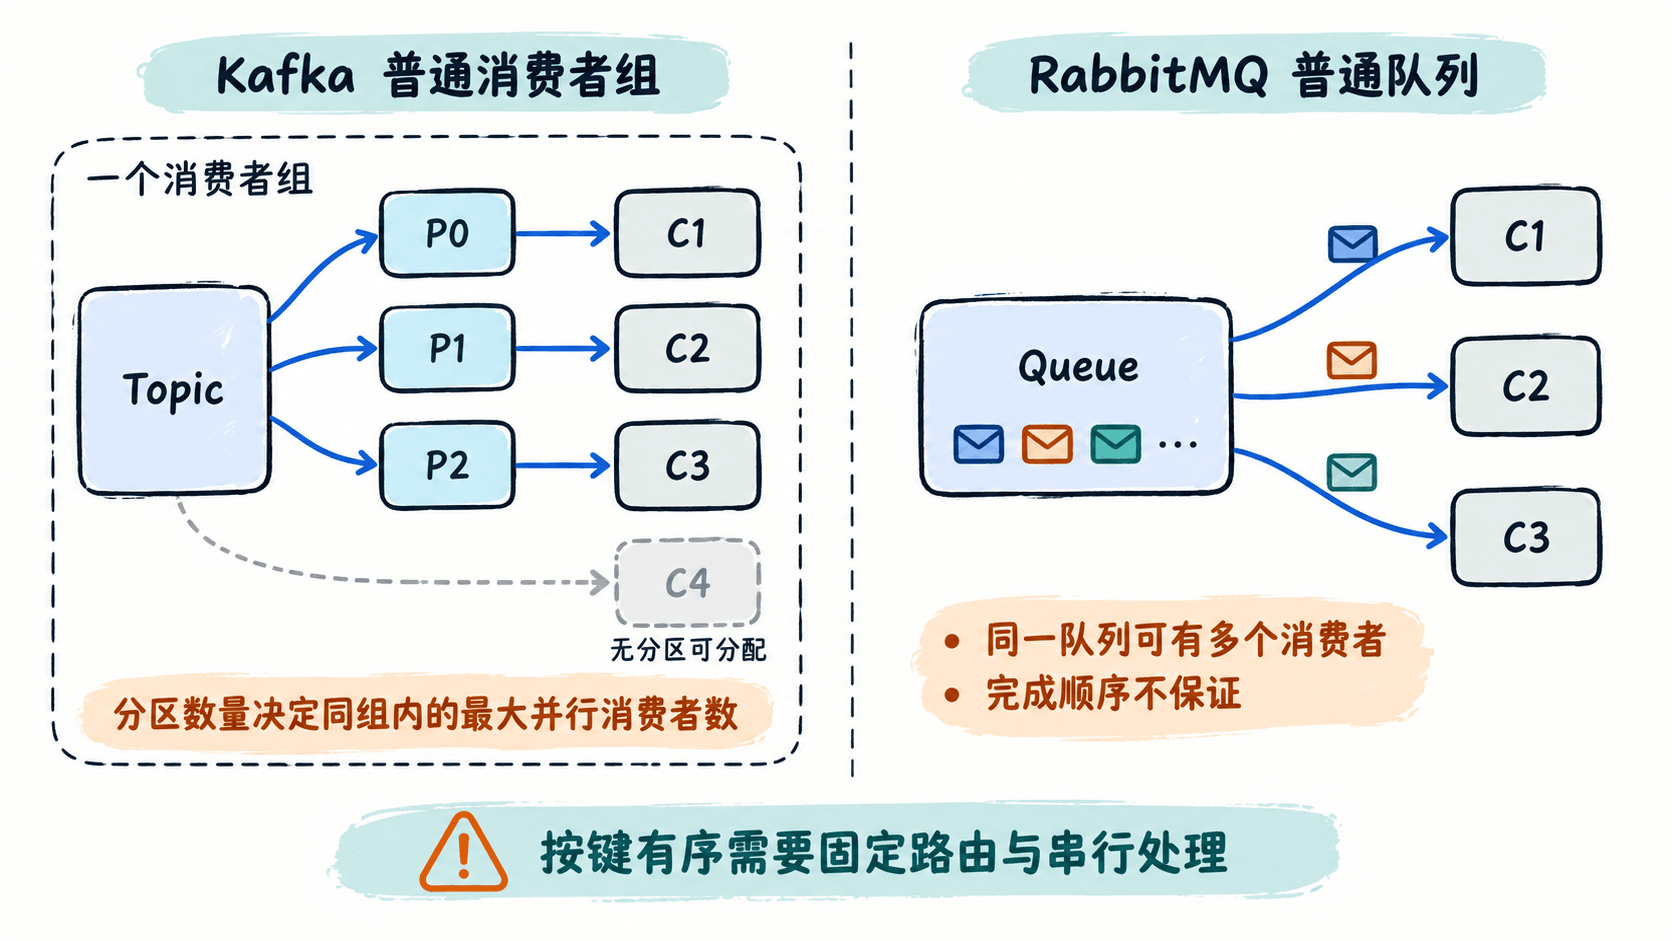
先写清业务究竟需要全局顺序、同订单顺序,还是不要求顺序。只有同订单有序时,不应让所有订单共用一个串行处理槽位;但一个热点订单也不能随意拆到多个槽位,否则原有顺序约束就失效了。
用流量和增长窗口计算候选值
假设订单主题当前峰值为每秒 6000 条,规划窗口内预计增长到 1.5 倍。另假设相同消息大小、复制配置和处理逻辑下,单分区基准能力为每秒 1200 条,按其 70% 做规划。这是教学输入,不是产品默认性能。
增长系数用于覆盖未来流量,70% 用于预留运行余量,两者不要混淆。先按目标流量计算吞吐所需分区数,再与未来希望同时工作的 12 个消费者取较大值。以下 Python 3 完整程序只做计算,不会修改集群。
from math import ceil

def main() -> None:
    # 教学假设;真实规划需替换为相同消息与可靠性配置下的压测值。
    peak_rate = 6000
    growth_factor = 1.5
    measured_partition_rate = 1200
    target_utilization = 0.70
    future_consumers = 12
    replication_factor = 3

    target_rate = peak_rate * growth_factor
    safe_partition_rate = measured_partition_rate * target_utilization
    by_throughput = ceil(target_rate / safe_partition_rate)

    # 仅适用于普通消费者组;预留的是可分配消费者的空间。
    partitions = max(by_throughput, future_consumers)
    replica_copies = partitions * replication_factor
    print(f"target_rate={target_rate:.0f} msg/s")
    print(f"throughput_min_partitions={by_throughput}")
    print(f"candidate_partitions={partitions}")
    print(f"partition_replica_copies={replica_copies}")

if __name__ == "__main__":
    main()
预期输出:
target_rate=9000 msg/s
throughput_min_partitions=11
candidate_partitions=12
partition_replica_copies=36
目标流量为每秒 9000 条,每分区规划吞吐为 840 条,所以吞吐要求至少 11 个分区;为容纳未来 12 个消费者,候选值取 12。该计算假定分配较均衡,且 Broker 总体磁盘、网络和消费端没有更早达到瓶颈。
队列数量需要单独测算
RabbitMQ 应使用对应队列类型、复制配置及消费者组合重新压测,不能复用 Kafka 的单分区数据。单个队列副本的热点执行路径受单核限制,因此消费者持续增加却不再提速时,也要检查队列自身的处理能力。([RabbitMQ][2])
例如仍需每秒 9000 条,假设每队列在指定消费配置下的安全吞吐为每秒 3000 条,则吞吐下限是 3 个队列。只有选择每队列单活串行、并且需要 12 路独立有序处理时,才再把 12 作为队列数量下限;多个竞争消费者不适用这个对应关系。改成单活串行后,还应按新配置重新测算吞吐。
验证资源成本和热点分布
示例中的 12 个分区、3 副本对应 36 份分区日志,不是 36 路组内消费并行。Kafka 的分区日志独立存放,规划时还要核算副本布局与管理成本,不能只看分区数带来的并行空间。([Apache Kafka][3])
建议分别验证正常峰值、热点键集中和单节点故障三类负载。记录每分片消息率、字节率、最长积压时间,以及节点磁盘和网络负载;再检查保留或积压空间、复制恢复余量是否足够。
如果只有一个分片持续落后,应先检查热点键、慢消息和消费者分配。若整个集群已耗尽磁盘吞吐,增加分片并不会凭空增加存储能力。验收标准应是目标流量下积压可控、延迟达标,而不只是分片创建成功。
扩容前保护路由与顺序
Kafka 增加分区不会自动重新分布已有消息。使用按键哈希取模的路由时,新旧分区数量可能把同一个键映射到不同位置;直接增加分区因此可能破坏跨扩容时点的按键处理顺序。Kafka 也不支持直接减少主题分区数。([Apache Kafka][3])
有严格顺序要求时,可在受控窗口暂停受影响路由的写入,处理完旧消息后再切换并恢复。RabbitMQ 修改分片路由也应做同样检查;不能把修改哈希模数当成完整迁移方案。
最终方案应同时说明候选数量、压测依据、增长窗口、顺序边界和扩容方式。数量只是结果,能在目标负载与故障场景下兑现处理能力才是规划完成的标志。