
架构与系统设计 / 系统课时
消费者并发度该怎么设置
消费者并发度该怎么设置
消费者开得更多,不一定消费得更快:分区分配、处理耗时、数据库连接和接口配额都会限制有效并发。本篇通过一个预算不足的算例,区分需要的并发与允许的并发,并把计算结果落实到预取、确认和压测验收。
学习目标
- 根据目标消息率和平均处理时间估算需求并发。
- 联合分区数量、部署规模与下游预算确定有效并发上限。
- 区分处理并发、预取数量和确认进度,避免扩容后过载。
先区分消费者与处理槽位
消费者是接收消息的客户端,处理槽位是同时执行业务的任务位置。本篇算例限定为 Kafka 普通消费者组,每个消费者同步串行处理;在这个模型中,总消费者数与分区数共同限制可用处理槽位。([Apache Kafka][1])
采用异步工作池时,消费者数量不再等于业务并发。Kafka 客户端本身不是线程安全的;不能让多个工作线程随意共享同一个消费者并调用其 API。异步方案还要协调完成顺序和位点提交,不能只增加线程池大小。([Apache Kafka][1])
RabbitMQ 一个队列可以有多个消费者,但真正的业务并发仍取决于客户端回调与应用执行方式。注册多个消费者后仍在一个串行执行通道里处理,不能按注册数量推算吞吐。([RabbitMQ][4])
用处理时间推导需求并发
估算方法是:目标消息率乘以平均单条处理秒数,再除以目标利用率,最后向上取整。处理时间从业务开始执行计到完成,包含正常外部调用等待,但不包含消息在中间件内的排队时间。
假设目标为每秒 240 条、平均处理时间为 0.05 秒,单槽位满负荷理论能力为每秒 20 条。按 75% 利用率规划,单槽位贡献每秒 15 条,需要 16 个槽位;这里的利用率是处理槽位忙碌比例,不是 CPU 使用率。
这是均衡负载下的初始估算,不是延迟保证。压测时应重新测量平均耗时,并检查第 95、99 百分位的尾延迟;不要把排队导致的总延迟直接代入,否则可能用扩容继续放大下游拥塞。
用全链路预算裁剪并发
假设主题有 12 个分区,部署 3 个实例,每实例配置 4 个串行消费者。数据库给整个消费业务预留 10 个连接,且本例每条消息全程占用一个连接,因此最多按 10 个处理槽位规划,不是每实例各有 10 个。
再假设外部接口可用预算为每秒 360 次调用,每条消息需要调用 2 次,则接口最多支持每秒 180 条消息。接口配额必须先换算成消息率,再与处理吞吐比较,不能把 QPS 数值直接与线程数量取最小值。
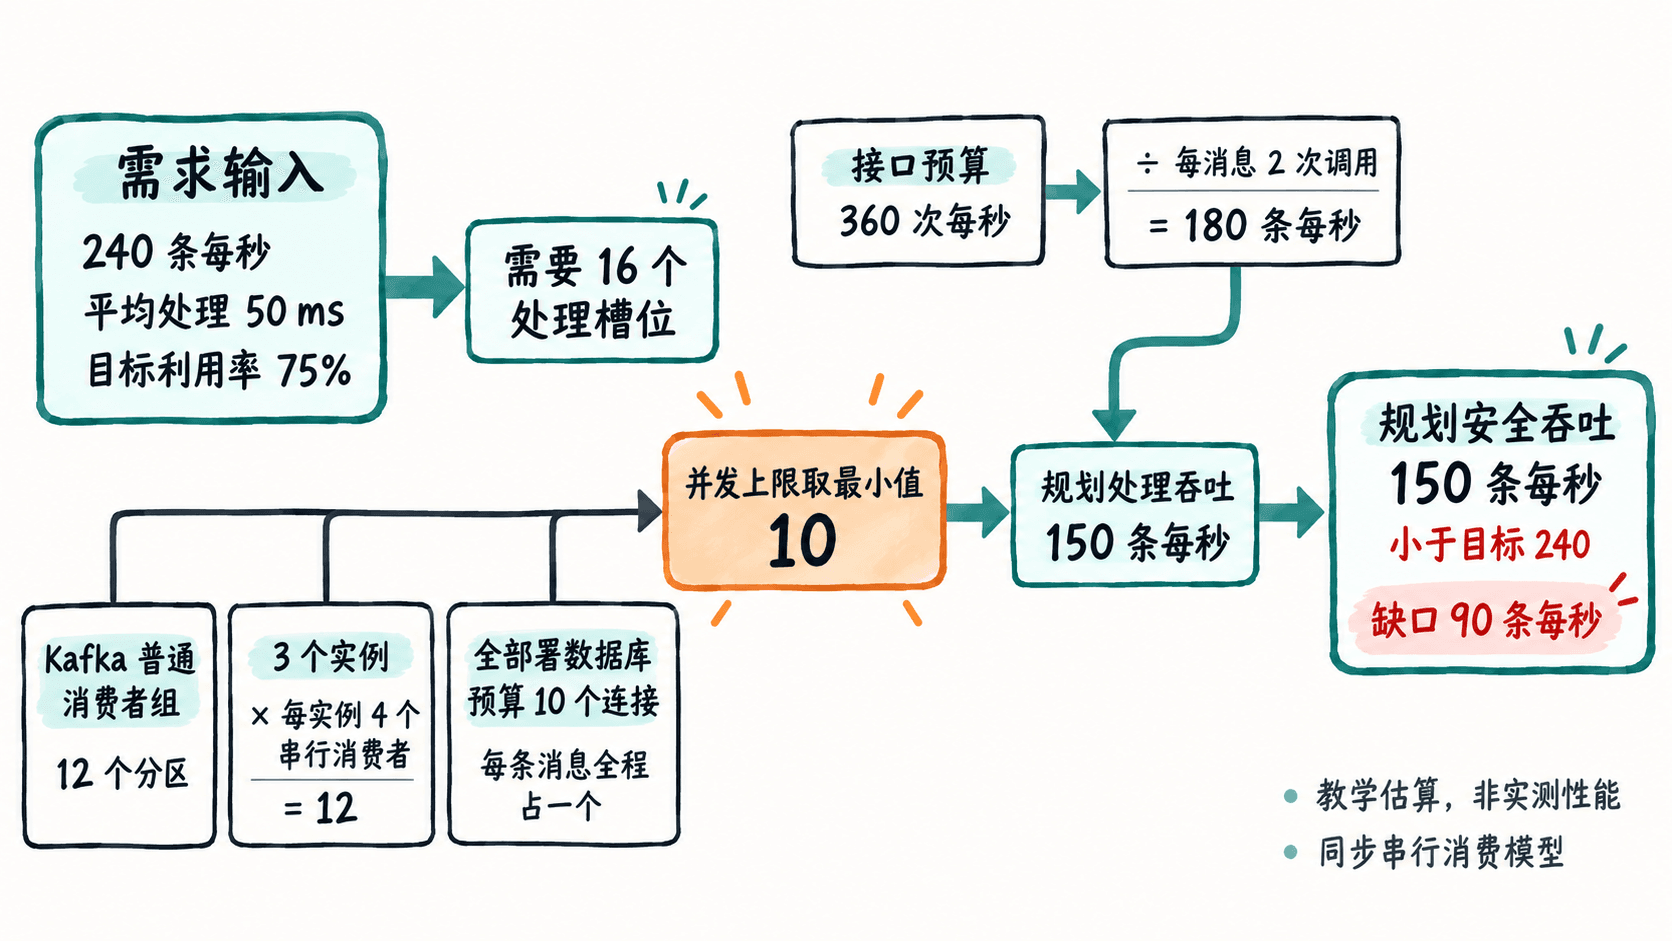
在 Python 3 环境执行以下完整程序,无需安装中间件客户端。变量都是本次教学预算;更换真实数据后,应保留各预算的统计范围和单位。
from math import ceil

def main() -> None:
    # 平均耗时不含消息在中间件中的排队;假定负载均衡。
    target_rate = 240
    mean_seconds = 0.05
    utilization = 0.75
    partitions = 12
    instances = 3
    consumers_per_instance = 4

    # 全部署共享的业务预算;本例每条消息全程占用一个连接。
    db_slots = 10
    api_qps_budget = 360
    api_calls_per_message = 2

    needed = ceil(target_rate * mean_seconds / utilization)
    configured = instances * consumers_per_instance
    parallel_cap = min(partitions, configured, db_slots)

    # 先把接口配额换算成消息率,不能把 QPS 与并发数直接取最小值。
    api_rate_cap = api_qps_budget / api_calls_per_message
    safe_rate = min(parallel_cap * utilization / mean_seconds, api_rate_cap)
    print(f"needed_concurrency={needed}")
    print(f"configured_consumers={configured}")
    print(f"parallel_cap={parallel_cap}")
    print(f"api_rate_cap={api_rate_cap:.0f} msg/s")
    print(f"planned_safe_rate={safe_rate:.0f} msg/s")
    print(f"meets_target={safe_rate >= target_rate}")

if __name__ == "__main__":
    main()
预期输出:
needed_concurrency=16
configured_consumers=12
parallel_cap=10
api_rate_cap=180 msg/s
planned_safe_rate=150 msg/s
meets_target=False
16 是需求,不是可以直接配置的安全值。当前并发上限为 10,按预留余量计算的吞吐为每秒 150 条,达不到目标;这不是实测吞吐,也不意味着系统已经自动限速到该值。
部署时应把处理并发限制在预算内,并单独执行接口限速。若每实例必须使用相同并发参数,3 个实例可先各设 3 个,再按总并发 9 重算容量。要满足目标,需要优化处理耗时或同时调整分区、实例和下游预算,而不是单独扩大线程池。
把预取与确认配套设置
RabbitMQ 在手动确认、按消费者限制预取的模式下,prefetch 限制未确认消息数,不是工作线程数。例如 8 个消费者各预取 20 条,合计可能有 160 条未确认消息,但不代表 160 条正在处理;该模式下 0 表示不限。([RabbitMQ][5])
可从接近实际处理能力的预取窗口开始压测,再为网络等待留适量缓冲。增加预取时同时观察未确认数量和内存,不能只看队列中待投递消息变少。处理成功后再确认,失败重投必须配合幂等。([RabbitMQ][6])
Kafka 的 max.poll.records 只限制一次 poll() 返回的记录数,不会增加消费者数量。同步处理一批消息时,要让最坏处理耗时、重试与提交开销留在 max.poll.interval.ms 的预算内;不能用平均耗时保证不会超时。([Apache Kafka][7])
异步处理时,提交进度不能越过尚未完成的消息。例如同一分区中,位点 101 已完成、100 未完成,不能提交 102 并假装两条都已处理;应由消费端协调完成进度。停止拉取后也要妥善处理在途任务与确认,避免扩缩容扩大重复处理范围。([Apache Kafka][1])
用压测决定是否继续增加
保持相同消息大小、键分布和到达速率,小幅逐级增加并发,每轮观察成功处理速率、积压年龄、尾延迟、连接等待及接口限流。只有吞吐上升且下游仍有余量,才继续增加。
当吞吐不再提升,而等待、超时或重试开始增长,应退回上一档。最终并发值应是达到目标且保有余量的最小稳定配置;目标暂时无法满足时,明确容量缺口,并用有界缓冲与背压保护下游。