
架构与系统设计 / 系统课时
Exactly Once 到底保证什么
Exactly Once 到底保证什么
看到中间件标注 Exactly Once,不能直接推断发货接口或数据库更新只会执行一次。本篇把代理日志、流处理状态和外部副作用拆开,说明各自需要什么提交边界,并用本地事务验证重复调用为何可以只留下一个业务结果。
学习目标
- 说明 Exactly Once 保护的对象,而不是只复述“恰好一次”。
- 区分幂等生产、流处理状态一致性与外部业务效果。
- 验证去重记录和业务变更的原子性,并识别远程调用的保证缺口。
“一次”通常修饰提交效果
**Exactly Once 是有范围的效果保证,不是“处理函数从未重跑”。**例如 Flink 故障恢复会重放输入,但在正确启用相关机制后,同一输入对其受管理状态只产生一次有效影响。分析承诺时,先找受保护的状态和输出。([Apache Nightlies][5])
Kafka 的幂等生产者解决协议级重试造成的重复追加,并不按订单号识别业务重复。因此,应用主动发送两个内容相同的订单事件,仍需要业务层判断它们是否代表同一操作。幂等发送不等于消费幂等。([Apache Kafka][6])
流处理把哪些提交绑在一起
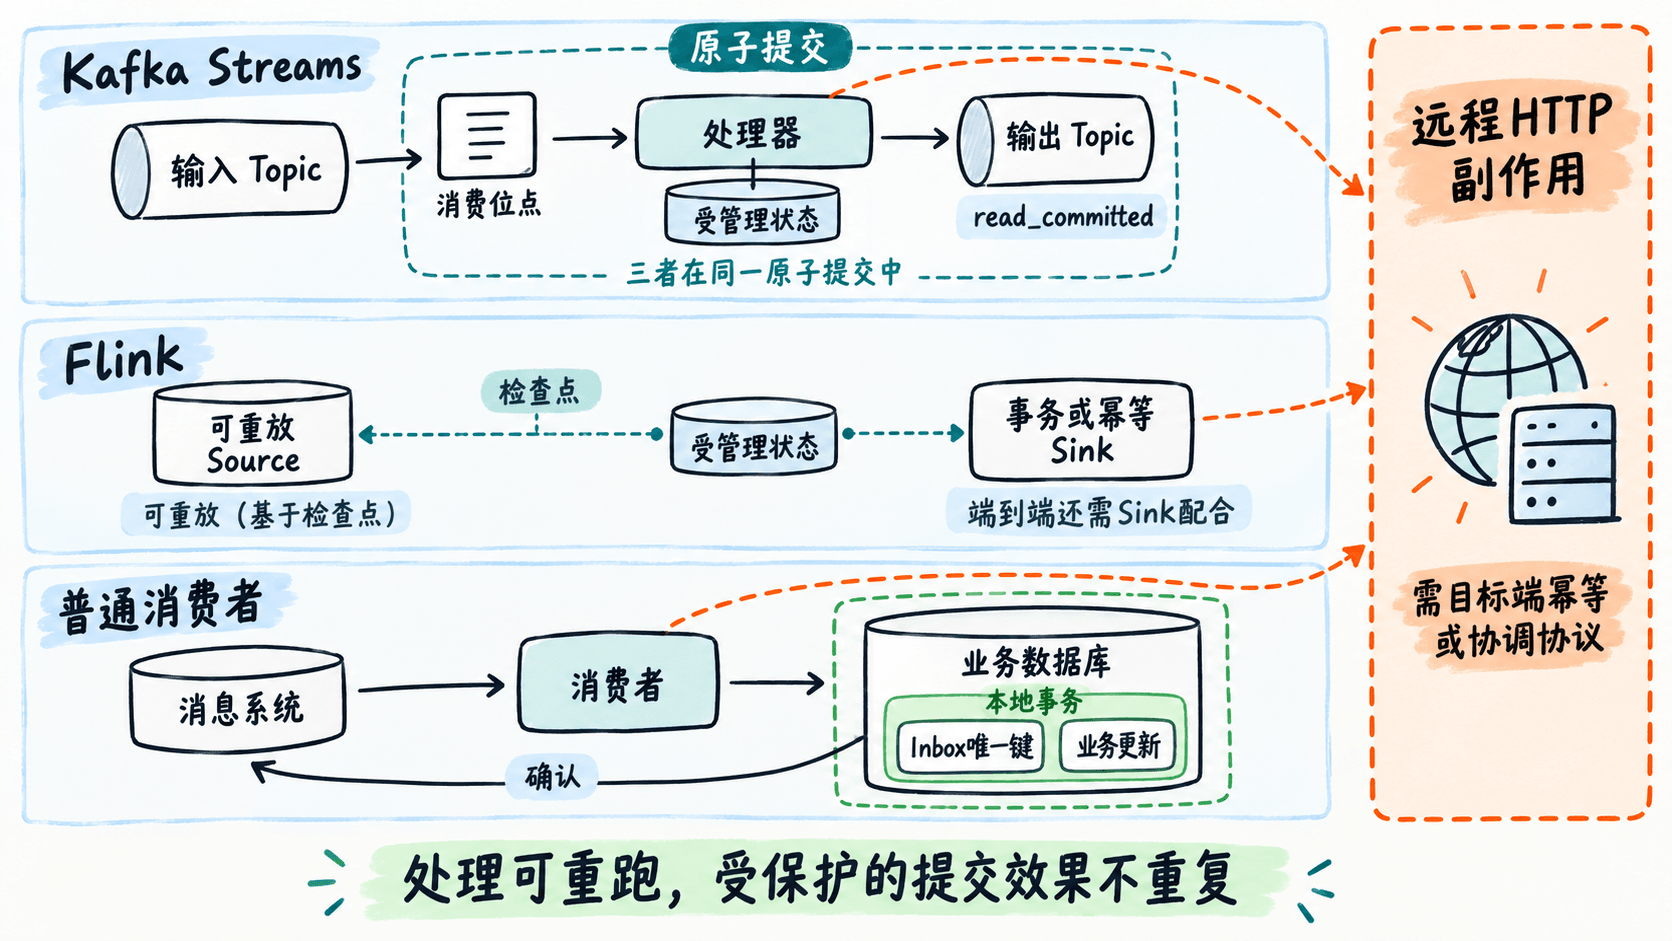
Kafka Streams 的 Exactly Once 将输入消费位点、受管理状态更新和输出 Topic 写入协调为原子提交。事务失败时,不能只推进消费进度却漏掉输出,也不能让失败事务的输出成为有效处理结果。任意外部数据库或 HTTP 调用不自动加入这一边界。([Apache Kafka][7])
读取 Kafka 事务输出的下游需要采用 read_committed,避免读到已中止事务的记录。这个隔离级别只是控制读取可见性,不会自动为业务代码创建事务,也不会去掉普通非事务消息。([Apache Kafka][8])
Flink 通过检查点协调输入位置与受管理状态;故障后从一致位置恢复并重放。要把保证延伸到输出端,还需要可重放的输入源(Source),以及正确集成的事务型或幂等型输出端(Sink)。仅打开检查点,不代表任意输出接口都满足端到端 Exactly Once。([Apache Nightlies][5])
数据库副作用需要自己的原子边界
设定业务目标:同一条订单确认事件只给计数器加一。下面把事件唯一键写入 inbox,并把计数器更新放进同一本地事务。唯一键冲突时跳过更新;事务失败时两者一起回滚,避免“记为已处理,但业务没成功”。([SQLite][9])
示例使用 Python 3.11 标准库 sqlite3,底层 SQLite 需支持 3.24 起提供的 UPSERT。保存为 once_effect.py,执行 python once_effect.py。内存数据库只验证事务与重复调用,不验证进程重启或断电后的持久性。([Python documentation][10])
import sqlite3
from contextlib import closing

def consume(db: sqlite3.Connection, event_id: str,
            fail_before_commit: bool = False) -> str:
    with db:
        # 唯一键判重与业务更新必须在同一本地事务中。
        inserted = db.execute(
            "INSERT INTO inbox(event_id) VALUES (?) "
            "ON CONFLICT(event_id) DO NOTHING",
            (event_id,)
        ).rowcount
        if inserted == 0:
            return "duplicate"
        db.execute("UPDATE stats SET total = total + 1")
        # 验证业务修改和去重标记会一起回滚。
        if fail_before_commit:
            raise RuntimeError("simulated failure")
    return "applied"

def main() -> None:
    with closing(sqlite3.connect(":memory:", isolation_level="DEFERRED")) as db:
        # 固定的单行计数器只用来观察事务结果。
        db.executescript("""
            CREATE TABLE inbox(event_id TEXT PRIMARY KEY NOT NULL);
            CREATE TABLE stats(total INTEGER NOT NULL);
            INSERT INTO stats VALUES (0);
        """)
        event_id = "demo-order-confirmed"
        try:
            consume(db, event_id, fail_before_commit=True)
        except RuntimeError:
            total = db.execute("SELECT total FROM stats").fetchone()[0]
            print("after_rollback:", total)
        print("retry:", consume(db, event_id))
        # 模拟提交成功、消费确认丢失后的同键重投。
        print("redelivery:", consume(db, event_id))
        print("total:", db.execute("SELECT total FROM stats").fetchone()[0])
        print("inbox_rows:", db.execute("SELECT COUNT(*) FROM inbox").fetchone()[0])

if __name__ == "__main__":
    main()
预期输出:
after_rollback: 0
retry: applied
redelivery: duplicate
total: 1
inbox_rows: 1首次调用在提交前失败,计数与去重记录一起回滚;第二次重试成功;第三次模拟消费确认丢失后的重投,被识别为重复。三次调用最终只留下一个计数和一条去重记录,说明调用次数与提交效果次数可以不同。
真实消费者应在本地事务成功后再确认消息。该模式还要求可靠保存业务表与去重表,且重放使用同一个稳定事件键;示例中的 demo-order-confirmed 是固定测试值。换键重放、提前删除去重记录,都不在这个示例的保证范围内。([RabbitMQ][2])
把远程调用写进事务代码仍然不够
假设把计数器更新换成普通发货 HTTP 调用:承运方已受理,消费者却在本地提交前宕机。本地事务可以回滚,已经发生的远程效果却不会因此撤销;恢复后再次调用就存在重复创建风险。外部目标必须参与相应协议,不能只看代码是否位于事务块中。([Apache Kafka][1])
若目标服务提供幂等契约,重试应复用同一操作键,并核对键的作用域、保留期和参数一致性要求。若没有这样的契约,应把超时视为结果未知,通过结果查询或人工核对闭环,而不是直接断定失败并重复操作。([Amazon Web Services, Inc.][4])
验收时检查结果,而不是只数日志
针对自己的链路,至少做三项检查:
- 在提交前注入失败,确认业务结果与进度或去重标记不会一边成功、一边失败。
- 在提交成功但确认尚未生效时中断,再次投递同一输入,核对最终业务结果没有重复。
- 测试并发重复、服务重启和允许的最长重放间隔,确认唯一键及去重记录的保存策略覆盖这些条件。
上面的程序只覆盖前两项中的本地事务与重复调用模型,不能替代真实进程故障和中间件联调测试。验收结论应写清“哪个输入、哪个目标、哪些故障下,提交效果只出现一次”;不能因为日志只打印一次,就把局部保证扩展成整条业务链路的保证。