
架构与系统设计 / 系统课时
用 Kafka 跑通生产和消费
用 Kafka 跑通生产和消费
你将用一个本地 Kafka 节点保存三条订单事件,再让两个消费组分别读取它们。完成后,你不仅能确认消息已经写入和读出,还能解释分区承担什么作用,以及为什么一组读完后,另一组仍能读取相同事件。
学习目标
- 建立 Producer、Topic、Partition 与 Consumer Group 的关系。
- 使用容器内置工具创建 Topic,并完成生产和消费。
- 区分日志保留、分区顺序与消费组的位置记录。
把四个角色放进同一条链路
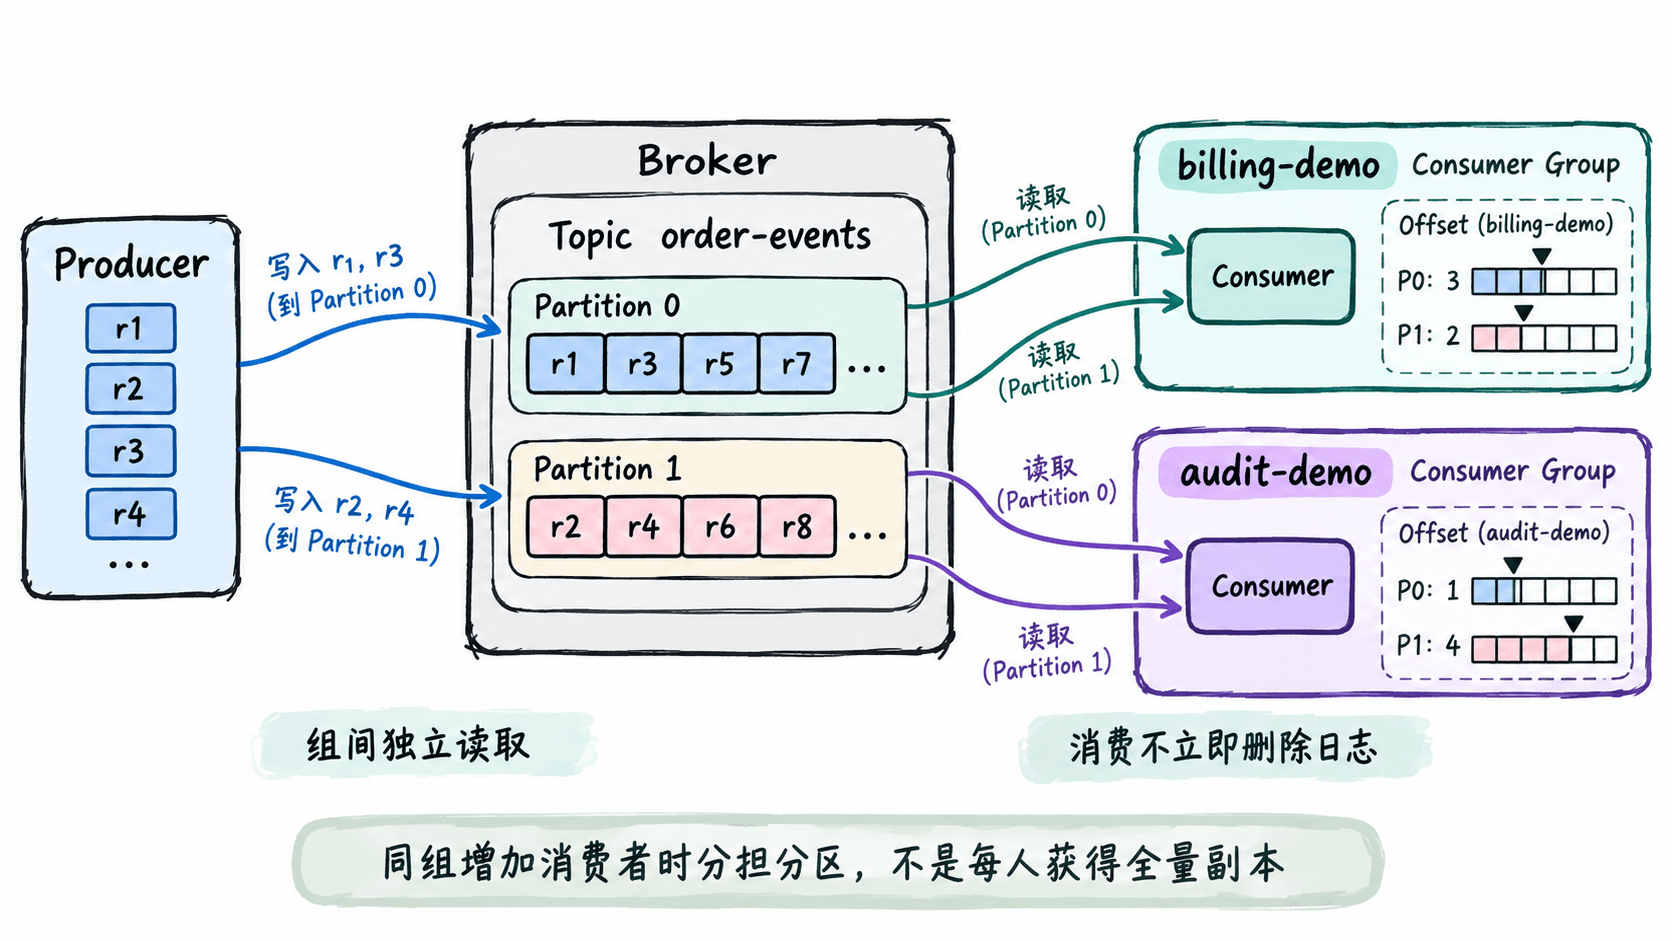
Producer 是写入客户端,Topic 是事件的逻辑集合,Partition 是 Topic 内实际追加记录的有序日志。每条记录写入一个分区,而不是复制到所有分区;消费者读取记录后,日志仍按保留策略保存。([Apache Kafka][1])
本课使用普通 Consumer Group:同组消费者分担分区,稳定分配时,一个分区由组内一个消费者负责;不同组各自维护消费位置。一个消费者也能负责多个分区,因此本例每组只启动一个消费者。([Apache Kafka][2])
启动一个隔离的实验节点
前置条件是 Docker 已运行,命令在 Bash 中执行;Windows 可使用已配置 Docker 集成的 WSL2。固定使用 apache/kafka:4.1.2 的单节点环境,客户端也在容器内运行,不要求宿主机安装 Java。([Apache Kafka][3])
以下命令按顺序执行,假定不存在名为 eda-kafka 的旧容器。不发布宿主机端口,是因为本课所有 Kafka 命令都通过容器内的 localhost:9092 访问节点。
(
set -e
# 客户端与 Broker 共用容器网络,不开放宿主机端口。
docker run -d --name eda-kafka apache/kafka:4.1.2
ready=0
for attempt in {1..20}; do
  if docker exec eda-kafka /opt/kafka/bin/kafka-topics.sh \
    --bootstrap-server localhost:9092 --list >/dev/null 2>&1; then
    ready=1
    break
  fi
  sleep 2
done
# API 探测失败就停止,避免把启动故障误判成消息丢失。
if [ "$ready" -ne 1 ]; then
  docker logs --tail 40 eda-kafka
  exit 1
fi
echo "Kafka ready"
)
预期输出,省略首次拉取镜像的进度:
<ID>
Kafka ready
<ID> 表示实际生成的容器标识,每次可能不同。这里以 Topic 查询成功作为继续实验的条件,而不是仅凭容器处于运行状态就认定 Kafka 已经可用。
显式创建两个分区
创建 order-events 时明确指定两个分区和一个副本。分区数决定日志如何拆分,副本因子决定每个分区保存几份副本;两者不是同一个数量。本节点只有一台 Broker,因此这个实验不具备副本容灾能力。([Apache Kafka][1])
# 显式设置分区数,不依赖自动创建 Topic 的默认值。
docker exec eda-kafka /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 --create \
  --topic order-events --partitions 2 --replication-factor 1
docker exec eda-kafka /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 --describe --topic order-events
预期输出,以下仅保留关键字段,实际还可能包含配置等列:
Created topic order-events.
Topic: order-events TopicId: <ID> PartitionCount: 2 ReplicationFactor: 1
Topic: order-events Partition: 0 Leader: <ID> Replicas: <ID> Isr: <ID>
Topic: order-events Partition: 1 Leader: <ID> Replicas: <ID> Isr: <ID>
这里的 <ID> 分别代指实际 Topic 标识或 Broker 标识,不要求它们相同。验收重点是存在分区 0、1,且 PartitionCount 为 2,不要把 Topic 创建成功等同于消息已经写入。
写入一次,再让两个组读取
示例把固定订单标识 order-demo-1 放在消息 Key 中。采用默认按 Key 分区的行为,且分区数不变时,相同 Key 的记录进入同一分区,因此这三条事件能按写入顺序读取;不能据此推导整个 Topic 全局有序。([Apache Kafka][4])
下面是同一个主实验:先发布三条事件,再依次启动 billing-demo 和 audit-demo。使用 --max-messages 3 让每次消费读满三条后结束,使用 --timeout-ms 避免没有消息时一直等待。
(
set -e
# 分隔符左侧是 Key,右侧才是消息正文;每行是一条事件。
docker exec -i eda-kafka /opt/kafka/bin/kafka-console-producer.sh \
  --bootstrap-server localhost:9092 --topic order-events \
  --property parse.key=true --property 'key.separator=|' <<'EOF'
order-demo-1|{"type":"OrderCreated","orderId":"order-demo-1"}
order-demo-1|{"type":"OrderConfirmed","orderId":"order-demo-1"}
order-demo-1|{"type":"OrderShipped","orderId":"order-demo-1"}
EOF
# 两个新组读取同一份日志,而不是让第二组接收第一组的剩余消息。
for group in billing-demo audit-demo; do
  echo "=== $group ==="
  docker exec eda-kafka /opt/kafka/bin/kafka-console-consumer.sh \
    --bootstrap-server localhost:9092 --topic order-events \
    --group "$group" --from-beginning --max-messages 3 \
    --timeout-ms 30000 --property print.key=true \
    --property 'key.separator=|'
done
)
预期输出,两个消费组各读到三条事件:
=== billing-demo ===
order-demo-1|{"type":"OrderCreated","orderId":"order-demo-1"}
order-demo-1|{"type":"OrderConfirmed","orderId":"order-demo-1"}
order-demo-1|{"type":"OrderShipped","orderId":"order-demo-1"}
Processed a total of 3 messages
=== audit-demo ===
order-demo-1|{"type":"OrderCreated","orderId":"order-demo-1"}
order-demo-1|{"type":"OrderConfirmed","orderId":"order-demo-1"}
order-demo-1|{"type":"OrderShipped","orderId":"order-demo-1"}
Processed a total of 3 messages
统计行由控制台消费者写到标准错误,事件写到标准输出,终端合并显示时统计行的位置可能略有差异。验收依据是每组都获得相同的三条事件,而不是日志行的交错位置。
读不到消息时,先区分数据与消费位置
--from-beginning 不是强制重播按钮。组没有可用消费位置时,它才选择当前仍保留的最早记录;已经提交位置的组通常继续向后读取。只重复消费者命令没有新输出,不等于之前的记录被删除。
本课预设了空环境、容器内访问和两个新组,出现偏差时先检查这些条件,不要立刻修改 Broker 参数:
| 现象 | 优先检查与处理 |
|---|---|
启动阶段没有出现 Kafka ready |
查看脚本打印的容器日志,先解决节点启动失败 |
| 创建时报告 Topic 已存在 | 环境不是空的;不要假定旧 Topic 的分区数和消息数量符合本例 |
| 只重跑某组消费者时没有旧消息 | 为重放使用一个未使用过的组名,并保留 --from-beginning |
两个分区不保证本次样例均匀分布:三条消息使用同一个 Key,集中在一个分区是有意安排。普通消费组内增加消费者只能分担分区,不能把这个分区的记录广播给每个成员。([Apache Kafka][4])
结束后只清理本课创建的容器;下面的操作会删除这个实验节点及其匿名卷,不要用于需要保留数据的环境。
# 仅销毁本课的一次性实验节点。
docker rm -f -v eda-kafka
预期输出:
eda-kafka本实验验证的是分区写入、消息读取与组间独立消费,不用于证明高可用或业务恰好处理一次。