
架构与系统设计 / 系统课时
消费积压持续上涨怎么查
消费积压持续上涨怎么查
消费积压持续上涨,不一定是消费者实例太少,也可能是热点分区、下游变慢或提交进度停住。本篇通过只读采样比较写入与消费进度,再沿处理链路定位瓶颈,最终判断修复后能否在数据过期前追平。
学习目标
- 区分已提交位点积压、客户端拉取进度和业务完成进度。
- 用同一分区的连续快照计算写入、提交推进与积压增长速度。
- 根据分区分布和处理耗时选择修复措施,并验证追平能力。
先确认告警统计的是哪种积压
以下以 Kafka 4.1 普通消费组为例。查询工具中的 CURRENT-OFFSET 是消费组已提交位点,LOG-END-OFFSET 是日志末端位点,LAG 是两者之差。它首先表示位点距离,不直接等于业务尚未完成的事件数。([Apache Kafka][1])
客户端指标 records-lag-max 基于消费位置而非已提交位点,而且是窗口内的最大分区积压,不是全组积压之和。客户端已经取走记录,也不代表数据库写入已经完成;业务成功速率需要应用单独记录。([Apache Kafka][2])
下面采用“业务完成后才提交位点”的处理约定。实际排查要确认应用确实遵守该约定,否则提前提交可能使监控看起来正常,而业务任务仍在内存队列中等待。([Apache Kafka][3])
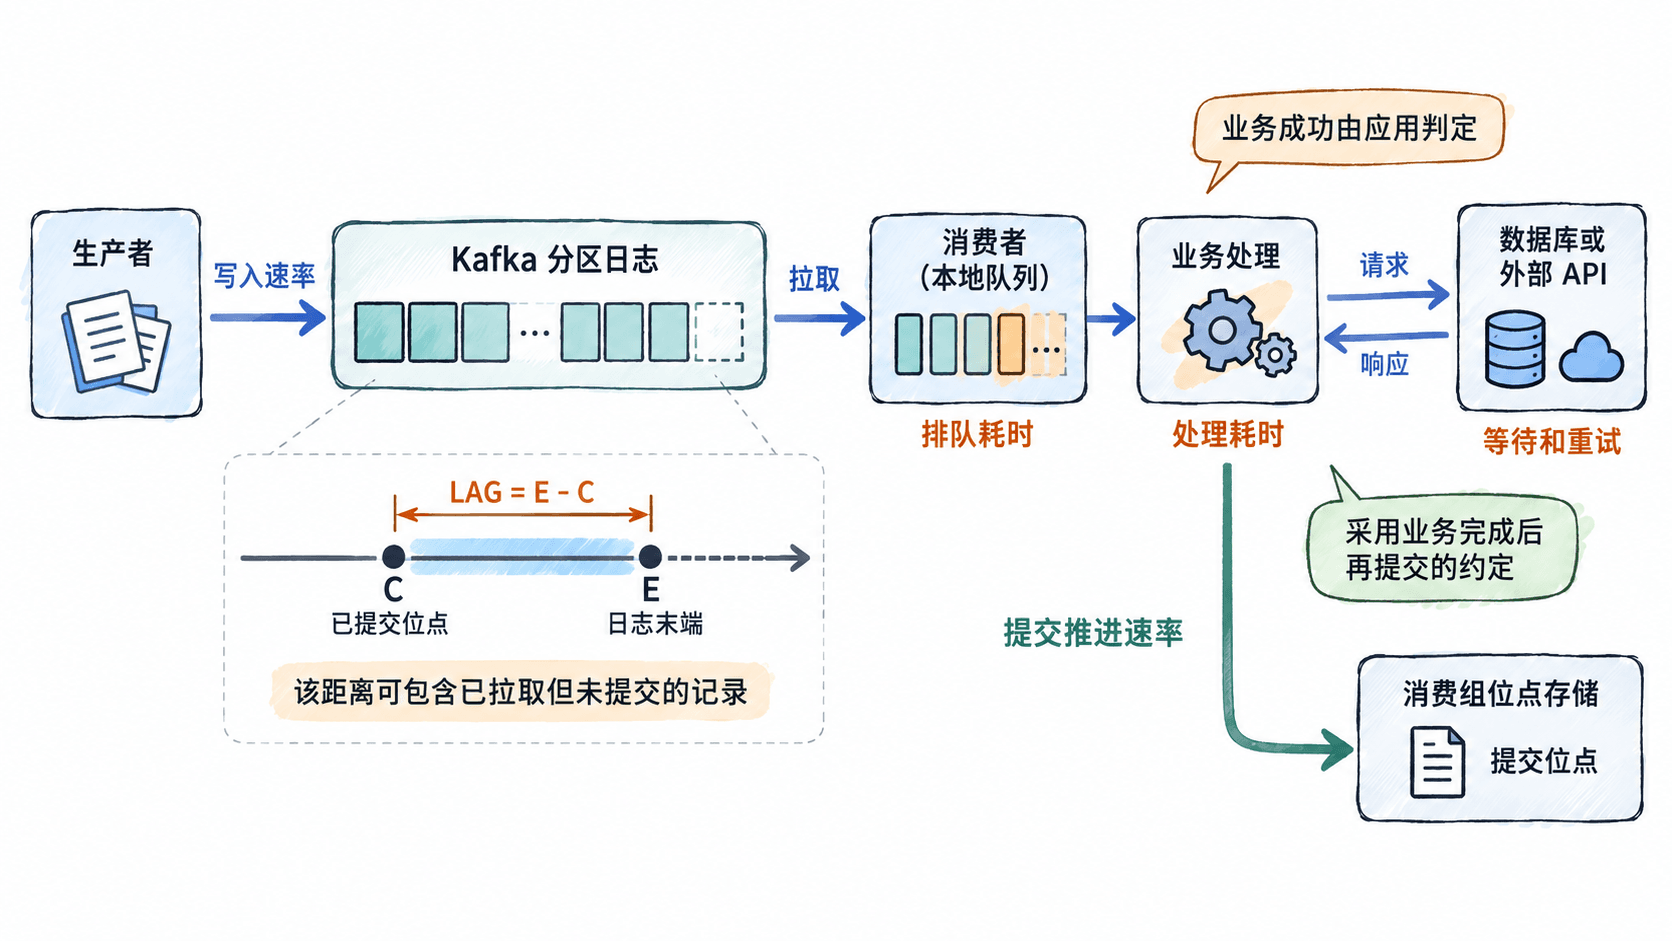
采样同一分区的写入和提交进度
准备 Kafka 4.1 命令行工具、可访问的消费组和已验证可用的客户端连接配置文件。将 <PATH> 分别替换为安装目录及配置文件路径,将 <HOST>、<PORT>、<ID> 替换为引导地址和消费组标识。无鉴权测试集群的客户端配置文件可以为空,但文件必须存在。
在 Bash 中运行下面的只读脚本。它保留主题、分区和三个位点字段,避免成员地址干扰比较;字段位置按 Kafka 4.1 工具的非详细位点输出提取。
#!/usr/bin/env bash
set -euo pipefail
KAFKA_HOME='<PATH>'
CLIENT_CONFIG='<PATH>'
BOOTSTRAP='<HOST>:<PORT>'
GROUP='<ID>'
# 只描述消费组,不重置位点,也不启动新的消费者。
args=(--bootstrap-server "$BOOTSTRAP" --command-config "$CLIENT_CONFIG"
      --group "$GROUP" --describe --offsets)
for sample in 1 2; do
  printf 'sample=%s time=%s\n' "$sample" "$(date -u +%FT%TZ)"
  echo 'topic partition committed end lag'
  "$KAFKA_HOME/bin/kafka-consumer-groups.sh" "${args[@]}" |
    awk -v g="$GROUP" '$1 == g {print $2, $3, $4, $5, $6}'
  # 实际采样间隔还包含命令耗时,应结合时间戳计算。
  if [ "$sample" -eq 1 ]; then sleep 60; fi
done
预期输出格式如下。这里只截取同一分区,数值是教学样本,不是对现场输出的保证;实际时间以 <TIME> 表示。
sample=1 time=<TIME>
topic partition committed end lag
orders 0 100000 120000 20000
sample=2 time=<TIME>
topic partition committed end lag
orders 0 103600 126000 22400
假设实测采样间隔为 60 秒,日志末端增加 6000,写入推进约为每秒 100 个位点;已提交位点增加 3600,提交推进约为每秒 60 个位点。因此积压每秒净增 40,60 秒增加 2400,与两次 lag 的差值一致。
计算必须匹配同一主题、同一分区,并覆盖多个提交周期。位点重置、分区集合变化时需要重新建立基线;返回 - 或没有数据行时,不能按零积压处理,应先检查组名、权限及是否存在已提交位点。
事务和日志压缩可能造成位点不连续,不能把上述速率直接当成精确的业务事件速率。采用 read_committed 时,还要检查未完成事务是否限制可读位置,不能仅凭日志末端增长就认定消费者算力不足。([Apache Kafka][3])
用分区分布和处理耗时收敛根因
不要只看全组总量。先比较各分区的写入增长、提交增长和积压,再将异常分区关联到实际处理它的消费者。下面列出的是需要验证的假设,不是看到一个指标就宣布根因。
| 观察到的组合 | 优先验证的假设 |
|---|---|
| 多数分区写入变快,业务处理速度近似不变 | 流量增长超过原有处理能力 |
| 只有少数分区持续落后 | 热点键集中,或特定记录反复失败 |
| CPU 高且业务处理耗时增加 | 计算、反序列化或垃圾回收占用时间 |
| CPU 不高,下游调用和连接等待变长 | 数据库、连接池或外部接口成为等待点 |
| 位点周期性停住,同时成员反复变化 | 消费组不稳定造成处理间歇中断 |
为验证这些假设,分别记录本地排队、业务处理、数据库或 HTTP 调用、重试和提交的耗时,比较故障前后的高分位值。这些业务阶段计时需要自行埋点;平均耗时正常时,也应检查是否少量长尾请求拖住整个批次。
Kafka 的 fetch-latency-avg、fetch-throttle-time-avg 和 commit-latency-avg 可补充拉取等待、配额限流及提交耗时的证据。若拉取或提交阶段变慢,应沿对应的网络、Broker 或配额继续验证,不要把全部等待归到业务代码。([Apache Kafka][2])
按瓶颈止损并验证追平
扩消费者之前,检查是否还有可分摊的分区及下游余量。同一普通消费组中,一个分区不会同时分配给多个消费者;已经集中在单个分区上的工作,不能靠增加空闲实例自动拆开。([Apache Kafka][3])
若证据指向下游饱和,优先限制并发、缩短无界等待并约束重试次数;必要时在入口限流或可靠缓冲。坏数据需要隔离时,先明确持久化、补偿和顺序要求,不能通过吞掉异常假装处理成功。
在样本积压 22400、写入仍为每秒 100、修复后提交推进为每秒 140 个位点的条件下,净消化速度为 40,估算追平需要 560 秒。该估算只适用于负载与处理成本相对稳定、位点口径一致的窗口;出速率不超过入速率时,没有有限的追平时间。
同时检查最老未处理数据的剩余可读时间,以及主题的时间和容量保留限制。Kafka 不会为了等待某个消费组而无限保留日志;不能只考虑 retention.ms,还应考虑 retention.bytes。([Apache Kafka][4])
验收应连续覆盖多个提交周期:受影响分区持续推进、积压斜率转负、业务完成延迟下降,并且下游错误率没有因追赶流量上升。保留修复前后的同口径快照,才能说明瓶颈确实被解除。