
架构与系统设计 / 系统课时
同一业务键如何保证顺序
同一业务键如何保证顺序
订单的确认事件还没处理完,发货事件就先落库了;即使消息来自同一队列,也可能出现这种问题。本篇把顺序拆成发布、路由、执行和提交四个环节,建立同一业务键串行、不同业务键可并发的消费方案。
学习目标
- 区分分区或队列中的顺序与业务处理完成的顺序。
- 设计固定业务键路由和串行消费通道,避免异步任务相互超越。
- 处理版本缺口、失败重试和进度确认,识别扩容对顺序的影响。
先界定顺序的范围
订单处理通常只要求同一 order_id 的创建、确认、发货依次生效,不要求所有订单全局排队。这里把业务键定义为需要保持因果关系的对象标识;多租户订单号不全局唯一时,应把租户标识也纳入键。
必须分开看待消息写入顺序、交付顺序与业务提交顺序。先收到的事件如果被交给一个慢任务,后收到的事件交给另一个快任务,完成顺序就可能反转;Kafka 消费者文档也明确提醒线程池处理的这一风险。([Apache Kafka][5])
本例约定源头为每张订单生成从 1 开始的连续版本,并按版本发布。多个生产实例更新同一订单时,要用单写者或数据库并发控制确定先后;消费端不能靠按时间戳排序,补出源头尚未定义的业务因果关系。
从发布到落库守住同一条通道
| 实现 | 本节采用的路由方式 | 消费端约束 |
|---|---|---|
| Kafka | 同一主题、相同业务键和固定分区映射 | 一个分区内按读取顺序完成业务提交 |
| RabbitMQ | 按业务键稳定路由到同一队列 | 每队列一个活动消费者,处理逻辑内部串行 |
Kafka 的分区日志保证按写入顺序读取,不保证业务库按同样顺序提交。使用键路由还需保持键序列化与分区策略一致,不能启用忽略键或随机分区的策略后仍声称键内有序。([Apache Kafka][6])
RabbitMQ 的单通道发布可保持对应队列的入队顺序;多通道发布、优先级和重新入队会影响实际顺序。单活动消费者是本节的简化方案,但它内部仍不能把同键消息随意扔进并行任务池。([RabbitMQ][7])
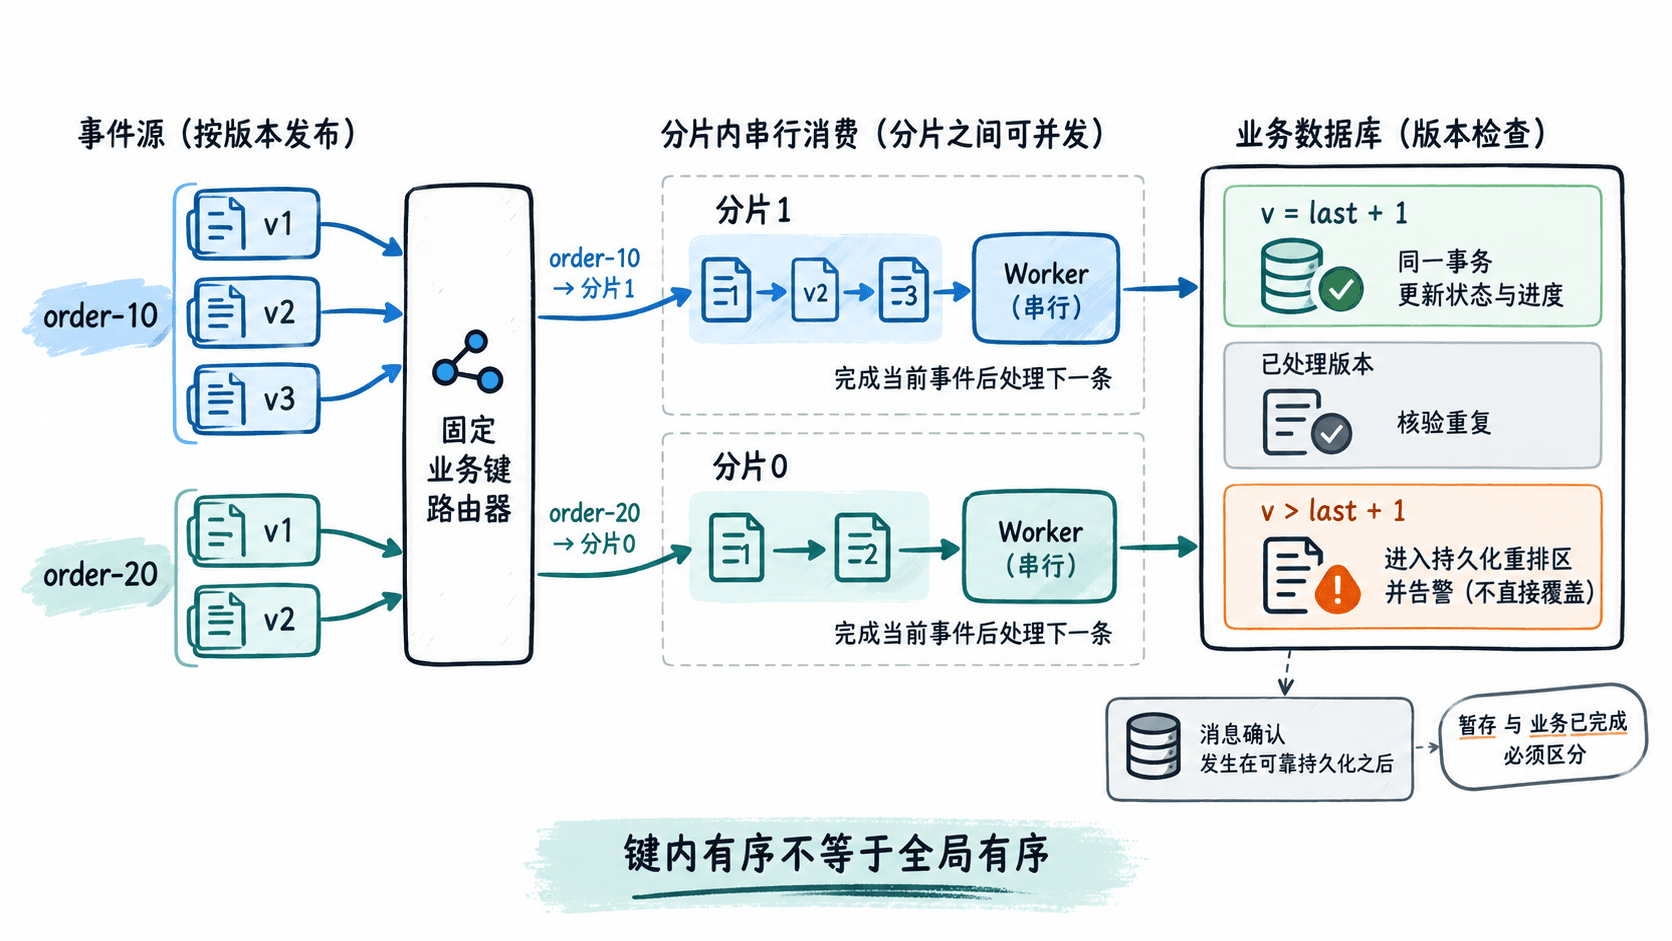
Kafka 生产端也要检查重试配置:关闭生产者幂等且允许多个请求并发在途时,失败批次重试可能被后发批次超越。生产者的幂等能力只保护相应生产过程,不替代消费者的业务幂等。([Apache Kafka][8])
运行一个键内串行的最小模型
下面用 Python 3.11 及以上的标准库演示两个串行通道并发工作。列表模拟已经收到的有限消息批次,不需要安装中间件。order-10 和 order-20 是固定测试键,分别映射到不同通道。
import asyncio
import zlib
from collections import defaultdict

# 固定测试数据:每个订单内部已按业务版本发布。
events = [
    ("order-10", 1, "CREATED"),
    ("order-20", 1, "CREATED"),
    ("order-10", 2, "CONFIRMED"),
    ("order-20", 2, "CONFIRMED"),
    ("order-10", 3, "SHIPPED"),
]

async def main() -> None:
    lanes = [[], []]
    for event in events:
        # 这里只演示固定分片,不是 Kafka 默认分区算法。
        lane_id = zlib.crc32(event[0].encode("utf-8")) % len(lanes)
        lanes[lane_id].append(event)

    versions = defaultdict(int)
    history = defaultdict(list)

    async def consume_lane(batch: list) -> None:
        for order_id, version, status in batch:
            if version != versions[order_id] + 1:
                raise ValueError(f"version gap or duplicate: {order_id}")
            # 同一通道等待当前事件完成;较慢事件不会被后继超越。
            await asyncio.sleep(0.02 if version == 1 else 0)
            versions[order_id] = version
            history[order_id].append(status)

    # 通道之间并发,通道内部串行;异常会取消其余未完成任务。
    async with asyncio.TaskGroup() as workers:
        for batch in lanes:
            workers.create_task(consume_lane(batch))

    assert history["order-10"] == ["CREATED", "CONFIRMED", "SHIPPED"]
    assert history["order-20"] == ["CREATED", "CONFIRMED"]
    for order_id in sorted(history):
        print(order_id + ": " + " -> ".join(history[order_id]))

if __name__ == "__main__":
    asyncio.run(main())
预期输出:
order-10: CREATED -> CONFIRMED -> SHIPPED
order-20: CREATED -> CONFIRMED
每个通道内部的 await 确保当前处理完成后才开始下一条;TaskGroup 让两个通道并发等待。最终按订单号整理输出,刻意不承诺两个订单之间谁先完成。这里是异步并发,不是多核并行。([Python documentation][9])
把同一订单的版本 2 放到版本 1 前面,程序会抛出包含 version gap or duplicate 的异常,而不是自动恢复业务顺序。这正说明固定路由只能保住输入顺序,不能纠正源头乱序;本例内存状态也不具备重启恢复能力。
失败、缺号与确认如何处理
生产实现需要持久化已处理版本,并把版本检查、业务修改与去重记录放在同一事务中。本例采用“每条事件都必须生效”的语义,建议按以下规则处理,不能简单地看到更大版本就覆盖。
| 收到的版本 | 应对方式 |
|---|---|
| 等于已处理版本加 1 | 执行业务,成功后推进版本 |
| 不大于已处理版本 | 核对已处理记录和载荷;确认重复后才跳过 |
| 大于已处理版本加 1 | 记录版本缺口,暂存并补齐,不执行后续增量 |
普通瞬时失败应在当前通道退避重试,后继事件不能越过它。永久失败需要暂停或隔离该键并告警;仅把失败事件移入死信队列,却继续执行依赖它的后续事件,并不满足严格顺序要求。
版本缺口不能一律原地死等:缺失事件可能就排在同一队列后面。此时应先可靠持久化待重排事件,再继续接收并由独立调度补齐;只有具备可恢复暂存记录,才能确认已接收,且不能把“已暂存”记成“业务已完成”。
Kafka 提交的是分区恢复位置,不能用最大已完成 offset 代替无未完成空洞的安全进度。假设同一分区 offset 100 尚未成功、101 已成功,提交 102 会让重启跳过 100;提交必须由分区级进度协调。([Apache Kafka][5])
连续版本规则还要求消费者接收该流的全部相关事件。若订阅会过滤事件,或一个业务版本对应多条消息,需要定义专用流序号或明确前序依赖,否则正常过滤也会被误判为缺号。
扩容时不能破坏的边界
本例的取模路由依赖固定通道数。改变分片数量可能让部分键换道,旧通道积压与新通道事件就可能并行;因此扩容要安排排空切换或迁移屏障,不能只修改取模参数就直接上线。
重新分配分区时,先停止向旧通道派发并处理在途任务,再让新所有者接管;必要时让数据库校验所有权代次,拒绝旧执行者的写入。热点键仍受串行约束,增加其他通道只能分散其他键的负载。
先用分片内串行建立可验证的正确性,再根据瓶颈优化到键级串行。无论采用哪种实现,都应以业务版本、提交结果和恢复后的行为验收,而不是只看队列是否按顺序取出了消息。