
架构与系统设计 / 系统课时
消息系统应该监控哪些指标
消息系统应该监控哪些指标
消息已经发出,订单查询页却迟迟没有更新时,单看队列深度或服务器 CPU 无法判断卡在哪里。本篇以订单事件更新查询库为例,建立覆盖生产、消费、时效、积压、失败和资源的最小指标集,并验证各项指标能否相互解释。
学习目标
- 为生产、投递和业务完成分别定义指标口径。
- 根据速率、积压、时延和错误的组合判断链路状态。
- 用一个采样窗口验证指标,并设计可复现的告警检查。
先确定消息在哪一步算完成
本例把查询库事务提交成功定义为业务完成。发送调用、Broker 发布确认、消费者收到消息和业务完成要分别计数:RabbitMQ 的发布确认与消费确认彼此独立,前者不能证明下游业务成功。([RabbitMQ][1])
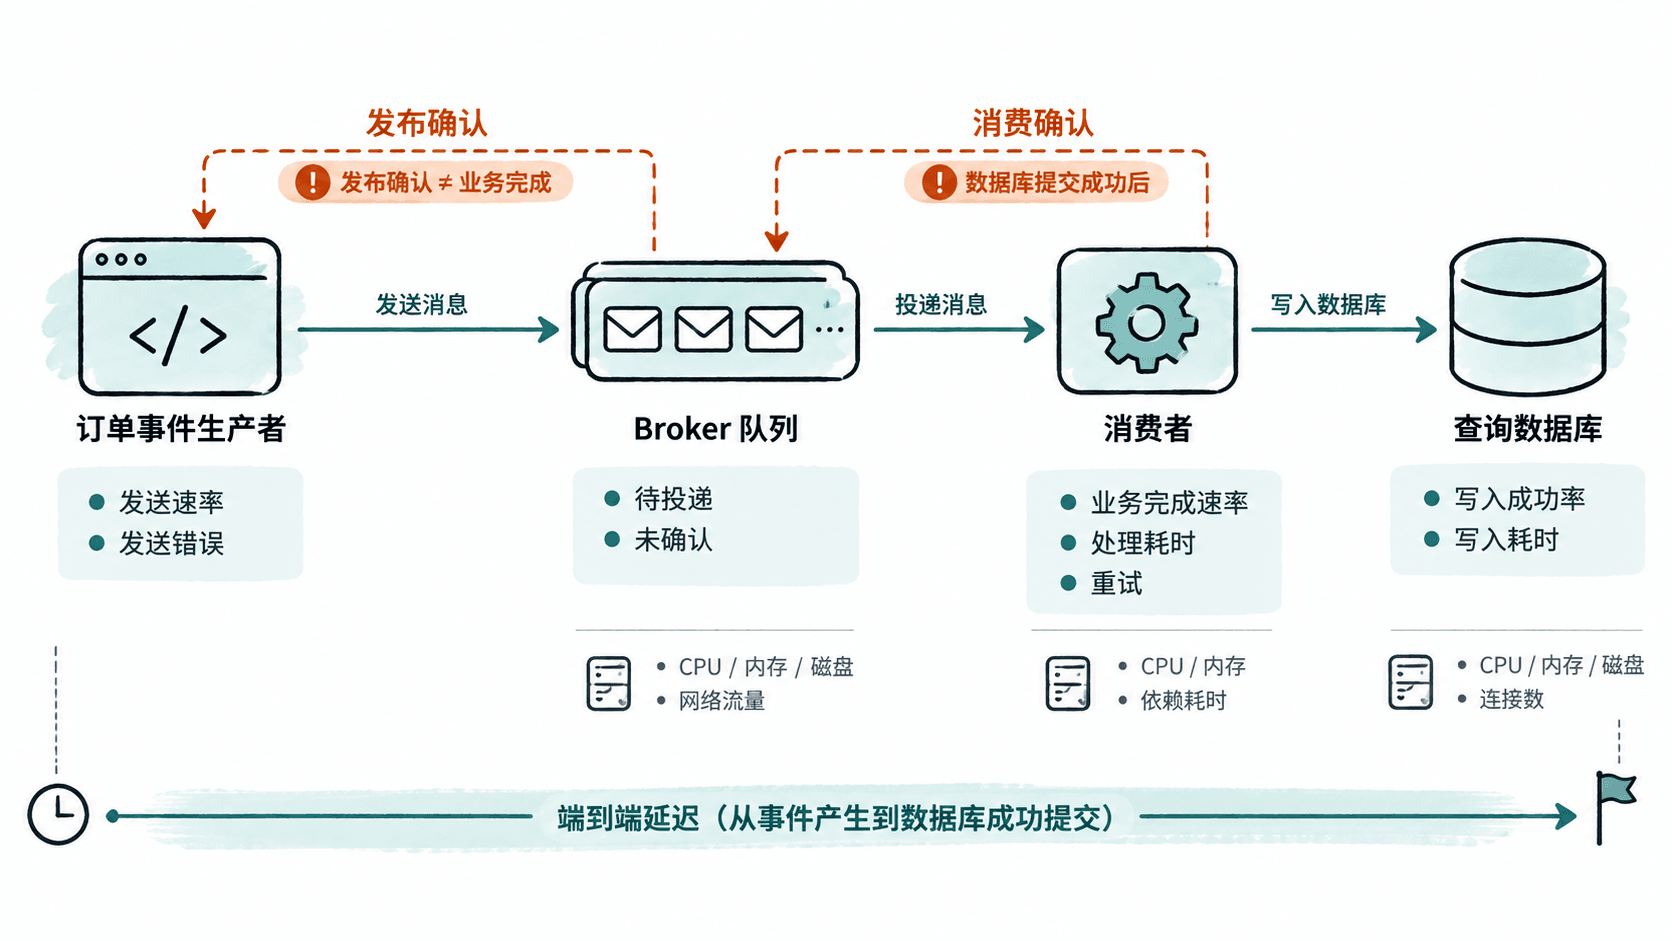
生产者负责记录发送与确认,Broker 负责记录队列状态,消费者负责记录处理结果,下游负责提供依赖耗时与资源指标。只监控 Broker,会缺少定位消费者代码或数据库变慢所需的证据。([RabbitMQ][2])
用六组指标回答六个问题
下面是本例的采集清单,不是某个产品统一提供的内置指标名称。Broker 数据、客户端指标和业务埋点需要组合使用;应用侧尤其要补齐成功、失败与处理耗时。([RabbitMQ][2])
| 指标组 | 最小采集内容 | 回答的问题 |
|---|---|---|
| 生产 | 发送尝试、确认成功、实际入队速率;消息字节数 | 消息是否持续进入目标链路? |
| 消费 | 收到速率、业务完成速率、在途数量 | 拉取之外,实际完成了多少? |
| 延迟 | 发布确认、处理、端到端耗时的 P95/P99 | 时间花在哪一段? |
| 积压 | 待投递、未确认、消费组位点差距及变化趋势 | 未完成工作是否持续增加? |
| 错误 | 发送失败、处理失败、重试、死信数量 | 故障是否被重试流量掩盖? |
| 资源 | CPU、内存、磁盘时延与余量、网络、下游连接池 | 哪一段可能达到容量边界? |
累计成功数和失败数使用计数器(Counter),面板展示窗口速率;队列深度、在途量和资源余量使用当前值(Gauge);耗时用直方图(Histogram)记录分布。这些类型不能因为都显示数字就混用。([Prometheus][3])
P95 表示约 95% 的观测耗时不超过该值。跨实例计算分位数时,应先聚合兼容的直方图数据,不能直接平均各实例的 P95;同时观察失败和未完成任务,避免只看成功样本。([Prometheus][4])
用同一窗口验证指标口径
下面是可独立运行的离线校验,不连接消息系统,字典键是教学变量而非内置指标。仅需 Python 3,将代码保存为 metrics_window.py,使用 python3 metrics_window.py 运行。所有数字都是固定样本。
def main() -> None:
    # 固定教学快照:相隔 60 秒,所有累计计数器均未重置。
    seconds = 60
    before = {"enqueued": 1000, "completed": 800, "failed": 20}
    after = {"enqueued": 1600, "completed": 1250, "failed": 70}
    delta = {key: after[key] - before[key] for key in before}
    if seconds <= 0 or any(value < 0 for value in delta.values()):
        raise ValueError("采样窗口无效或累计计数器已重置")

    # 每次结束的处理尝试只有成功或失败两种结果;重试另算尝试。
    attempts = delta["completed"] + delta["failed"]
    failure_ratio = delta["failed"] / attempts if attempts else None

    # 单队列、一进一出,样本没有重复成功、过期丢弃或死信转移。
    pending_before, pending_after = 200, 350
    expected_growth = delta["enqueued"] - delta["completed"]
    if pending_after - pending_before != expected_growth:
        raise ValueError("快照不满足本例的一进一出口径")

    print(f"入队速率={delta['enqueued'] / seconds:.1f} 条/秒")
    print(f"成功处理速率={delta['completed'] / seconds:.1f} 条/秒")
    print(f"未完成量={pending_after} 条")
    print(f"未完成量净增={expected_growth} 条")
    if failure_ratio is None:
        print("处理尝试失败率=无样本")
    else:
        print(f"处理尝试失败率={failure_ratio:.1%}")

if __name__ == "__main__":
    main()
预期输出:
入队速率=10.0 条/秒
成功处理速率=7.5 条/秒
未完成量=350 条
未完成量净增=150 条
处理尝试失败率=10.0%
这个窗口有 600 条入队、450 条成功完成,因此未完成量增加 150 条。50 次失败属于已结束的处理尝试,分母是 450 加 50,而不是入队的 600。尝试失败率不等于消息最终失败率。
这里的未完成量是业务口径,不直接等于某个 Broker 字段。有扇出、重复投递、过期或死信转移时,应补齐相应流入流出项,再核对数量;不能把主队列变短直接解释为业务成功。
样本未发生计数器重置。生产采集需要处理进程重启造成的累计值归零;Prometheus 中对计数器使用 rate() 求速率,不要对队列深度这样的 Gauge 使用它。([Prometheus][5])
把指标变成能行动的告警
假设本例要求每条事件在 60 秒内完成:消息年龄超限是业务时效异常,连续多个窗口流入快于完成是容量预警。消费速率为零时,还要确认存在待处理消息,避免把业务空闲误判为故障。
在测试环境验证两种情况,而不是只确认面板能显示数字:
- 暂停消费者再恢复,检查未完成量先增加,再随着成功处理逐步下降。
- 让下游依赖返回错误,检查失败与重试是否增加,业务完成数不能把失败尝试算进去。
指标按环境、队列或主题、消费组定位,必要时下钻分区。订单 ID、事件 ID 放进日志或追踪,不作为常规指标标签,避免时间序列随消息数量增长。([Prometheus][5])
告警还应区分“观测值为零”和“采集失败没有数据”。前者可以表示空闲,后者必须保留未知状态;恢复验收要同时看到成功处理恢复、未完成量下降和超时风险解除。