
架构与系统设计 / 系统课时
消费者频繁重平衡怎么查
消费者频繁重平衡怎么查
消费者反复加入消费组、撤销分区又重新分配,可能让业务吞吐周期性下降。本篇先收集组状态与成员变化,再区分心跳失联、轮询超时和部署变更,避免只把超时调大,最终用稳定分配与业务进度验证修复。
学习目标
- 区分正常成员调整与无计划的反复重平衡。
- 分别验证心跳会话超时、轮询间隔超时和成员变化的证据。
- 调整实际消费者的处理预算,并确认分区分配恢复稳定。
先收集状态、成员与分区分配
以下以 Kafka 4.1 Java 消费者通过 subscribe() 加入普通消费组为例,主要讨论 classic 协议的动态成员。成员加入、退出、订阅主题分区增加等情况都可能触发重新分配;排障目标是解释非计划的反复变化,而不是禁止所有重平衡。([Apache Kafka][3])
准备 Kafka 4.1 工具和已验证可用的客户端配置文件。将两处 <PATH> 分别替换为安装目录和配置文件路径,替换 <HOST>、<PORT>、<ID> 后在 Bash 中执行。连接配置沿用现场认证要求,不要为排查临时关闭认证。
脚本把状态及当前分区分配转换为短行;CURRENT-ASSIGNMENT 是 Kafka 4.1 详细成员输出中的列名。不同版本的列布局可能不同,不应盲目复制按列提取逻辑。
#!/usr/bin/env bash
set -euo pipefail
KAFKA_HOME='<PATH>'
CLIENT_CONFIG='<PATH>'
BOOTSTRAP='<HOST>:<PORT>'
GROUP='<ID>'
args=(--bootstrap-server "$BOOTSTRAP" --command-config "$CLIENT_CONFIG"
      --group "$GROUP" --describe)
# 状态与成员分别查询;它们不是同一时刻的原子快照。
for sample in 1 2 3; do
  printf 'sample=%s time=%s\n' "$sample" "$(date -u +%FT%TZ)"
  "$KAFKA_HOME/bin/kafka-consumer-groups.sh" "${args[@]}" --state |
    awk -v g="$GROUP" '$1 == g {print "state=" $(NF-1), "members=" $NF}'
  "$KAFKA_HOME/bin/kafka-consumer-groups.sh" "${args[@]}" --members --verbose |
    awk -v g="$GROUP" '
      $1 == "GROUP" {
        for (i = 1; i <= NF; i++) col[$i] = i
        next
      }
      $1 == g {
        print "member=" $(col["CONSUMER-ID"]), "client=" $(col["CLIENT-ID"])
        print "partitions=" $(col["#PARTITIONS"]), "assignment=" $(col["CURRENT-ASSIGNMENT"])
      }'
  # 间隔采样用于发现变化,短暂重平衡仍可能被漏过。
  if [ "$sample" -lt 3 ]; then sleep 10; fi
done
预期输出格式如下,其中只展示一轮稳定状态的示例。实际时间、成员标识、客户端名称和分区分配可能不同;不同成员的 <ID> 应是不同的现场值。
sample=1 time=<TIME>
state=Stable members=2
member=<ID> client=worker-a
partitions=1 assignment=orders:0
member=<ID> client=worker-b
partitions=1 assignment=orders:1
对照实际快照中的成员身份和分区归属,并关联同一时间窗的消费者日志、进程重启记录和发布记录。成员数量不变不代表成员没换;一次看到 Stable,也不能证明两次采样之间没有发生重平衡。
分开检查心跳和轮询两个时钟
在 classic 协议下,三个参数分别控制不同的约束。先核对运行中消费者真正加载的配置,不要只检查仓库里的配置文件。([Apache Kafka][5])
| 参数 | 判断的事情 |
|---|---|
heartbeat.interval.ms |
心跳发送间隔,应低于会话超时,通常不超过其三分之一 |
session.timeout.ms |
协调器多久收不到心跳后判定成员失联 |
max.poll.interval.ms |
应用两次调用 poll() 的最大间隔 |
Java 消费者可以在后台发送心跳,因此业务批次处理过慢时,心跳一度正常也不能证明消费正常。动态成员超过轮询间隔上限后会主动离组;随后重新轮询又重新加入,可能形成反复分配。([Apache Wiki][6])
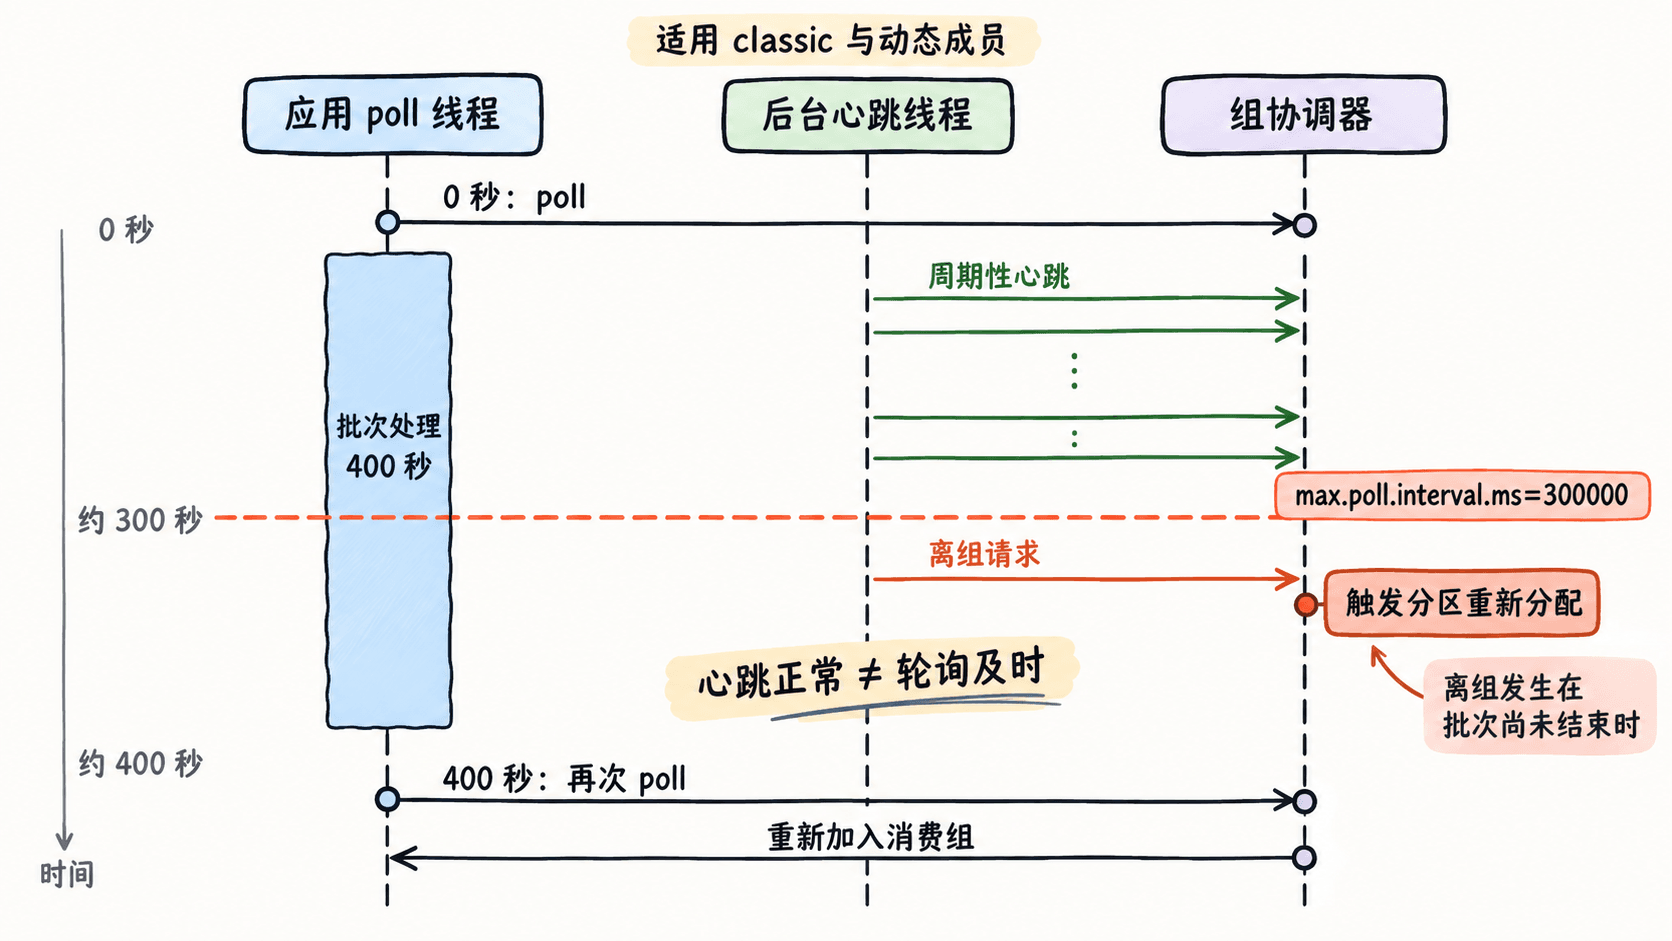
如果配置了 group.instance.id,成员是静态成员:超过轮询间隔后,分区不会立即转移,而要等待相应会话超时。静态身份并不能修复业务线程卡住的问题。([Apache Kafka][5])
如果实际使用 group.protocol=consumer,心跳间隔和会话超时由服务端控制,相关配置为 group.consumer.heartbeat.interval.ms、group.consumer.session.timeout.ms。不要继续调整客户端的两个 classic 参数;max.poll.interval.ms 仍需检查。([Apache Kafka][7])
沿时间线寻找最先发生的异常
先找异常前因,再解释离组、重新分配和提交失败。成员标识变化可能只是超时离组的结果;没有重启证据时,不能直接认定是容器在反复重启。
| 最先观察到的证据 | 优先验证的方向 |
|---|---|
| 轮询间隔超过上限,此前心跳正常 | 批次业务、无界重试或回调阻塞 |
| 心跳中断并伴随连接异常或长暂停 | 网络、协调器负载、垃圾回收及 CPU 调度 |
| 重启、扩缩容或健康检查失败先发生 | 部署策略、资源限制及进程退出原因 |
| 订阅或分区变化与重新分配同步 | 元数据变化,而非单纯处理超时 |
| 重平衡次数不多,但每次耗时很长 | 撤销、分配回调及状态恢复过程 |
可用 time-between-poll-max 核对轮询间隔,用 rebalance-total 和 rebalance-latency-max 判断频率与耗时,并检查分区撤销、分配回调的耗时。它们是消费者实例指标;实例重启会影响计数,多个成员参与同一次重平衡也不能算成多个独立组事件。([Apache Kafka][2])
CommitFailedException 可以是轮询超时、成员已失去分区后的表现。它提供了追查方向,却不足以单独证明心跳超时;不要在不确认分区所有权的情况下无限重试提交。([Apache Kafka][3])
缩小处理预算,而不是只放大超时
假设一个消费者每轮串行处理 500 条,每条耗时固定为 0.8 秒,仅处理就需要 400 秒。若轮询间隔上限为 300 秒,这一批无法按时完成。先减少每轮记录数,同时给下游调用、重试和提交设置可控的时间预算。
下面是片段示例:合并到应用实际加载的 Kafka Consumer 配置中,前提是该消费者已经使用 classic,且连接、反序列化及提交逻辑已经配置完成。它不是完整的应用配置,也不应写入上面仅供查询使用的客户端文件。
# 仅用于已经采用 classic 的消费者,不在故障中临时切换协议。
group.protocol=classic
# 缩小 poll 返回的记录数,保留原有提交语义。
max.poll.records=100
max.poll.interval.ms=300000
预期结果:应用重新创建消费者并加载配置后,一次 poll() 最多返回 100 条记录。在上述固定耗时假设下,业务处理部分降为约 80 秒;还必须加上重试、提交和其他开销,再验证实测轮询间隔具有余量。该参数不等于底层每次网络拉取最多 100 条。([Apache Kafka][5])
真实请求存在长尾,不能用平均单条耗时保证永不超时。若确需提高 max.poll.interval.ms,应以压测和故障注入得到的完整轮询间隔为依据,并接受更慢的失去进展检测;不要把无界等待包装成正常长任务。([Apache Wiki][6])
验收分配稳定和业务进度
先确认所有应消费的分区都有合理归属。某个成员没有分区,不一定是重平衡失败:成员数超过可分配分区数、订阅范围不同,都需要结合实际分配解释,不能只看进程是否存活。([Apache Kafka][1])
需要降低正常部署的扰动时,可另行评估静态成员和协作式分配。静态成员要求实例身份稳定且组内唯一;协作式分配减少不必要的分区撤销,但二者都不能消除网络故障或处理超时,不能代替前面的根因修复。([Apache Wiki][8])
修复后至少观察覆盖原有数个故障周期,并验证一次受控发布:非计划的重平衡不再反复出现,轮询间隔留有余量,分区持续推进,提交异常不再持续发生,业务积压开始下降。发布触发的正常调整应能及时收敛,而不是要求重平衡计数永远为零。