
架构与系统设计 / 系统课时
RabbitMQ 适合哪些消息模型
RabbitMQ 适合哪些消息模型
订单确认后,发票与通知都要收到事件,而发票服务的多个实例只需分担任务。这两种“多个消费者”并不是一回事。本篇把路由、队列和确认拆开,用一次发布进入两条队列的实验,判断 RabbitMQ 是否符合业务要求。
学习目标
- 区分工作队列与发布订阅,避免多个业务错误地竞争同一队列。
- 根据匹配规则选择 Exchange,并区分发布确认与消费确认。
- 验证一条事件进入两条独立队列,并完成手动确认。
先区分各收一份与共同分工
本文聚焦 AMQP 0-9-1 的队列模型。生产者把消息发给 Exchange,Exchange 按绑定规则路由到 Queue,消费者从队列取消息。Exchange 负责路由,不是等待未来订阅者重读的历史消息仓库。([RabbitMQ][7])
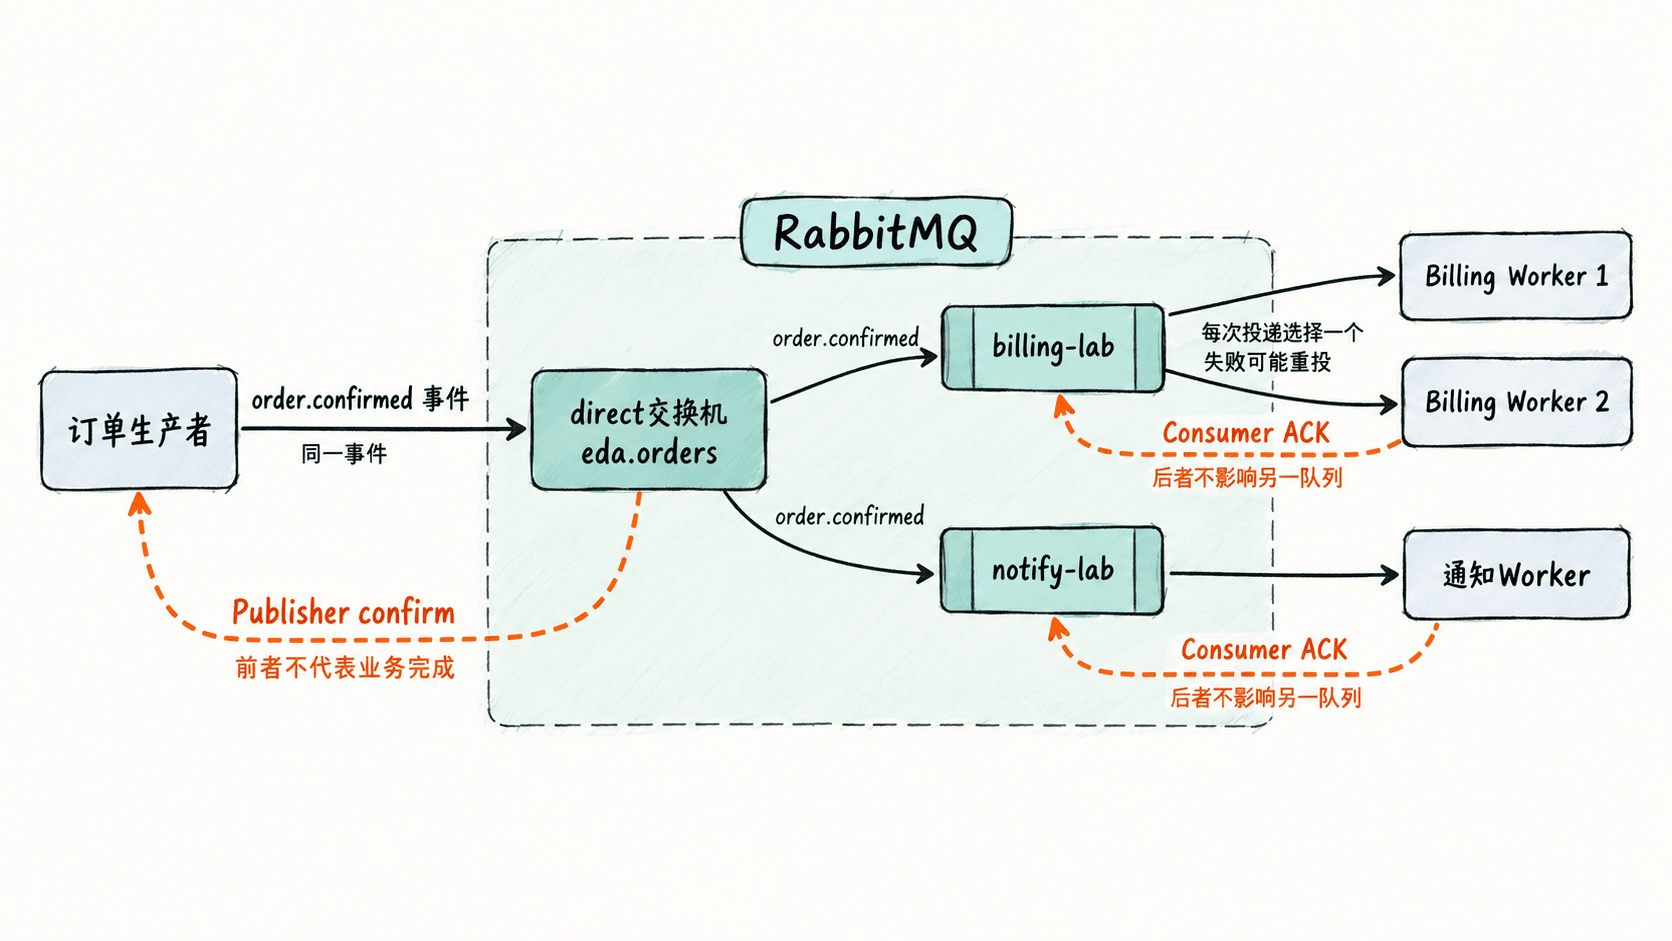
工作队列让多个实例竞争同一队列,每次投递只交给其中一个实例;发布订阅则为每个独立业务建立队列。因此发票与通知应各有队列,发票服务的多个实例再共同消费发票队列。失败重投仍可能造成重复处理。([RabbitMQ][8])
按匹配规则选择 Exchange
不要先背交换机名称,再寻找使用理由。先确定接收者由什么条件决定:精确业务类型、层级模式,还是所有绑定方。常用模型如下。([RabbitMQ][7])
| 类型 | 匹配方式 | 适合的需求 |
|---|---|---|
direct |
路由键精确相等 | 按任务类型投递 |
topic |
路由键按点分段匹配,* 匹配一段,# 匹配零段或多段 |
订阅 order.* 或 order.# |
fanout |
向所有绑定队列投递,忽略路由键 | 每个订阅业务各收一份 |
direct 不等于“只能发给一个队列”。两个队列绑定相同路由键,就会各获得一份。这里比较的是路由规则,不是强制把一种 Exchange 对应成一种消费者部署方式。([RabbitMQ][7])
两种确认保护不同环节
Publisher confirm 是 Broker 对发布者的确认,表示已满足相应接收条件,不代表业务处理完成。无法路由的消息也可能收到发布确认,因此应结合 mandatory=True 和退回处理,识别没有匹配队列的情况。([RabbitMQ][9])
Consumer ACK 是消费者向 Broker 确认处理完成;对普通队列,Broker 收到确认后可移除该队列中的消息。连接断开时,未确认消息可能重新投递,所以真实业务应在事务提交后确认,并具备幂等能力。([RabbitMQ][9])
需要节点故障容错时,应评估部署在多节点上的 Quorum Queue。队列持久化、消息持久化与复制并非同一件事;单节点即使声明 Quorum Queue,也没有额外节点替它承受故障。([RabbitMQ][10])
观察一次发布进入两条队列
准备 Linux、macOS 或 WSL 的 Bash、Docker,以及支持 venv 的 Python 3.10 以上版本。确保本机 5672 端口和容器名未被占用;下面固定使用 RabbitMQ 4.3.6 与 Pika 1.3.2。([Docker Hub][11])
set -e

# 依赖放入独立环境,避免污染系统 Python。
python3 -m venv .venv-rabbit
.venv-rabbit/bin/python -m pip install -q "pika==1.3.2"

# 仅监听本机;这个明文账号只用于临时实验。
docker run -d --name eda-rabbit-lab --hostname eda-rabbit-lab \
  -p 127.0.0.1:5672:5672 \
  -e RABBITMQ_DEFAULT_USER=eda \
  -e RABBITMQ_DEFAULT_PASS=local-demo-only \
  rabbitmq:4.3.6
预期输出:忽略首次拉取镜像和安装依赖的提示,最后一行是容器 ID;实际值会不同。
<ID>将下面完整代码保存为 rabbit-routing-lab.py,执行 .venv-rabbit/bin/python rabbit-routing-lab.py。连接配置允许 Broker 启动期间重试;两个队列应保持实验专用,不接入其他生产者或消费者。
import json
import pika

def main() -> None:
    # 启动期间允许重试连接;不等同于运行期自动恢复。
    params = pika.ConnectionParameters(
        host="127.0.0.1", port=5672,
        credentials=pika.PlainCredentials("eda", "local-demo-only"),
        connection_attempts=30, retry_delay=2,
        blocked_connection_timeout=10,
    )
    connection = pika.BlockingConnection(params)
    try:
        channel = connection.channel()
        channel.exchange_declare(
            exchange="eda.orders", exchange_type="direct", durable=True
        )
        queues = ("billing-lab", "notify-lab")
        for queue in queues:
            # 两条独立队列绑定同一个精确路由键,各接收一份。
            channel.queue_declare(
                queue=queue, durable=True,
                arguments={"x-queue-type": "quorum"},
            )
            channel.queue_bind(
                queue=queue, exchange="eda.orders",
                routing_key="order.confirmed",
            )

        # Confirm 配合 mandatory,避免把无法路由误判为发送成功。
        channel.confirm_delivery()
        event = {"eventId": "demo-1", "type": "OrderConfirmed"}
        channel.basic_publish(
            exchange="eda.orders", routing_key="order.confirmed",
            body=json.dumps(event).encode("utf-8"),
            properties=pika.BasicProperties(
                delivery_mode=2, content_type="application/json"
            ),
            mandatory=True,
        )
        print("publisher=confirmed")

        for queue in queues:
            method, _, body = channel.basic_get(queue=queue, auto_ack=False)
            if method is None or body is None:
                raise RuntimeError(f"{queue}: expected one message")
            received = json.loads(body)
            # 打印仅模拟业务处理;真实系统应在业务提交成功后 ACK。
            print(f"{queue}: {received['type']} {received['eventId']}")
            channel.basic_ack(delivery_tag=method.delivery_tag)
    finally:
        if connection.is_open:
            connection.close()

if __name__ == "__main__":
    main()
预期输出:
publisher=confirmed
billing-lab: OrderConfirmed demo-1
notify-lab: OrderConfirmed demo-1
一次发布让两个业务队列各获得一份;确认发票队列中的消息不会替通知队列确认。这里用 basic_get 做同步验证,并非持续消费方案;本例开启确认和 mandatory 后,无法路由会触发异常,而不是输出发布成功。([Pika][12])
完成验证后删除实验容器及临时数据。单节点和演示账号都不应直接用于生产环境。
# 删除本实验容器及其匿名数据卷,不操作其他容器。
docker rm -fv eda-rabbit-lab
预期输出:
eda-rabbit-lab工作队列需要补齐的边界
持续工作进程通常使用 basic_consume。配合手动确认,basic_qos(prefetch_count=1) 可限制每个消费者最多持有一条未确认消息,避免慢消费者预取过多;它不限制消息处理耗时,也不是全局限速器。([RabbitMQ][8])
失败应有重试上限和明确的失败去向,避免立即重新入队形成忙循环。还要监控待投递、未确认数量和最老任务等待时间;队列先入先出,也不等于多个工作进程按同样顺序完成业务。([RabbitMQ][9])
据此,灵活路由、任务分工和处理后确认,是优先评估 RabbitMQ 队列的理由。大量历史回放则应另外比较 Kafka 与 RabbitMQ Streams;Streams 支持非破坏性读取,不能把队列消费后删除概括成“RabbitMQ 完全不能回放”。([RabbitMQ][13])