
架构与系统设计 / 系统课时
消息积压时先扩哪里
消息积压时先扩哪里
队列越来越长时,盲目增加消费者可能只会让数据库更忙。本篇用生产速率、成功处理速率和下游容量建立排查顺序,通过一段容量计算脚本,判断该扩消费者、调整并行度、扩消息中间件,还是先限流止损。
学习目标
- 区分消息拉取速率、成功处理速率与积压增长速率。
- 根据资源和并行度证据选择扩容位置。
- 计算消化积压所需的吞吐,并设置扩容停止条件。
先统一积压和速率的口径
先选定同一队列或同一消费组,在相同时间窗口记录新消息进入速率 、业务成功处理速率 、未完成消息数 和最老未完成消息的年龄。成功处理应以业务结果持久化为准,重试次数不能当成新增业务吞吐。
RabbitMQ 要同时看 messages_ready 和 messages_unacknowledged:前者下降、后者上升,可能只是消息转移到了消费者。Kafka 的提交位点也不天然等于业务完成位置,提前提交会掩盖未完成工作。([RabbitMQ][1])
在消息没有丢弃、重复计数且速率近似稳定的条件下,每秒积压增加 。消费速率等于生产速率只能止住增长,不能清掉旧积压;只有 才有净消化能力。这是数量守恒,不需要先猜该增加多少实例。
沿证据选择扩容位置
先排除消费者退出、鉴权失败和确定性坏消息,再检查资源瓶颈。下面是需要用指标验证的排查假设,不是看到某个 CPU 百分比就自动扩容的规则;应同时观察消息中间件(Broker)、应用和依赖服务。([RabbitMQ][1])
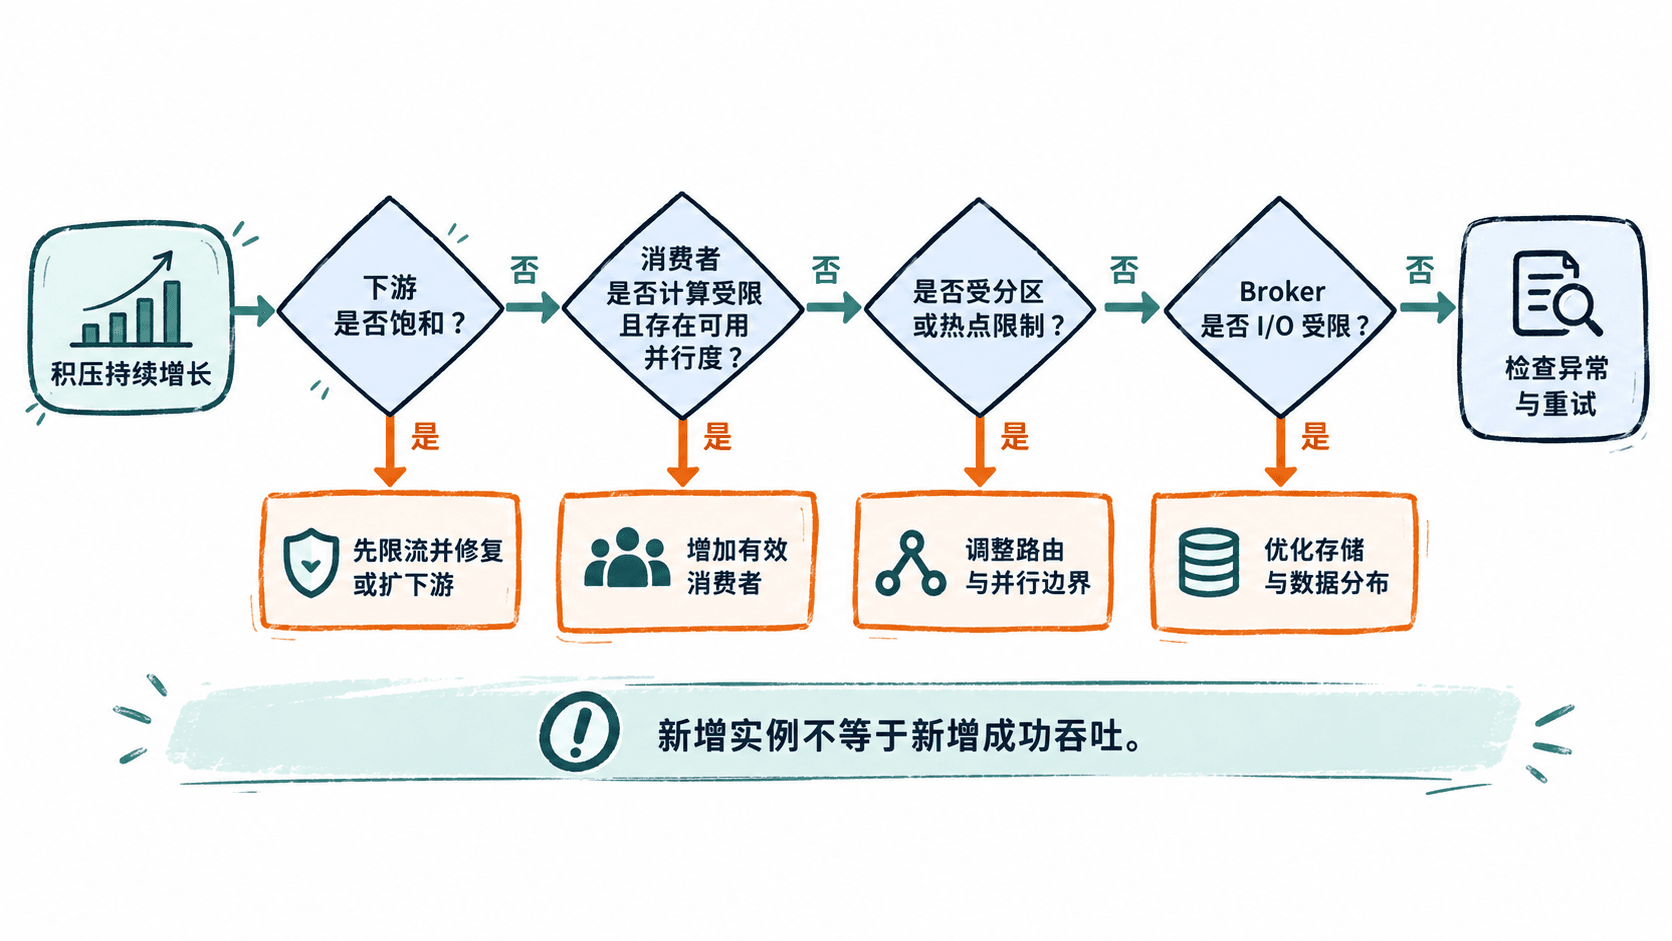
| 组合证据 | 优先动作 |
|---|---|
| 消费者计算繁忙,下游健康且仍有并行空间 | 增加消费者,或优化单条消息的计算成本 |
| 消费者多在等待,下游延迟、锁等待或超时升高 | 先限制消费并发,优化慢操作,再评估下游扩容 |
| 少数分区持续积压,其他消费者空闲 | 排查热点键和串行约束,调整路由与并行边界 |
| Broker 磁盘或网络受限,消费者取数跟不上 | 先定位存储和数据分布问题,再扩 Broker 资源 |
对于按分区分配的 Kafka 普通消费组,同一分区只分配给组内一个消费者;单主题只有 8 个分区时,增加到 12 个消费者不会得到 12 路分区消费。这里不讨论共享组等其他消费模型。([Apache Kafka][2])
RabbitMQ 启用单活消费者时,备用消费者也不会同时处理队列。增加进程数之前,应确认新增实例真的获得工作,而不是只让监控中的实例数量变大。([RabbitMQ][3])
用容量预算排除无效扩容
下面使用固定教学数据:已有 180000 条积压,生产速率为 600 条/秒;单个有效消费者最多处理 100 条/秒,可用并行槽为 8。假设 Broker 容量充足、消息分布均匀,每条消息需要两次下游操作。
下游分给这条链路的安全预算为 900 次操作/秒,因此折算后最多支持 450 条消息/秒。端到端容量取消费者能力与下游折算能力的较小值,不能把两端吞吐相加。
将下面完整脚本保存为 capacity_check.py,使用 Python 3.11 或以上版本执行 python capacity_check.py。它只做容量估算,不连接线上集群。
from math import ceil

BACKLOG = 180_000
PARALLEL_SLOTS = 8
PER_WORKER = 100
OPS_PER_MESSAGE = 2

def report(label: str, incoming: int, workers: int, downstream_ops: int) -> None:
    # 并行槽限制有效消费者数,下游预算需要换算成消息数。
    worker_capacity = min(workers, PARALLEL_SLOTS) * PER_WORKER
    capacity = min(worker_capacity, downstream_ops / OPS_PER_MESSAGE)
    net = capacity - incoming
    print(f"{label}: capacity={capacity:.0f}/s, net={net:+.0f}/s")
    # 只有净消化量为正,才能在持续生产时排空旧积压。
    if net > 0:
        print(f"drain_seconds={ceil(BACKLOG / net)}")
    else:
        print("drain_seconds=unreachable")

def main() -> None:
    # 每项依次为标签、生产速率、消费者数、下游安全操作预算。
    cases = [
        ("current", 600, 4, 900),
        ("consumers_only", 600, 8, 900),
        ("both_layers", 600, 8, 1800),
        ("limit_intake", 300, 4, 900),
    ]
    for case in cases:
        report(*case)

if __name__ == "__main__":
    main()
预期输出:
current: capacity=400/s, net=-200/s
drain_seconds=unreachable
consumers_only: capacity=450/s, net=-150/s
drain_seconds=unreachable
both_layers: capacity=800/s, net=+200/s
drain_seconds=900
limit_intake: capacity=400/s, net=+100/s
drain_seconds=1800
net 表示每秒净消化量,负值说明积压还在增长。只扩消费者时,容量仍被下游卡在 450 条/秒;同时提高下游安全预算并扩消费者,模型才得到 800 条/秒的处理能力。
当 时,排空时间的理想估算为 。第三种方案得到 900 秒;第四种方案不扩容,而把实际进入队列的流量降到 300 条/秒,得到 1800 秒。限流必须作用于准入或生产端,不能靠静默删除已受理消息来制造下降。
这里的容量是预算上限,不是扩容承诺。单实例能力、下游安全预算都应重新测量,不能按节点数线性外推;锁竞争、重试和消费组再均衡可能让实际吞吐更低。([Apache Kafka][2])
用净消化速度验收扩容
- 记录变更前的成功吞吐、积压增长率和下游延迟,每轮只调整一个主要变量,给新实例留出启动与分配工作的观察窗口。
- 确认成功吞吐持续高于生产速率,积压及最老消息年龄逐步下降,同时下游错误率、连接等待和延迟没有恶化。
- 新实例没有工作、成功吞吐不升,或下游错误增加时,停止继续扩容,回退本轮并发调整并保留必要的入口限流。
还要比较扩容生效与排空耗时、消息保留期限及剩余存储容量。若缓存撑不到恢复完成,应先减少尚未受理的工作,而不是继续无限接收。扩容的目标是提升端到端成功吞吐,不是把积压搬到消费者内存或数据库连接池。([Microsoft Learn][4])