
架构与系统设计 / 系统课时
重试次数和退避怎么设计
重试次数和退避怎么设计
消费者调用下游失败后,立即重试可能恢复服务,也可能把短暂拥堵放大成持续故障。本篇用错误分类、次数上限和带抖动的退避策略,设计一套能停止、能验证、不会无限回队的重试规则。
学习目标
- 按错误性质选择停止、立即重试或延迟重试。
- 明确总尝试次数、单次超时和累计时间预算的关系。
- 用可运行示例验证退避、恢复提示与停止条件。
先判断再试一次是否可能成功
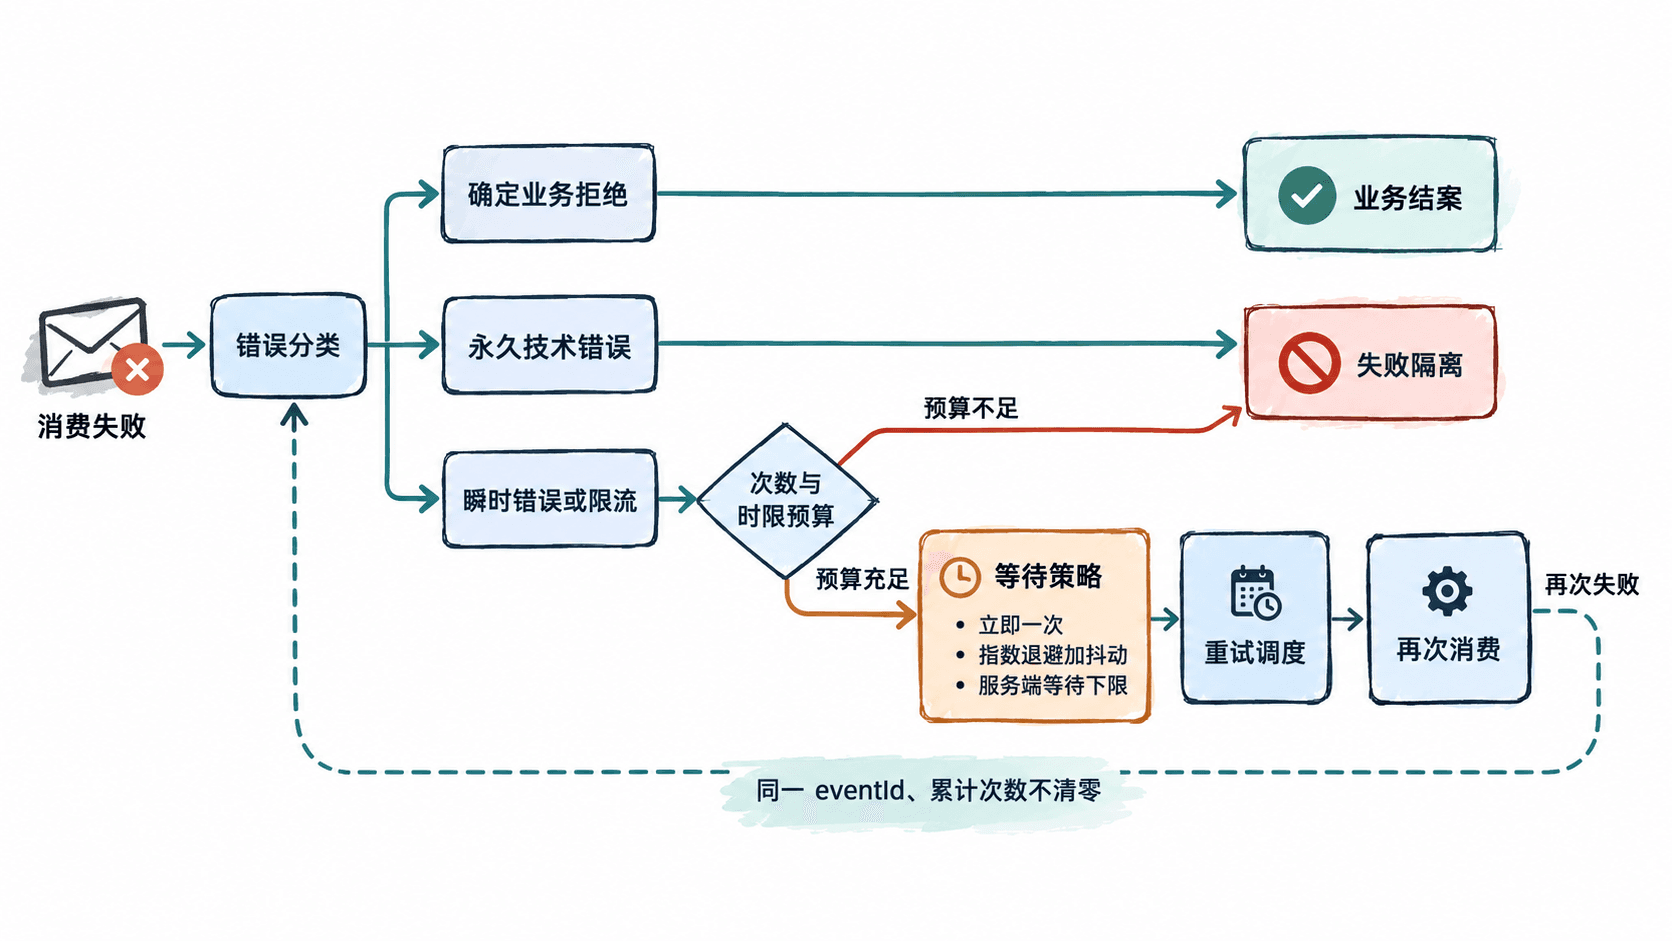
重试适合短暂故障,不适合靠重复执行修复无效输入。错误分类应结合接口契约与失败阶段,而不是捕获所有异常后统一循环。下面给出一组可用于消费者的设计起点。([Microsoft Learn][1])
| 失败情况 | 建议策略 | 必须满足的条件 |
|---|---|---|
| 明确未发出请求的偶发连接故障 | 可选立即重试一次 | 操作可安全重复,且仍有预算 |
| 短暂不可用、资源争用 | 指数退避并加入抖动 | 故障可能自行恢复 |
| 限流、明确的恢复窗口 | 按恢复提示延迟重试 | 不早于服务端建议时间 |
| 坏格式、缺少必填字段 | 隔离并告警 | 修复之前不重复提交 |
| 确定的业务拒绝 | 按业务规则结案或补偿 | 不把业务结果当作技术故障 |
网络超时只表示调用方没有及时拿到结果,不证明对端没有完成操作。涉及扣款、扣库存等副作用时,应先用稳定的业务幂等键保证重复调用不会重复生效,再讨论重试次数。([Amazon Web Services, Inc.][2])
把次数、时限和等待一起设定
先消除计数歧义:本篇的 总尝试次数为 4,包含首次处理,因此最多追加 3 次重试。示例采用单次调用超时 2 秒、总预算 20 秒、初始退避 1 秒、退避上限 8 秒。这些是演练值,不是中间件默认配置。
指数退避让等待上限逐次翻倍,本例前三次失败对应 1、2、4 秒。全抖动是在零到当前上限之间随机取值,避免消费者在同一时刻集中重试;固定等待和没有抖动的指数退避都可能保留请求峰值。([Amazon Web Services, Inc.][3])
不含服务端额外等待时,三次最大退避合计 7 秒,四次调用按超时上限计算合计 8 秒,共 15 秒。剩余预算用于调度与交接;每次排程前仍要检查实际累计耗时,不能仅靠预先相加保证不超时。
HTTP 的 Retry-After 可以表示等待秒数或一个日期。建议将合法值换算为剩余等待秒数,作为下限,再加非负抖动;本地退避上限不能用来截短服务端的等待要求。等待后已无执行预算时,应停止本轮自动处理。([RFC 编辑器][4])
运行一个确定可复现的策略演练
以下代码使用 Python 3.11 或更新版本的标准库,可直接保存为 retry_demo.py,通过 python retry_demo.py 运行。它模拟两次失败后成功,不连接真实服务,也不实际等待;固定随机种子让输出可核对。
from random import Random

MAX_ATTEMPTS = 4
TOTAL_BUDGET_S = 20.0
CALL_TIMEOUT_S = 2.0
BASE_S, CAP_S = 1.0, 8.0

def decide(kind: str, attempt: int, elapsed_s: float,
           rng: Random, retry_after_s: float = 0.0) -> tuple[str, float]:
    # attempt 包含刚刚失败的首次调用;未分类错误不自动重试。
    if attempt < 1 or elapsed_s < 0 or retry_after_s < 0:
        raise ValueError("invalid retry state")
    if kind not in {"transient", "rate_limit"}:
        return "isolate", 0.0
    if attempt >= MAX_ATTEMPTS:
        return "exhausted", 0.0

    upper = min(CAP_S, BASE_S * 2 ** (attempt - 1))
    # 恢复提示是等待下限;抖动只向后增加,不能提前请求。
    delay = retry_after_s + rng.uniform(0.0, upper)
    if elapsed_s + delay + CALL_TIMEOUT_S > TOTAL_BUDGET_S:
        return "expired", 0.0
    return "retry", delay

def main() -> None:
    rng = Random(7)  # 固定种子只用于复现测试,生产实例不要共用它。
    elapsed_s = 0.0
    outcomes = [("transient", 0.0), ("rate_limit", 2.0), ("ok", 0.0)]

    for attempt, (kind, hint) in enumerate(outcomes, start=1):
        elapsed_s += 0.2  # 模拟调用耗时;此程序不联网,也不实际等待。
        if kind == "ok":
            print(f"attempt={attempt} result=ok")
            break
        action, delay = decide(kind, attempt, elapsed_s, rng, hint)
        print(f"attempt={attempt} action={action} delay={delay:.2f}s")
        if action != "retry":
            break
        elapsed_s += delay

    # 分别覆盖永久错误、次数耗尽和时间预算耗尽。
    assert decide("permanent", 1, 0.0, rng)[0] == "isolate"
    assert decide("transient", 4, 0.0, rng)[0] == "exhausted"
    assert decide("rate_limit", 1, 19.0, rng, 3.0)[0] == "expired"
    print("boundary_checks=passed")

if __name__ == "__main__":
    main()
预期输出:
attempt=1 action=retry delay=0.32s
attempt=2 action=retry delay=2.30s
attempt=3 result=ok
boundary_checks=passed
第二次等待由服务端提示的 2 秒加约 0.30 秒抖动组成,并不是把等待上限固定为 2 秒。三个断言分别验证永久错误不重试、第四次失败后停止,以及剩余时间不足时不再排程。
业务拒绝应在外层按业务结果处理,不交给此函数。示例默认关闭立即重试;只有明确适合的错误才额外放行一次,而且仍计入同一个总次数上限。
decide 只负责决策,不能中断真实阻塞调用;接入网络客户端时还必须落实单次超时和整体截止时间。固定随机种子只用于测试,生产实例应独立产生随机等待,避免再次同步。
让延迟消息等待,而不是占住消费者
建议把较长等待交给具有持久化能力的延迟队列或重试调度器,不要在持有事务、锁或有限工作线程时长时间休眠。若使用重试主题,需要明确谁检查到期时间,不能仅凭主题名称假定它具有定时投递能力。
应用自行转投时,应先确认目标路由成功并收到符合可靠性要求的发布确认,再确认原投递。两步之间崩溃仍可能导致重复,因此不能把这个交接当成跨队列原子事务;发布确认与消费确认也是两类独立机制。([RabbitMQ][5])
建议将累计尝试次数、首次失败时间和绝对截止时间随重试记录保存,避免重启或换队列后清零。进程内用单调时钟计算耗时,跨进程使用可共享的截止时间,并在每次真正执行前再次检查消息是否已经失去业务时效。
用整体负载判断是否该继续重试
避免在客户端、消费者和调度器三层分别设置互不知情的完整重试循环。若每层最多尝试 3 次,嵌套最坏情况可能触发 27 次最底层调用;应选择一层统筹,或让各层共享同一总预算。([Microsoft Learn][1])
上线前建议至少验证:持续失败不会超过次数上限;限流提示不会被提前执行;进程重启不会刷新预算。同时观察每条事件的调用次数、重试后成功率、等待积压和最终隔离量,而不只看某一次请求是否成功。
当大量消息同时遭遇同一种依赖故障时,应先限流、限制并发或暂停相关消费入口,待探测恢复后逐步放行。重试的目标是利用恢复机会,不是用更多请求证明依赖仍然不可用。([Microsoft Learn][1])