
架构与系统设计 / 系统课时
编舞模式什么时候会失控
编舞模式什么时候会失控
服务互不直接调用,并不意味着流程已经解耦。一笔订单仍可能卡在隐蔽的前置条件里,或被补偿事件反复启动。本篇用一个失败链路实验,判断编舞是在保持服务自治,还是在隐藏难以维护的流程。
学习目标
- 识别事件订阅背后的业务顺序与隐式依赖。
- 区分重复投递和不断产生新事件的业务反馈环。
- 根据流程证据判断应该局部修复,还是提取协调职责。
编舞分散的是决策,不是业务约束
编舞模式让各服务收到事件后,自行决定本地动作,再发布结果事件。消息代理负责传递消息,不承担“整个业务下一步该做什么”的决策;流程规则分散在参与者中。([Microsoft Learn][1])
例如,订单确认后,邮件服务发通知、统计服务更新报表,两者可以独立工作。但“库存预留成功后才能付款”包含顺序约束:支付服务虽然不直接调用库存服务,仍依赖库存事件的含义与产生条件。
评审新增订阅时,问清哪些服务必须一起修改等待条件和失败处理。若答案涉及多个参与者,说明调用依赖减少了,流程依赖却没有消失,维护成本仍会随协作关系增加。([AWS 文档][2])
失败事件怎样绕回起点
假设订单先预留库存,付款被明确拒绝后取消订单,再释放库存。现在误加一条订阅规则:“收到库存释放事件,就重新下单。”补偿本来用于收敛失败,却成了新一轮业务的入口。
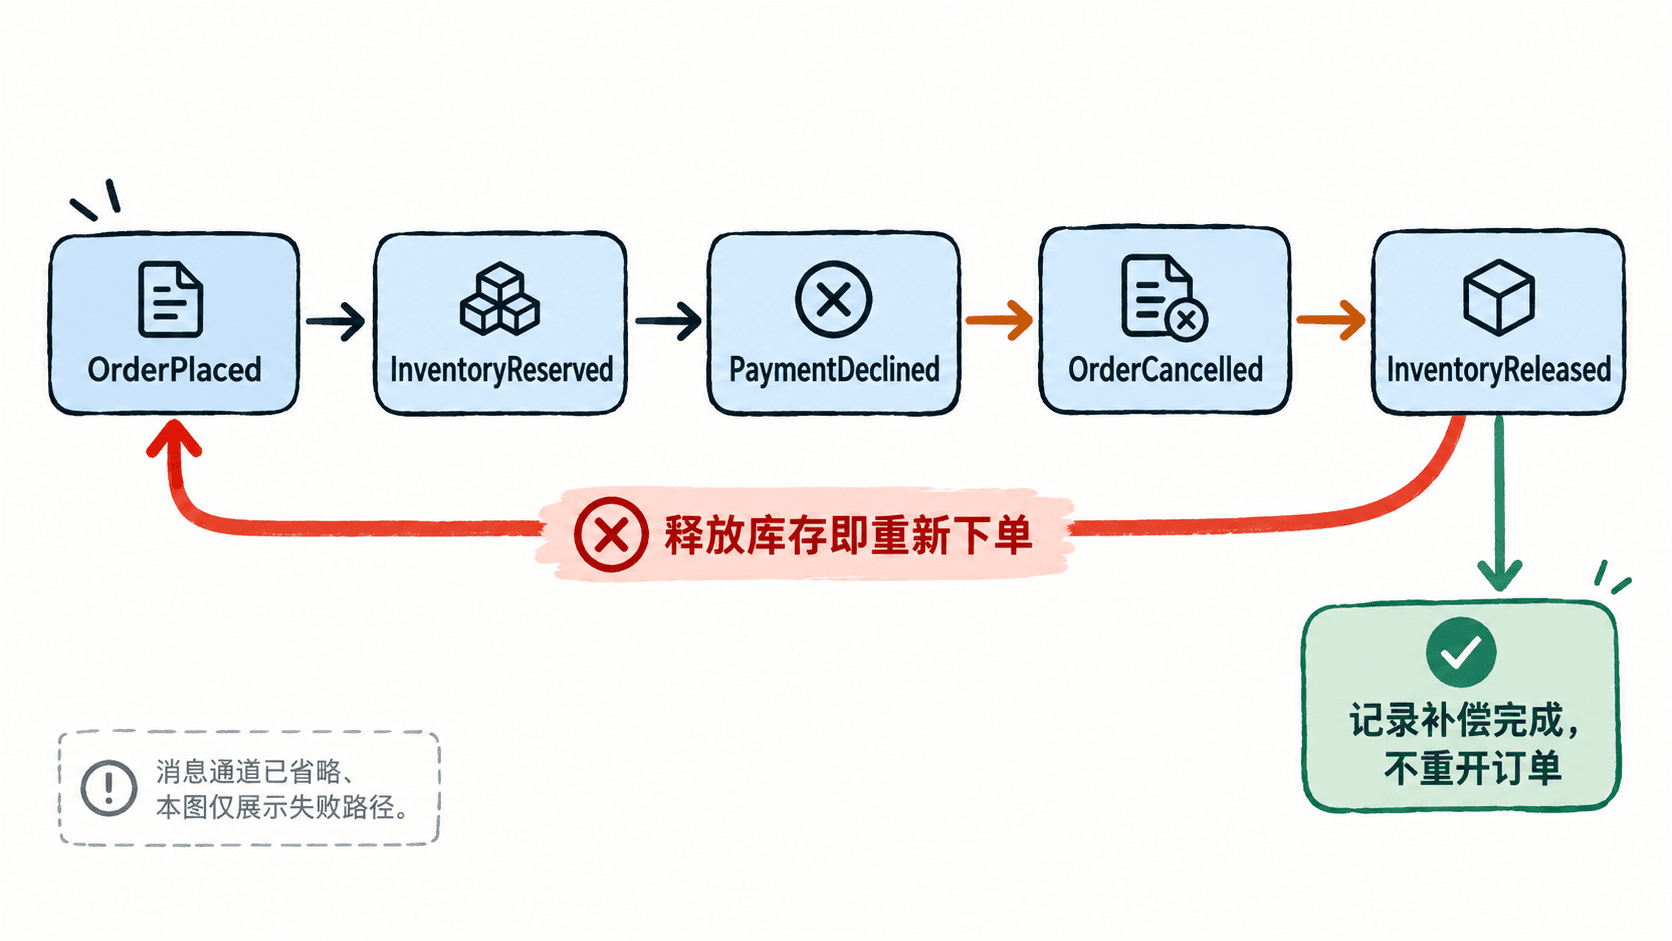
这里的问题不只是重复收到同一条消息:即使每次发布都生成新的 eventId,错误规则仍然成立。消息去重不会自动消除这种业务反馈环;需要检查触发条件及允许的状态迁移。事件拓扑中的反馈环也是事件风暴的一种来源。([Microsoft Learn][1])
用一个内存实验看清回边
下面是可独立运行的 Python 3 实验。保存为 choreography_demo.py,执行 python choreography_demo.py。字典只是集中展示分散的订阅规则,并不代表真实消息代理或生产编排器。
def simulate(reopen: bool) -> None:
    # 只模拟失败链:每次付款都得到明确的拒绝结果。
    routes = {
        "OrderPlaced": "InventoryReserved",
        "InventoryReserved": "PaymentDeclined",
        "PaymentDeclined": "OrderCancelled",
        "OrderCancelled": "InventoryReleased",
    }
    if reopen:
        # 错误规则:把补偿完成当成重新下单的授权。
        routes["InventoryReleased"] = "OrderPlaced"

    event = "OrderPlaced"
    # 限制实验长度,避免错误规则让程序无限运行。
    for step in range(1, 7):
        print(f"{step}: {event}")
        next_event = routes.get(event)
        if next_event is None:
            print("END")
            return
        event = next_event
    print("LIMIT_REACHED")

if __name__ == "__main__":
    print("UNSAFE")
    simulate(reopen=True)
    print("FIXED")
    simulate(reopen=False)
预期输出:
UNSAFE
1: OrderPlaced
2: InventoryReserved
3: PaymentDeclined
4: OrderCancelled
5: InventoryReleased
6: OrderPlaced
LIMIT_REACHED
FIXED
1: OrderPlaced
2: InventoryReserved
3: PaymentDeclined
4: OrderCancelled
5: InventoryReleased
END
错误版本第六步再次产生 OrderPlaced;修复版在库存释放后结束。数字只是实验步数。LIMIT_REACHED 是实验保护,不代表业务已经完成。
真实系统还应校验订单状态,禁止库存补偿事件自动重开已取消订单。合法的重新下单应由明确的业务请求触发,而不是靠“再次收到某种事件”推断用户意图。
怎样证明流程正在失控
建议为本例约定三个关联字段:eventId 标识一条消息,processId 标识一次业务尝试,causationId 指向直接触发它的消息。它们是应用约定,并非消息代理自动提供的业务保证。
排查时先按 processId 聚合,再沿 causationId 检查前因,重点寻找“补偿完成又触发启动”的回边。跨进程追踪还要实际传递追踪上下文,不能只在各服务里分别生成追踪标识。([OpenTelemetry][3])
监控应覆盖端到端完成率、等待时长和补偿积压,而不只看各消费者是否处理成功。编舞中的完整流程视图需要额外建设;没有全局视图时,局部日志正常仍可能掩盖业务停滞。([AWS 文档][2])
哪些问题应该先局部修复
针对本例,可按下面的区别选择处理方向。不要把所有故障都归因于“缺少编排器”。
| 已发现的问题 | 优先处理方向 |
|---|---|
| 只是不知道事件去了哪里 | 补关联记录、订阅清单与流程视图 |
| 补偿事件意外重启业务 | 修触发条件和状态守卫,去掉错误回边 |
| 多个服务重复实现等待、汇合与超时决策 | 明确流程所有者,评估集中协调 |
需要重试时,应区分临时故障与明确的业务拒绝,设置延迟和次数边界,并保证操作可安全重复。无上限重试不是对错误业务规则的修复。([Microsoft Learn][4])
判断线不是订阅数量,而是谁依据什么状态推进流程、失败后谁负责收敛。独立任务可以继续编舞;协调规则跨服务重复出现时,应重新划清流程所有权。