
架构与系统设计 / 系统课时
补齐链路监控和业务追踪
补齐链路监控和业务追踪
队列清空只能说明消息不再等待,不能证明订单已经完成。本篇把发布确认、消费结果、关联日志和业务状态串起来,让你既能发现链路变慢,也能从告警定位到具体订单,验证监控不会在消费者停摆时假装正常。
学习目标
- 区分代理指标、消费尝试指标和业务完成指标,避免只监控队列长度。
- 通过事件标识与追踪上下文,把生产者、消费者和业务结果关联起来。
- 配置可验证的告警,并通过暂停消费观察触发、定位和恢复过程。
定义技术信号与业务终点
先约定“完成”的含义。本例把订单创建记录到处理结果落库作为端到端范围,以 orders.done_at 有值表示完成;真实项目应替换成明确的业务终态,不能把每个消费者的 ACK 都算作一次订单完成。
| 观察层 | 核心信号 | 要回答的问题 |
|---|---|---|
| 发布端 | 发布确认、发布失败 | 事件是否成功交给代理 |
| 代理 | ready、unacked、重新投递次数 | 消息是否等待、卡住或重复投递 |
| 消费处理 | 成功、失败、去重命中、处理耗时 | 下游是否异常,业务是否重复执行 |
| 业务状态 | 未完成数量、最老未完成年龄、端到端耗时 | 是否仍有订单长期没有结果 |
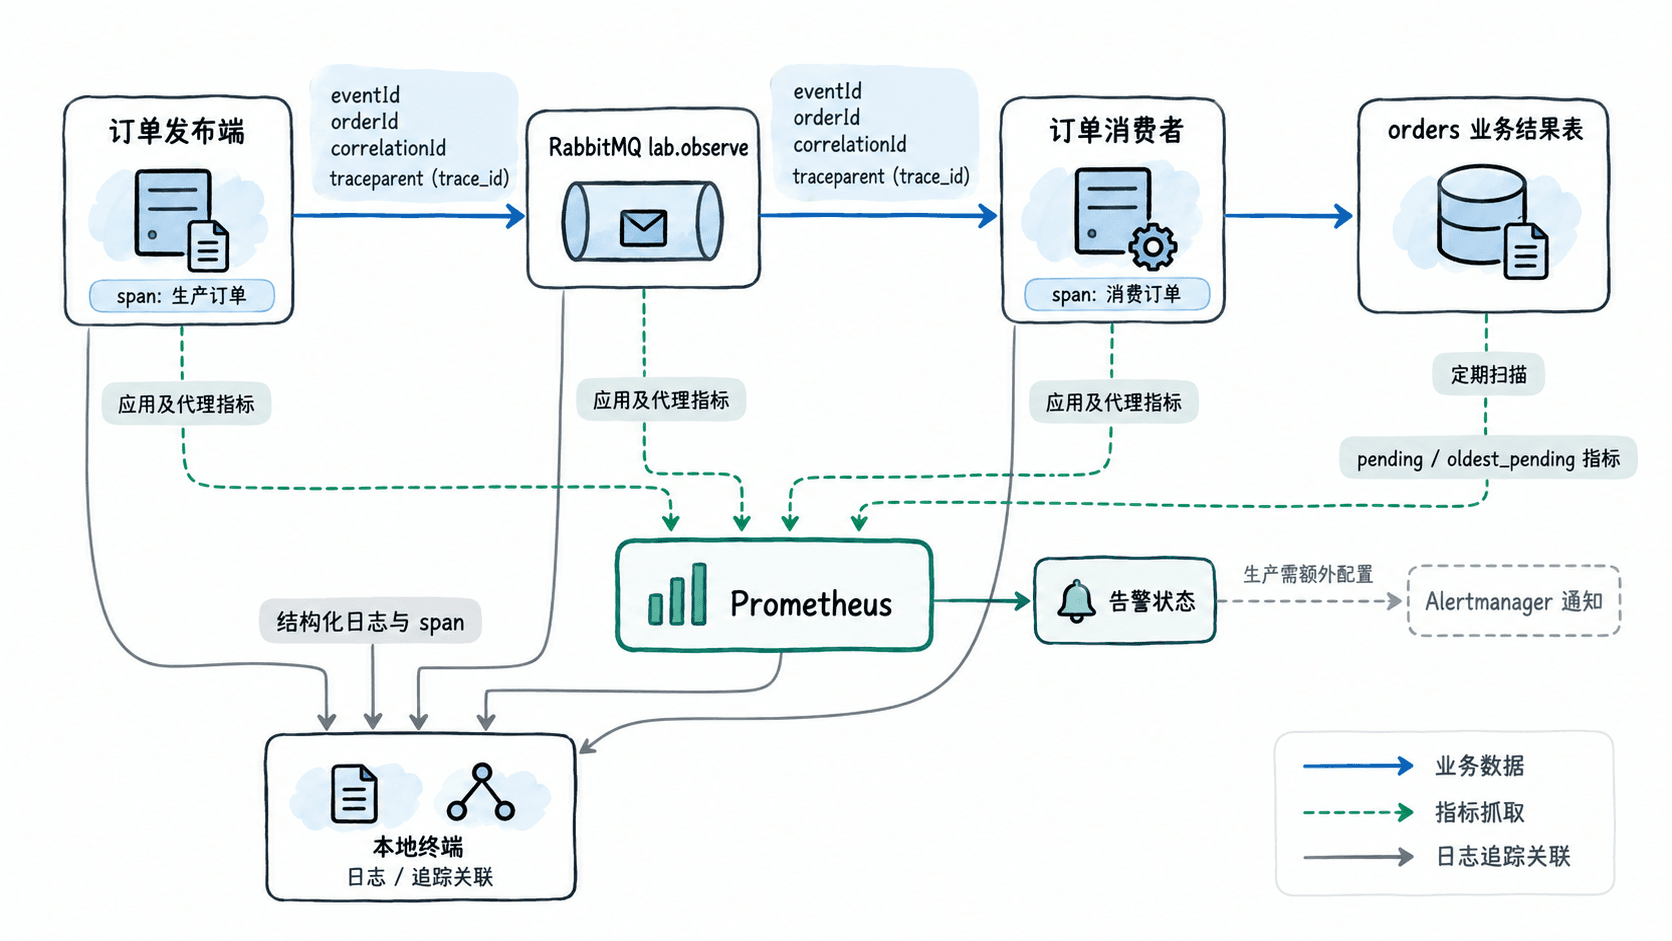
RabbitMQ 的详细指标接口可以按指标族采集队列状态;这些指标不包含你的订单业务终态。下面的 order_ 前缀指标都是本例自己定义和暴露的,不是代理自带的指标。([RabbitMQ][6])
eventId 标识一个不可变事件,重试不更换;orderId 定位订单;correlationId 串起一次业务流程。派生新事件时使用新的 eventId,并以 causationId 记录上游事件。trace_id 用于诊断执行过程,不承担业务去重职责。
订单号、事件号和追踪号不能作为 Prometheus 标签,否则会不断制造新时间序列。它们应进入日志与 span,指标只保留 result 等有限取值。([Prometheus][7])
准备独立的观测实验
使用 Linux 或 WSL、Docker、Python 3.11,并把 Prometheus 3.x 发行包中的 prometheus 与 promtool 放入宿主机的命令搜索路径。在终端 A 的空目录执行准备命令;下面的容器、端口和数据库不依赖其他课时。
# 在新目录创建本课独立环境;固定依赖版本便于复现。
python3 -m venv .venv
. .venv/bin/activate
python -m pip install pika==1.3.2 opentelemetry-sdk==1.30.0 prometheus-client==0.21.1
# 分别映射 AMQP 和代理指标端口,均只监听本机。
docker run -d --name eda-observe -p 127.0.0.1:5674:5672 -p 127.0.0.1:15694:15692 -e RABBITMQ_DEFAULT_USER=lab -e RABBITMQ_DEFAULT_PASS=lab-only rabbitmq:4-management
timeout 60s bash -c 'until docker exec eda-observe rabbitmq-diagnostics -q check_running >/dev/null 2>&1; do sleep 1; done' &&
docker exec eda-observe rabbitmq-plugins enable rabbitmq_prometheus >/dev/null &&
printf 'broker_metrics_ready\n'
预期输出,省略安装与镜像日志:
broker_metrics_ready未出现就绪标记时先处理容器退出或端口冲突,不继续运行应用。镜像标签用于实验,正式交付应固定已验证的版本或摘要。下面所有采集地址都按“应用和 Prometheus 在同一宿主机运行”配置,不能直接搬到另一个容器里使用。
贯通事件上下文与业务指标
保存为 observe_lab.py。示例将生产者和消费者放在一个进程,但消息确实经过 RabbitMQ。发送时把追踪上下文注入消息头,接收时提取后建立新的消费 span;只在 JSON 正文里复制一个追踪号,并不会自动建立这种关系。([OpenTelemetry][8])
本例选择单消息父子关系,因此两端 trace_id 相同、span_id 不同。批处理或存在其他父上下文时,应使用 span links 表达多个来源,不能强行为所有消息指定同一个父 span。([OpenTelemetry][9])
import json
import os
import sqlite3
import time
import uuid
import pika
from prometheus_client import Counter, Gauge, Histogram, start_http_server
from opentelemetry import trace
from opentelemetry.sdk.resources import Resource
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import ConsoleSpanExporter, SimpleSpanProcessor
from opentelemetry.trace import SpanKind, Status, StatusCode
from opentelemetry.trace.propagation.tracecontext import TraceContextTextMapPropagator

def main():
    hold = float(os.environ.get("HOLD_SECONDS", "0"))
    if hold < 0:
        raise ValueError("HOLD_SECONDS cannot be negative")
    provider = TracerProvider(resource=Resource.create({"service.name": "order-observe-lab"}))
    provider.add_span_processor(SimpleSpanProcessor(ConsoleSpanExporter()))
    trace.set_tracer_provider(provider)
    tracer = trace.get_tracer("order-lab")
    propagator = TraceContextTextMapPropagator()

    # 指标只使用有限取值的标签;订单和事件标识进入日志与 span。
    published = Counter("order_publish_total", "Publish attempts", ["result"])
    handled = Counter("order_handler_total", "Business handler attempts", ["result"])
    processing = Histogram("order_processing_seconds", "Business handler duration")
    e2e = Histogram("order_e2e_seconds", "Creation to first completion",
                    buckets=(1, 5, 10, 30, 60, 120, 300))
    pending = Gauge("order_pending", "Orders without a completed result")
    oldest = Gauge("order_oldest_pending_seconds", "Age of oldest pending order")
    for result in ("confirmed", "error"):
        published.labels(result)
    for result in ("success", "error", "duplicate"):
        handled.labels(result)

    db = sqlite3.connect("observe.db")
    db.execute("CREATE TABLE IF NOT EXISTS orders "
               "(event_id TEXT PRIMARY KEY, order_id TEXT UNIQUE, "
               "created_at REAL NOT NULL, done_at REAL)")
    def refresh_business():
        count, first = db.execute(
            "SELECT COUNT(*), MIN(created_at) FROM orders WHERE done_at IS NULL"
        ).fetchone()
        pending.set(count)
        oldest.set(max(0, time.time() - first) if first is not None else 0)

    def log(phase, event):
        context = trace.get_current_span().get_span_context()
        print(json.dumps({"phase": phase, "orderId": event["orderId"],
                          "eventId": event["eventId"],
                          "correlationId": event["correlationId"],
                          "trace_id": f"{context.trace_id:032x}",
                          "span_id": f"{context.span_id:016x}"}), flush=True)

    connection = pika.BlockingConnection(pika.ConnectionParameters(
        host="127.0.0.1", port=5674,
        credentials=pika.PlainCredentials("lab", "lab-only"),
        heartbeat=30, blocked_connection_timeout=10))
    try:
        channel = connection.channel()
        channel.queue_declare(queue="lab.observe", durable=True,
                              arguments={"x-queue-type": "classic"})
        channel.confirm_delivery()
        start_http_server(8001, addr="127.0.0.1")
        print("metrics_started", flush=True)
        event = {"eventId": str(uuid.uuid4()), "orderId": str(uuid.uuid4()),
                 "correlationId": str(uuid.uuid4()), "type": "OrderConfirmed",
                 "occurredAt": time.time()}
        # 待完成记录先落库,不能仅凭已消费消息推测未完成订单。
        with db:
            db.execute("INSERT INTO orders VALUES (?, ?, ?, NULL)",
                       (event["eventId"], event["orderId"], event["occurredAt"]))
        refresh_business()
        with tracer.start_as_current_span("publish OrderConfirmed",
                                           kind=SpanKind.PRODUCER):
            headers = {}
            propagator.inject(carrier=headers)
            try:
                channel.basic_publish(
                    exchange="", routing_key="lab.observe", mandatory=True,
                    body=json.dumps(event).encode(),
                    properties=pika.BasicProperties(
                        delivery_mode=2, message_id=event["eventId"], headers=headers))
            except Exception:
                published.labels("error").inc()
                log("publish_error", event)
                raise
            published.labels("confirmed").inc()
            log("published", event)

        # 暂停取消息时仍刷新业务年龄,避免仅在消息到达时更新指标。
        deadline = time.monotonic() + hold
        while time.monotonic() < deadline:
            refresh_business()
            connection.sleep(1)
        channel.basic_qos(prefetch_count=1)
        for method, properties, body in channel.consume("lab.observe", auto_ack=False):
            received = json.loads(body)
            parent = propagator.extract(carrier=properties.headers or {})
            with tracer.start_as_current_span("process OrderConfirmed",
                    context=parent, kind=SpanKind.CONSUMER) as span:
                span.set_attribute("order.id", received["orderId"])
                span.set_attribute("messaging.message.id", received["eventId"])
                started, result = time.monotonic(), "error"
                try:
                    with db:
                        row = db.execute("SELECT done_at FROM orders WHERE event_id=?",
                                         (received["eventId"],)).fetchone()
                        if row is None:
                            raise ValueError("order record missing")
                        changed = db.execute(
                            "UPDATE orders SET done_at=? "
                            "WHERE event_id=? AND done_at IS NULL",
                            (time.time(), received["eventId"])).rowcount
                    result = "success" if changed else "duplicate"
                    if changed:
                        e2e.observe(time.time() - received["occurredAt"])
                except Exception as error:
                    span.record_exception(error)
                    span.set_status(Status(StatusCode.ERROR))
                finally:
                    handled.labels(result).inc()
                    processing.observe(time.monotonic() - started)
                    log(result, received)
                if result == "error":
                    # 失败只退回一次并结束本轮,不建立无限即时重试循环。
                    channel.basic_nack(method.delivery_tag, requeue=True)
                else:
                    channel.basic_ack(method.delivery_tag)
            channel.cancel()
            break
        connection.close()
        refresh_business()
        print("demo_completed", flush=True)
        while True:
            refresh_business()
            time.sleep(1)
    except KeyboardInterrupt:
        pass
    finally:
        if connection.is_open:
            connection.close()
        db.close()
        provider.shutdown()

if __name__ == "__main__":
    main()
预期结果:指标 HTTP 服务先启动,创建一个订单事件并完成一次处理后继续运行。控制台 exporter 只用于查看 span;本例没有配置追踪存储后台。程序的指标 HTTP 服务由 start_http_server() 暴露。([Prometheus][10])
在终端 A 启动:
# 首次运行使用默认参数,不暂停消费;用 Ctrl+C 结束服务。
python observe_lab.py
预期输出节选,省略 exporter 输出的完整 span JSON:
metrics_started
{"phase": "published", "orderId": "<ORDER_ID>", "eventId": "<EVENT_ID>", "correlationId": "<CORRELATION_ID>", "trace_id": "<TRACE_ID>", "span_id": "<PRODUCER_SPAN_ID>"}
{"phase": "success", "orderId": "<ORDER_ID>", "eventId": "<EVENT_ID>", "correlationId": "<CORRELATION_ID>", "trace_id": "<TRACE_ID>", "span_id": "<CONSUMER_SPAN_ID>"}
demo_completed这些标识都是动态值。同一事件的两条业务日志应使用相同的订单号、事件号和追踪号。success 表示处理结果已提交,不等于代理已经持久记录 ACK。程序只处理一个终态结果便停止消费,同时保留指标服务,不是生产常驻消费者。
在终端 B 验证首次运行的指标:
# 只筛选本次验收需要的业务指标,不依赖其他进程指标的输出顺序。
curl -fsS http://127.0.0.1:8001/metrics | grep -E '^(order_publish_total|order_handler_total|order_e2e_seconds_count|order_pending |order_oldest_pending_seconds )'
预期输出:
order_publish_total{result="confirmed"} 1.0
order_publish_total{result="error"} 0.0
order_handler_total{result="success"} 1.0
order_handler_total{result="error"} 0.0
order_handler_total{result="duplicate"} 0.0
order_e2e_seconds_count 1.0
order_pending 0.0
order_oldest_pending_seconds 0.0
去重命中不重复计入端到端完成样本。处理耗时使用单调时钟;端到端耗时使用业务时间戳,跨主机时需要校准时钟。仅观察完成样本会遗漏一直没有完成的订单,因此必须同时检查持久化账本的未完成数量与最老年龄。
配置采集与可执行告警
保存下面完整配置为 prometheus.yml。代理使用 /metrics/detailed,所以返回的队列指标带有 rabbitmq_detailed_ 前缀;不能套用另一种接口的指标名。按族选择数据还能避免采集大量无关对象指标。([RabbitMQ][6])
global:
  scrape_interval: 15s
  evaluation_interval: 5s

rule_files:
  - alerts.yml

scrape_configs:
  - job_name: order-app
    static_configs:
      - targets: ["127.0.0.1:8001"]
  - job_name: rabbitmq
    metrics_path: /metrics/detailed
    params:
      family: ["queue_coarse_metrics", "queue_delivery_metrics"]
    static_configs:
      - targets: ["127.0.0.1:15694"]
预期结果:加载后分别抓取应用与代理,抓取周期为 15 秒。可用性由 Prometheus 自动产生的 up 指标验证,不用自己在应用里伪造一个“始终健康”的指标。
保存以下规则为同目录的 alerts.yml。数值是实验阈值,不是所有订单系统的推荐阈值;正式环境应按业务时限与流量基线调整。
groups:
  - name: order-chain
    rules:
      # 少量订单长期没有结果,同样需要业务告警。
      - alert: OrderBusinessOverdue
        expr: order_oldest_pending_seconds{job="order-app"} > 60
        for: 30s
        labels:
          severity: critical
          team: orders
        annotations:
          summary: "存在超过 60 秒未完成的订单"
          description: "查询未完成订单,再按 eventId 定位日志和 trace_id"
      - alert: OrderQueueBacklog
        expr: max by (vhost, queue) (rabbitmq_detailed_queue_messages_ready{job="rabbitmq",queue="lab.observe"}) > 20
        for: 2m
        labels:
          severity: warning
          team: orders
        annotations:
          summary: "订单队列持续积压"
      # 采集失败不是业务恢复,必须有独立的可用性告警。
      - alert: OrderTelemetryUnavailable
        expr: up{job=~"order-app|rabbitmq"} == 0
        for: 30s
        labels:
          severity: critical
          team: orders
        annotations:
          summary: "订单链路观测目标不可抓取"
预期结果:条件持续成立达到 for 指定时长,告警才从 pending 进入 firing;仅加载 YAML 不代表已经发出通知。真实通知还需要连接配置了接收人的 Alertmanager。([Prometheus][11])
在终端 B 校验配置并运行 Prometheus,指标查询改用另一个终端:
# 校验失败时不启动;Prometheus 也只向本机开放查询端口。
promtool check config prometheus.yml >/dev/null &&
printf 'configuration_valid\n' &&
prometheus --config.file=prometheus.yml --storage.tsdb.path=./prom-data --web.listen-address=127.0.0.1:9090
预期输出节选:
configuration_valid启动日志随版本变化;实际验收仍要检查应用与代理两个目标的 up 均为 1,并通过故障注入验证规则,而不是只看配置检查成功。
验证告警能定位具体订单
正常运行结束后,在终端 A 按 Ctrl+C,再保持 Prometheus 运行并启动暂停消费实验。原来的已完成订单保留在数据库中,新进程的计数器从零开始。
# 保持消息未被取走,同时继续刷新未完成订单的年龄。
HOLD_SECONDS=120 python observe_lab.py
预期输出:先出现 metrics_started 和该次事件的 published 日志;暂停结束后才出现 success 日志与结束标记,动态标识的格式与前面相同。
metrics_started业务最老年龄超过 60 秒并持续满足 30 秒后,OrderBusinessOverdue 应进入 firing,具体时点受抓取和评估周期影响。此时仅有一条积压,所以超过 20 条的队列告警不会触发,恰好验证“队列不长也可能有业务故障”。
在告警已经触发、暂停尚未结束时,从终端 C 查询告警 API。下面命令只提取告警名称和状态,使用的是 Prometheus 的实际告警列表接口。([Prometheus][12])
# 确认命中业务超时告警,而不是把全部告警视为同一种故障。
curl -fsS http://127.0.0.1:9090/api/v1/alerts | python3 -c 'import json,sys; print([(a["labels"]["alertname"], a["state"]) for a in json.load(sys.stdin)["data"]["alerts"]])'
预期输出,假定其他目标均正常:
[('OrderBusinessOverdue', 'firing')]定位时先按未完成业务状态找订单,再用 eventId 查询本轮 published 日志,取出 trace_id 检查是否缺少消费 span。暂停结束后应出现同一事件的 success,未完成数量与最老年龄回到 0,下一轮抓取和评估后该告警消失。
上线前还要验证失败尝试、重试、失败隔离和超时业务各自有证据,告警包含责任团队与处置入口,并由值班人实际收到一次测试通知及恢复通知。追踪可能被采样或超出保留期,订单状态和事件关联记录仍必须独立可查。