
架构与系统设计 / 系统课时
Kafka 和 RabbitMQ 怎么选
Kafka 和 RabbitMQ 怎么选
同一批订单消息,可能既要供报表重算,也要驱动短信任务。选型不能只比较吞吐量,而要先问历史是否需要保留、工作如何分配、路由规则由谁维护。本篇通过结构对照和一个读取实验,把需求转成可验证的选择依据。
学习目标
- 区分可重放事件流与处理后移除的任务队列。
- 根据独立订阅、路由和顺序要求完成初步选型。
- 验证消息保留语义,并识别产品扩展能力的边界。
先区分事件历史和待办任务
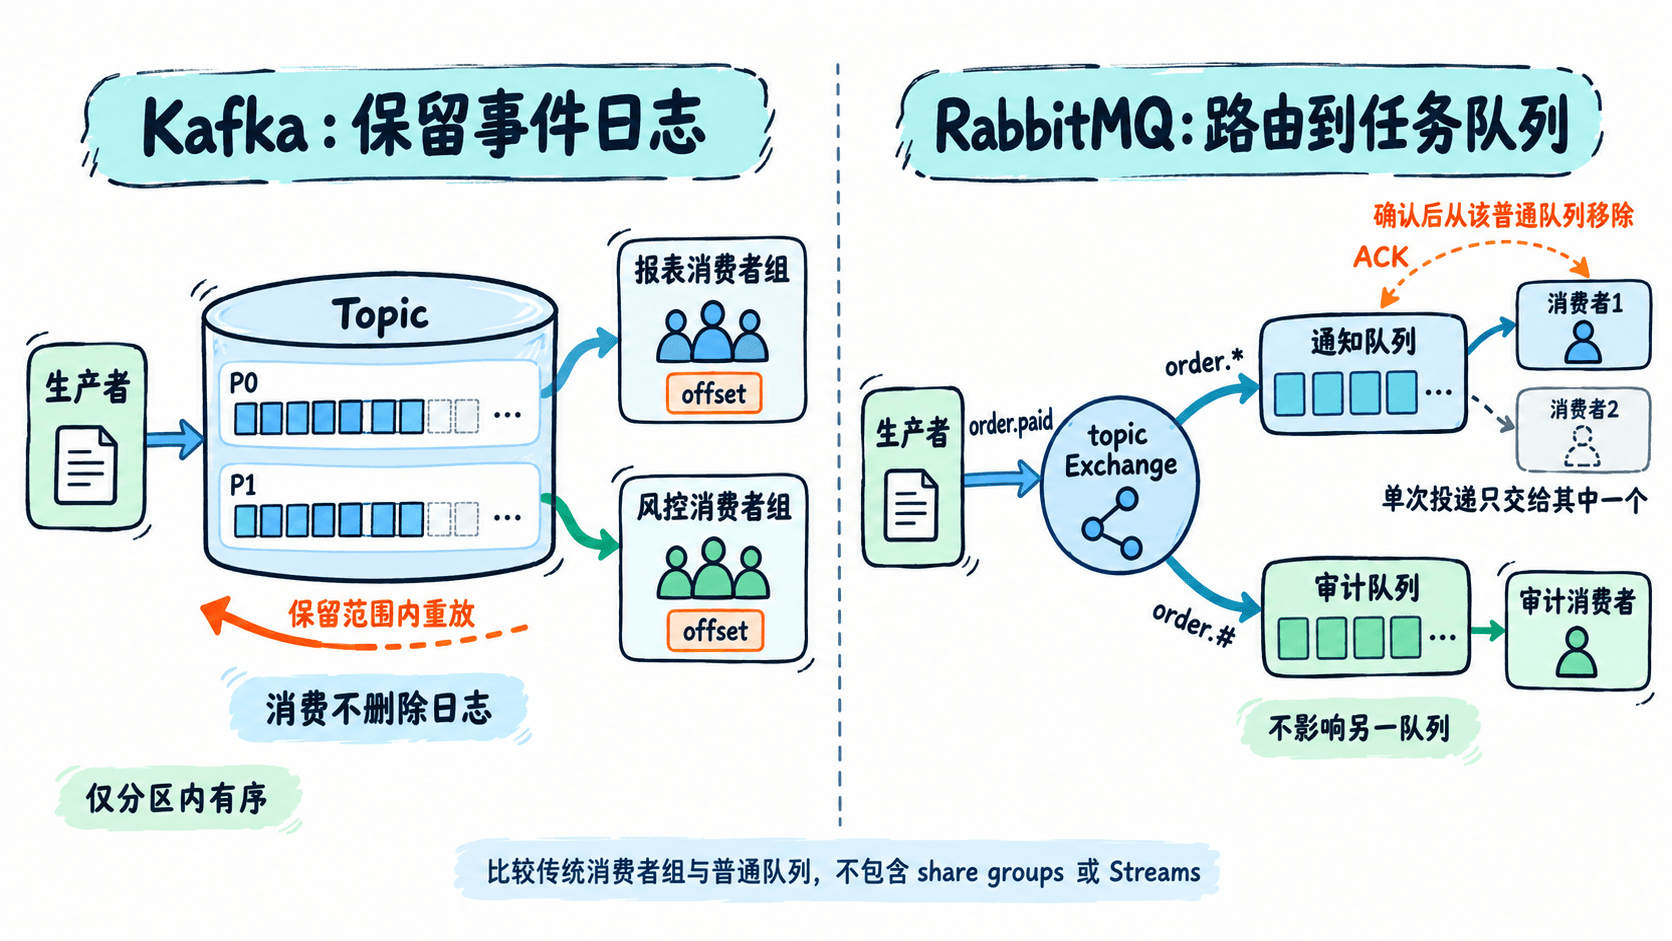
这里先比较 Kafka 的传统消费者组模式,与 RabbitMQ 的 AMQP 0-9-1 普通队列,包括经典队列和仲裁队列。RabbitMQ Streams 与 Kafka share groups 稍后单独说明,避免把不同模式混在一起。
Kafka 将事件保存在分区日志中,各消费者组维护自己的读取位置,即 offset。报表组读完,不会删除风控组还要读取的数据;历史能否重放,取决于记录是否仍在保留范围内。([Apache Kafka][8])
RabbitMQ 由 Exchange 按绑定规则把消息路由到队列。同一队列的多个消费者分担任务;不同业务都要独立处理时,应分别绑定队列。普通队列中的消息被成功确认后可被移除,不会自动成为供新消费者回放的历史记录。([RabbitMQ][9])
用业务约束做第一轮筛选
下面是基于上述机制的初筛建议,不是“谁更快”的产品排名。RabbitMQ 的 direct、topic、headers 等 Exchange 适合表达不同路由规则;Kafka 则首先按 Topic 和分区组织记录与消费。([RabbitMQ][9])
| 判断问题 | Kafka 传统消费者组 | RabbitMQ 普通队列 |
|---|---|---|
| 新系统要重算历史事件吗 | 保留范围内可独立读取 | 已确认移除的消息不能直接回放 |
| 多个工作者要分担任务吗 | 以分区分配工作,需规划并行度 | 多个消费者从同一队列接收任务 |
| 路由规则是否复杂且经常变化 | 需规划 Topic 或额外处理逻辑 | 可通过 Exchange 与绑定表达 |
| 是否要求业务顺序 | 分区内有序,应用处理也须保序 | 并发消费者和重投需特别设计 |
因此,报表重算、多个系统独立读取同一事件历史,可优先验证 Kafka;按规则分发、处理完成即移除的后台任务,可优先验证 RabbitMQ。不要把存储或投递顺序等同于并发业务操作的完成顺序。([Apache Kafka][8])
用两个消费者组验证历史可复用
实验前提是已有可用的 Kafka 4.2 测试服务、Java 17 或更高版本,并从 Kafka 发行包根目录运行 Bash。以下仅用于无认证的隔离测试环境;将 <HOST>:<PORT> 替换为实际引导地址。([Apache Kafka][10])
使用未创建过的 Topic 名称,避免混入旧消息。示例创建单分区、单副本 Topic,并设置按时间保留七天;单副本只是实验简化,不是生产高可用配置。消费命令每组最多读取两条,无消息等待超过十五秒就退出。([Apache Kafka][11])
set -euo pipefail
BOOTSTRAP='<HOST>:<PORT>'
TOPIC='eda-replay-lab'

# 单分区使本次实验的两条消息具有确定的输出顺序。
bin/kafka-topics.sh --bootstrap-server "$BOOTSTRAP" \
  --create --topic "$TOPIC" --partitions 1 --replication-factor 1 \
  --config cleanup.policy=delete --config retention.ms=604800000 \
  >/dev/null

printf 'OrderCreated\nOrderPaid\n' |
  bin/kafka-console-producer.sh \
    --bootstrap-server "$BOOTSTRAP" --topic "$TOPIC"

# 两个不同组分别读取同一份历史,不是两个消费者竞争同一任务。
for GROUP in eda-report-lab eda-risk-lab; do
  printf 'group=%s\n' "$GROUP"
  bin/kafka-console-consumer.sh \
    --bootstrap-server "$BOOTSTRAP" --topic "$TOPIC" \
    --group "$GROUP" --from-beginning --max-messages 2 \
    --timeout-ms 15000
done
预期输出:下面是标准输出;工具的处理条数统计或诊断日志可能另行显示在标准错误中。
group=eda-report-lab
OrderCreated
OrderPaid
group=eda-risk-lab
OrderCreated
OrderPaid
两个组各读到两条记录,说明一个组的读取没有消耗另一个组的历史。这个实验验证的是独立读取和记录保留,不代表已经验证节点故障安全或业务副作用只执行一次。
--from-beginning 只在没有既有消费位置时从最早可用记录开始,不会强制覆盖已提交的 offset。重跑时不要把复用旧组导致的等待误判为消息丢失;显式重放已有组还需安排位置重置。
保留七天也不是“直到所有消费者读完才删除”。过期清理不等待慢消费者;开启日志压缩则可能移除同一键的旧版本,因此不能把压缩主题直接当成完整事件审计历史。([Apache Kafka][11])
别用过时的二选一结论
RabbitMQ Streams 使用追加日志,支持非破坏性读取和保留策略,因此“RabbitMQ 完全不能重放”是错误的。需要重新评估的是 Streams 的客户端、运维方式和功能限制,而不是照搬普通队列的全部能力。([RabbitMQ][12])
Kafka 4.2 文档中的 share groups 支持记录级确认,并允许多个消费者共享分区,所以“Kafka 绝对不能做任务队列”也不准确。它与传统消费者组是不同消费模型,是否采用应验证实际版本、客户端支持与业务语义。([Apache Kafka][13])
把初选结论写成验收条件
先写清消息大小、目标吞吐、端到端延迟、历史保留时长和可接受恢复时间,再用相近的副本数与可靠性配置测试。安排消费者暂停、节点重启,以及“处理成功但尚未确认”的故障,检查积压能否恢复、业务是否重复执行。
确认机制不是外部业务的自动去重器:RabbitMQ 的发布确认与消费确认彼此独立,Kafka 的事务保证也不会自动覆盖任意外部数据库或接口。副作用的幂等与一致性方案必须一起验收。([RabbitMQ][14])
最终应留下“因为需要独立重放,所以选择日志模型”或“因为需要灵活路由和任务分发,所以选择队列模型”这样的可核验理由;已有产品的扩展能力能够满足要求时,不必仅为标签差异再引入一套中间件。