
架构与系统设计 / 系统课时
Schema 管理解决什么问题
Schema 管理解决什么问题
订单事件新增一个字段,为什么消费者突然读不懂?本篇把 Schema 注册、兼容性检查和契约治理拆开说明,并用一次 Avro 字段演进实验,判断哪些变化可以继续发布,哪些必须先修改契约或迁移消费者。
学习目标
- 区分 Schema 注册、消息数据校验和版本兼容性检查。
- 根据消费者升级与历史消息回放需求选择兼容策略。
- 验证新增字段的默认值如何影响 Avro 向后兼容性。
有字段文档,为什么还需要 Schema 管理
假设订单团队维护一份字段文档,仓储团队和报表团队各自编写解析代码。文档更新不代表双方代码同步更新;一次改名或类型调整,可能直到新消息上线才暴露问题。这是本篇要解决的协作场景。
Schema 是机器可读的数据结构契约。注册中心集中保存契约及其演进历史,让生产者、消费者和发布流程围绕同一份定义工作,而不是依靠口头约定。本篇以 Confluent Schema Registry 和 Avro 为例。([Confluent 文档][1])
要分清两个检查对象:数据校验检查某条消息是否符合某个 Schema;兼容性检查比较新旧 Schema,判断一方写出的数据能否被另一方读取。注册一个 Schema,不等于所有消息都会自动经过数据校验;客户端还需要接入相应序列化机制。([Confluent 文档][2])
注册中心怎样接入发布链路
在这个实现中,subject 是组织某组 Schema 版本的逻辑名称;version 表示该 subject 内的版本;Schema ID 用于定位 Schema 定义,不能与 version 混用。注册已有的相同 Schema 通常复用已有记录,不是每请求一次就新增版本。([Confluent 文档][3])
建议把检查前移到持续集成流程:提交候选 Schema,按既定策略检查,通过后注册,再发布使用该契约的应用。注册时仍会执行兼容检查,不能把一次预检查当成永久通行证。([Confluent 文档][4])
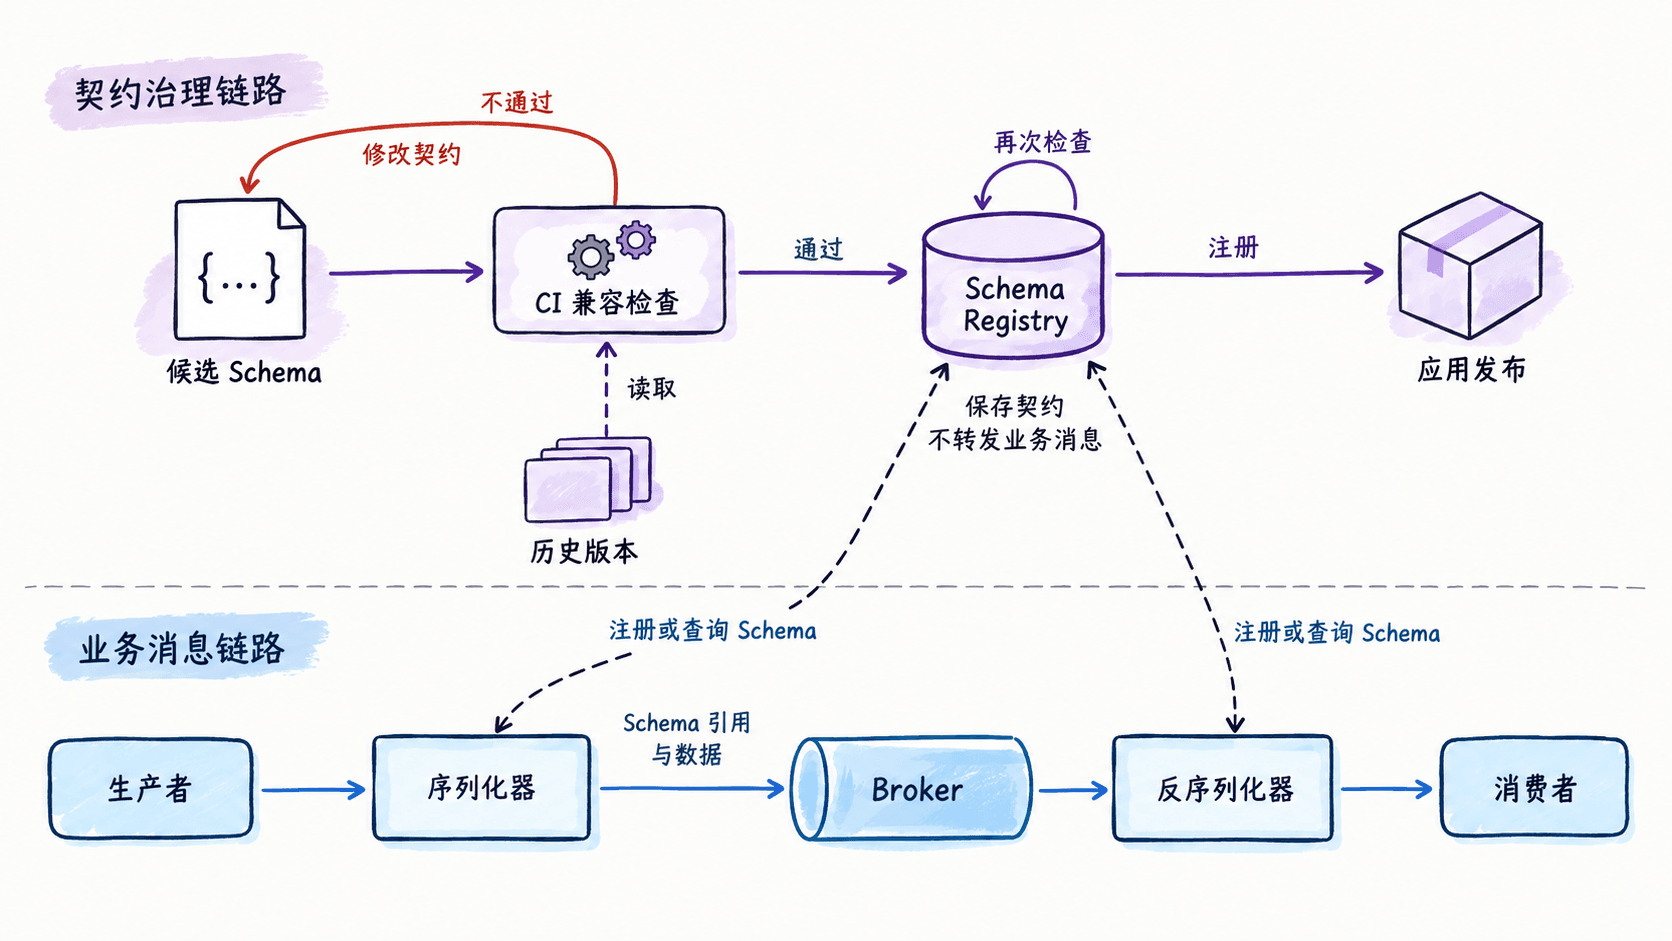
业务消息仍沿生产者、Broker、消费者流动;注册中心负责契约的存储与查询,不是额外的消息中转站。相应序列化组件负责把 Schema 的使用接入消息读写过程。([Confluent 文档][2])
兼容性要先说清读取方向
不要只问“v2 是否兼容 v1”,要明确谁负责写、谁负责读。以下是 Confluent 的主要策略;具体字段变化是否允许,还取决于 Avro、Protobuf 或 JSON Schema 各自的规则。([Confluent 文档][4])
| 策略 | 检查的读取方向 | 主要保护对象 |
|---|---|---|
BACKWARD |
新 Schema 读取旧 Schema 写出的数据 | 升级后的消费者 |
FORWARD |
旧 Schema 读取新 Schema 写出的数据 | 尚未升级的消费者 |
FULL |
同时满足两个方向 | 新旧版本共存 |
非传递策略通常只对照最近版本;带 _TRANSITIVE 的策略扩展到全部历史版本。需要回放较早事件时,应评估 BACKWARD_TRANSITIVE,不能只验证最新两个版本。仅有向后兼容保证时,应先升级消费者,再启用新生产者。([Confluent 文档][4])
用一次字段新增验证兼容检查
准备 Python 3,以及一个已运行、可访问、无认证的测试 Schema Registry。下面的完整脚本会注册 v1,并设置专用 subject 的兼容策略;请使用未被其他实验占用的测试 subject,不要指向生产实例。
运行脚本时输入实际地址,例如 http://<HOST>:<PORT>,其中主机和端口必须替换。脚本只管理契约,不发送业务消息;兼容性接口检查的是候选 Schema,而不是事件实例。([Confluent 文档][3])
import json
from urllib.request import Request, urlopen

registry = input("Registry URL: ").rstrip("/")
subject = "lesson-order-confirmed-value"

def api(method, path, body):
    request = Request(
        registry + path,
        data=json.dumps(body).encode("utf-8"),
        headers={"Content-Type": "application/vnd.schemaregistry.v1+json"},
        method=method,
    )
    with urlopen(request, timeout=10) as response:
        return response.status, json.load(response)

# 保持记录名称不变,本实验只比较新增字段的默认值。
v1 = {
    "type": "record",
    "name": "OrderConfirmed",
    "fields": [{"name": "orderId", "type": "string"}],
}
status, _ = api("POST", f"/subjects/{subject}/versions",
                {"schemaType": "AVRO", "schema": json.dumps(v1)})
print("register", status)

# 只修改练习 subject,不改变注册中心的全局策略。
api("PUT", f"/config/{subject}",
    {"compatibility": "BACKWARD_TRANSITIVE"})

for label, has_default in (("with_default", True), ("without_default", False)):
    field = {"name": "channel", "type": ["null", "string"]}
    if has_default:
        field["default"] = None
    candidate = {**v1, "fields": v1["fields"] + [field]}
    # 预检查不会注册候选版本;此接口按 subject 策略选择历史范围。
    status, result = api(
        "POST", f"/compatibility/subjects/{subject}/versions",
        {"schemaType": "AVRO", "schema": json.dumps(candidate)},
    )
    print(label, status, result["is_compatible"])
预期输出,第一行包含你输入的实际地址:
Registry URL: http://<HOST>:<PORT>
register 200
with_default 200 True
without_default 200 False
v1 没有 channel。新读者读取旧消息时,需要用默认值补齐这个字段;仅允许 null,却不提供默认值,并不能解决字段缺失。因此第一个候选通过,第二个失败。默认值不会改写已经存储的旧消息。([Apache Avro][5])
这里两个检查请求都返回 HTTP 200,但响应中的 is_compatible 分别为 true 和 false。脚本为对照而打印结果;真实发布流程必须据此决定是否阻断,不能只检查 HTTP 状态码。连接或权限错误也不能当成兼容通过。([Confluent 文档][3])
检查通过之后,还要治理什么
假设 totalAmount 一直是整数,团队却把单位从“分”改成“元”:字段结构没变,业务含义已经改变。这类变化说明,结构兼容不能替代业务语义评审。
建议每个重要事件明确维护团队、字段单位、缺失值含义、敏感数据约束和弃用安排;发布前用真实历史样本验证关键消费者。破坏性变化需要显式迁移方案,而不是临时关闭检查后直接上线。
Schema 管理的价值,是把分散的约定变成可查询的版本、可执行的发布检查和有责任人的契约;它减少的是未知变更,而不是免除应用对业务正确性的责任。