
架构与系统设计 / 系统课时
毒消息拖垮消费者怎么处理
毒消息拖垮消费者怎么处理
消费进程还活着,正常订单却迟迟处理不了,可能是一条消息正在反复失败。本篇用错误分类、有限重试和可靠隔离切断循环,并通过故障注入验证坏消息不再持续挤占正常消费资源。
学习目标
- 区分单条毒消息、暂时故障与公共依赖故障。
- 设计有上限的重试路径和不会静默丢消息的隔离边界。
- 验证正常消息能继续处理,并制定受控重放规则。
先区分消息问题与系统性故障
毒消息会让消费者反复失败、重新投递,却始终无法完成处理。损坏的数据、不兼容的事件版本,以及特定输入触发的程序缺陷,都可能成为诱因;换一个消费实例不一定能够解决。([RabbitMQ][1])
排查时,先按 eventId 或消息来源位置聚合异常,再对照消费者版本和错误位置。如果只有少数消息稳定失败,优先检查这些输入;如果大量无关消息同时连接超时,应优先检查公共依赖,不能把它们全部认定为坏数据。([Microsoft Learn][2])
不要用“失败就立即重新入队”作为默认处理。RabbitMQ 官方文档明确指出,重新入队可能触发立即重投,形成消耗网络和 CPU 的循环;增加消费者数量可能只是让更多实例参与同一个循环。([RabbitMQ][3])
给失败路径设置明确预算
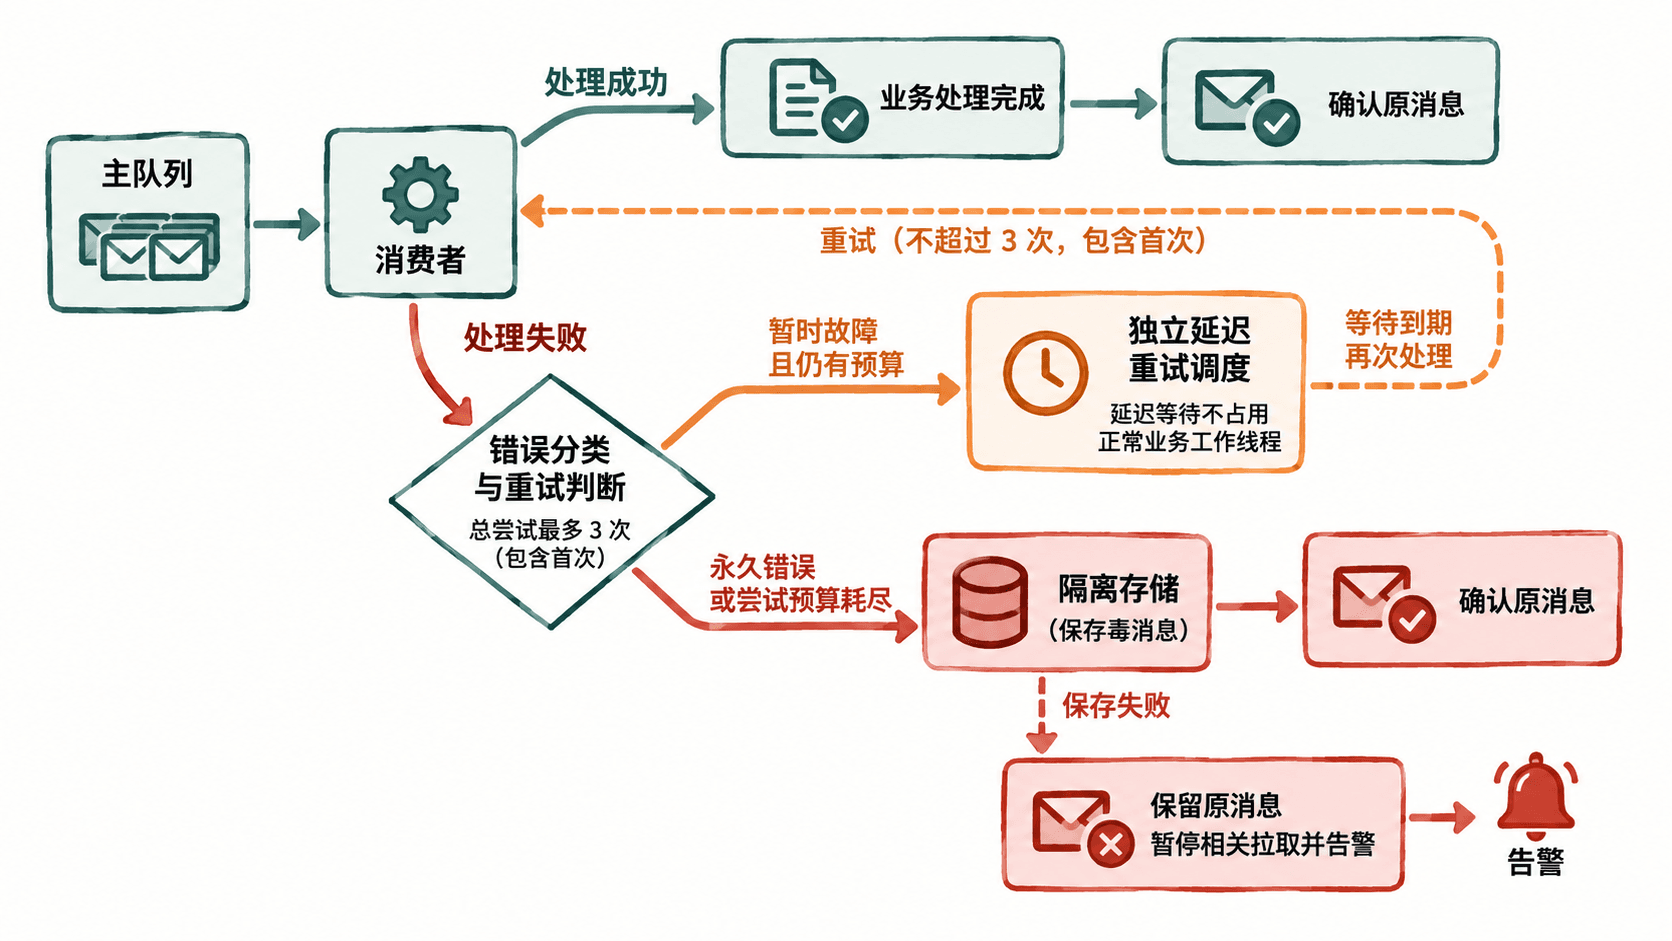
本篇采用以下练习策略:已确认的永久错误直接隔离;暂时故障最多尝试三次,包含首次处理,不是再重试三次;等待间隔逐步增加。预算耗尽表示需要转人工或离线处理,并不证明消息内容一定有错。
生产实现还应限制单次调用时间、总重试时长和重试并发,并错开不同实例的重试时间。公共依赖持续失败时,暂停相关调用或启用熔断,不要让不断重试进一步压垮依赖。([Microsoft Learn][2])
本篇选择延迟调度或独立重试工作池承接等待,避免占住正常业务线程睡眠;同时给在途消息数量设限。对于一直不返回的处理函数,次数上限本身不会生效,还必须有真正生效的超时或隔离手段。RabbitMQ 的有限预取可限制尚未确认的在途投递。([RabbitMQ][3])
用逻辑时钟验证重试预算
下面是完整的策略模拟程序,使用 Python 3.11 标准库。保存为 poison_demo.py,运行 python poison_demo.py。它不连接消息中间件,也不执行持久化或消息确认,只验证分类与调度顺序。
tick 是固定逻辑时刻,label 是固定样本名,不是实际时间或事件 ID。本例约定 amount 为以分计价的正整数。为使结果可重复,演示没有随机等待,超时均由代码主动注入。
from heapq import heappop, heappush
from itertools import count

MAX_ATTEMPTS = 3  # 包含首次处理,不是额外重试三次。

def handle(message: dict, attempt: int) -> None:
    amount = message["amount"]
    if type(amount) is not int or amount <= 0:
        raise ValueError("invalid amount")
    # 仅用于故障注入:temporary 首次失败,stuck 持续失败。
    label = message["label"]
    if label == "stuck" or (label == "temporary" and attempt == 1):
        raise TimeoutError("dependency timeout")

def main() -> None:
    samples = [
        {"label": "bad", "amount": "oops"},
        {"label": "temporary", "amount": 100},
        {"label": "stuck", "amount": 100},
        {"label": "normal", "amount": 100},
    ]
    serial = count()
    pending = []
    isolated = {}
    for message in samples:
        heappush(pending, (0, next(serial), 1, message))

    while pending:
        tick, _, attempt, message = heappop(pending)
        label = message["label"]
        try:
            handle(message, attempt)
        except ValueError:
            reason = "permanent"
        except TimeoutError:
            if attempt < MAX_ATTEMPTS:
                # 记录未来调度点,而不是在处理函数中原地等待。
                due = tick + 2 ** (attempt - 1)
                heappush(pending, (due, next(serial), attempt + 1, message))
                print(f"tick={tick} {label} retry={attempt + 1} due={due}")
                continue
            reason = "exhausted"
        else:
            print(f"tick={tick} {label} ok attempt={attempt}")
            continue

        # 内存隔离区仅用于演示,不代表已经持久化或确认原消息。
        isolated[label] = {
            "message": dict(message),
            "attempts": attempt,
            "reason": reason,
        }
        print(f"tick={tick} {label} isolated={reason} attempts={attempt}")

    print("isolated=" + ",".join(isolated))

if __name__ == "__main__":
    main()
预期输出:
tick=0 bad isolated=permanent attempts=1
tick=0 temporary retry=2 due=1
tick=0 stuck retry=2 due=1
tick=0 normal ok attempt=1
tick=1 temporary ok attempt=2
tick=1 stuck retry=3 due=3
tick=3 stuck isolated=exhausted attempts=3
isolated=bad,stuck
正常样本在逻辑时刻零就完成,没有等待失败样本耗尽预算;暂时故障第二次成功,持续故障第三次失败后隔离。此例中的 ValueError 只来自字段校验,生产环境不能把所有同名异常都当作坏数据。
隔离成功之前不能丢掉原消息
采用应用侧转投时,先把消息可靠保存到重试目标或隔离目标,确认保存成功后,再确认原消息。保存失败就保留原消息,并暂停相关拉取、告警。转投成功但原消息确认丢失可能产生重复,因此隔离记录也要能去重。([RabbitMQ][1])
建议隔离记录保留原始载荷、事件标识或来源位置、消费者身份、版本、错误类型和累计尝试次数;普通日志只输出脱敏诊断信息。尝试次数必须跨进程重启保留,否则一次重启就能绕过限制。
“配置了死信”不等于“转移一定可靠”。例如 RabbitMQ 默认死信转发存在目标不可用时丢失消息的风险;使用自动死信机制时,需要核实所选队列类型和投递保障,不能直接套用应用侧转投的假设。([RabbitMQ][4])
恢复要验证吞吐与重放结果
上线前至少验证:持续失败消息不会无限尝试;正常消息仍能推进;隔离存储不可用时原消息不会消失。建议同时观察正常消费吞吐、积压时长、重试速率和隔离新增量,而不只看进程是否存活。
修复消费者或数据契约后,按选定范围小批、限速重放。重放同一事件应保留原 eventId,并验证业务副作用不会重复;不要把隔离队列自动接回主队列,重新制造无限循环。重投场景必须考虑幂等处理。([Microsoft Learn][2])
严格顺序业务不能默认跳过坏消息。例如必须先创建订单才能处理后续操作时,应暂停受影响的顺序单元并修复。SQS 官方也提醒,将 FIFO 消息移入死信队列可能破坏操作的严格顺序。([AWS 文档][5])
处理目标不是让错误日志归零,而是让失败有上限、证据可追踪、恢复有入口,同时保护正常消息的处理能力。