
架构与系统设计 / 系统课时
Broker 故障时如何判断影响
Broker 故障时如何判断影响
Broker 宕机后,首先要回答的不是“还有几台在线”,而是订单事件还能否写入、已确认消息是否存在风险,以及消费者是否仍在推进。本文以 Kafka 的只读检查为主线,将副本、确认策略和客户端结果组合成可验证的影响结论。
学习目标
- 区分写入不可用、消息结果未知和业务处理延迟。
- 结合副本状态、确认策略与客户端重试判断故障影响。
- 使用只读命令收集证据,并制定恢复验收标准。
先确定受影响的业务范围
先记录故障时间窗口、应用、Topic、分区和消费组,再分别检查生产确认、消费进度与业务状态。排查单位应落到实际承载订单事件的分区,不能由“一台 Broker 离线”直接推导出整个订单系统不可用。
下面采用 Apache Kafka 4.1 的 KRaft 集群作为操作基线。业务分区的副本负责数据复制,控制器组成的多数派负责元数据;两者需要分别检查,不能把 Broker 在线数量当作控制器健康证据。([Apache Kafka][1])
尤其要区分数据仍在但暂时无法访问与数据已经永久缺失。恢复前无法读取某条事件,只能说明当前证据不足;是否丢失必须结合故障前的生产确认记录、存储状态和恢复后的业务对账判断。
副本状态必须结合确认策略解读
假设订单 Topic 配置三副本,有效 min.insync.replicas=2,生产者使用 acks=all。ISR 是当前同步副本集合,包含 Leader;配置三副本不代表此刻三个副本都在 ISR 中。acks=all 等待当前 ISR,而不是固定等待配置中的三个副本。([Apache Kafka][2])
| 分区现场状态 | 对写入的判断 | 不能据此下的结论 |
|---|---|---|
| Leader 可用,ISR 有三个成员 | 满足上述复制门槛 | 消费者已经处理完成 |
| Leader 可用,ISR 有两个成员 | 仍满足门槛,但冗余减少 | 任何后续故障都可承受 |
| Leader 可用,ISR 只剩一个成员 | acks=all 写入不能成功满足门槛 |
已确认的历史消息必然丢失 |
| 没有可用 Leader | 该分区当前无法正常提供读写 | 其他分区也必然停止服务 |
表中的判断以客户端能够访问 Leader 为前提;切换期间仍可能发生超时。ISR 低于门槛时可能出现 NotEnoughReplicas 或 NotEnoughReplicasAfterAppend,后者尤其不能解释为“肯定从未追加”。([Apache Kafka][2])
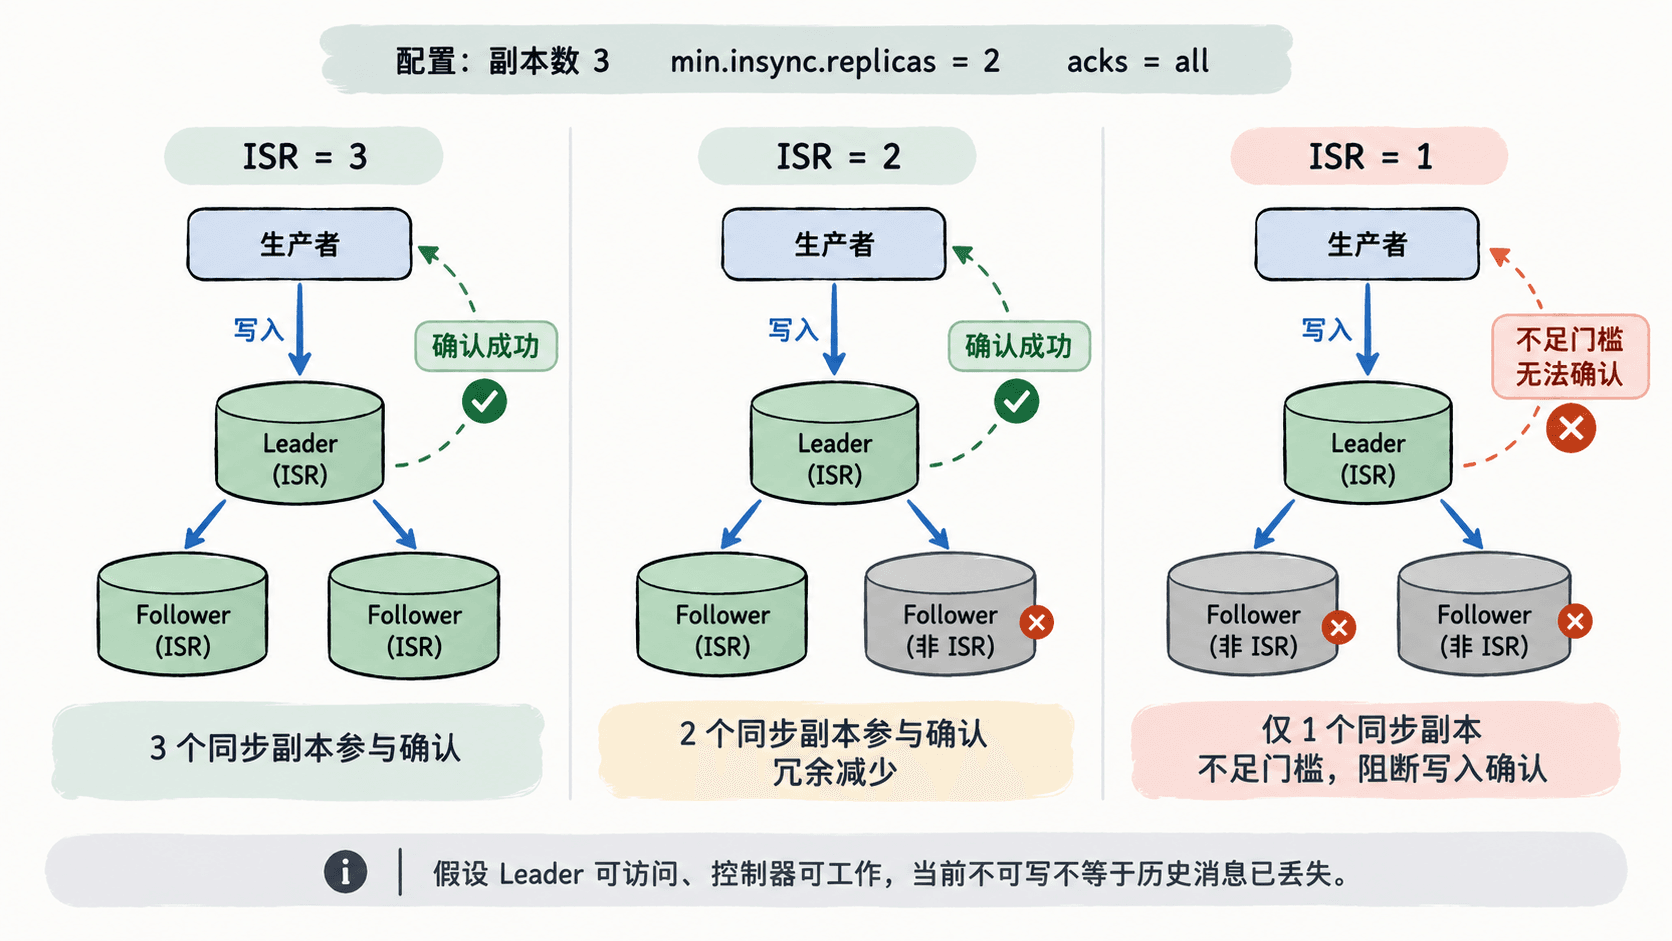
若使用 RabbitMQ,要先确认队列类型及实际成员。三成员 quorum queue 需要至少两个成员互通才能工作,不能套用 Kafka 的 ISR 门槛;生产确认的安全保证也有副本存续条件。([RabbitMQ][3])
用只读命令取得故障证据
需要已有 Kafka 4.1 工具、Java 17+、可访问的集群入口及相应查询权限。在 Kafka 解压目录使用 Bash 执行;将 <HOST>、<PORT>、<PATH> 替换为实际值,并使用已有的客户端鉴权配置文件。Topic 和消费组名称按现场替换。([Apache Kafka][4])
以下依次查询分区、有效配置、控制器元数据状态与消费位点。--all 用于查看包含静态配置在内的配置结果,避免只看到 Topic 覆盖项就误判默认值。
# 使用可达入口和已有鉴权文件,不在命令中粘贴密码。
BOOTSTRAP='<HOST>:<PORT>'
CLIENT_CONFIG='<PATH>/client.properties'
TOPIC='orders.events'
GROUP='order-notifier'

# 只读采集:不修改副本、确认策略或消费位点。
bin/kafka-topics.sh --bootstrap-server "$BOOTSTRAP" \
  --command-config "$CLIENT_CONFIG" --describe --topic "$TOPIC"

bin/kafka-configs.sh --bootstrap-server "$BOOTSTRAP" \
  --command-config "$CLIENT_CONFIG" --entity-type topics \
  --entity-name "$TOPIC" --describe --all

# 元数据控制面与业务消费进度分开观察。
bin/kafka-metadata-quorum.sh --bootstrap-server "$BOOTSTRAP" \
  --command-config "$CLIENT_CONFIG" describe --status

bin/kafka-consumer-groups.sh --bootstrap-server "$BOOTSTRAP" \
--command-config "$CLIENT_CONFIG" --describe --group "$GROUP"预期输出:下面是四条命令依次对应的演示快照关键字段摘录,不是现场必然出现的数值;已省略附加字段和配置来源。<ID_A> 等代表不同节点标识,实际列宽、标识和位点可能不同。
Topic: orders.events Partition: 0 Leader: <ID_A> Replicas: <ID_A>,<ID_B>,<ID_C> Isr: <ID_A>,<ID_B>

min.insync.replicas=2
unclean.leader.election.enable=false

LeaderId: <ID_CONTROLLER>
MaxFollowerLag: 0

TOPIC         PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG
orders.events 0          100             220             120
这组演示值表示分区零有两个同步副本,仍满足预设写入门槛;消费位点差为 120,不能称为“丢了 120 条”。持续比较提交位点和日志末端,才能判断是在追赶、停滞,还是生产也停止了。([Apache Kafka][2])
控制器的 LeaderId 和 MaxFollowerLag 属于元数据状态,不是订单消息的处理证明;CurrentVoters 也只是成员信息。应结合控制器日志和节点互通情况核实多数派,单次返回成功不能代表整个故障窗口健康。([Apache Kafka][1])
若查询失败,先区分鉴权失败、入口不可达和集群异常,再从另一有效入口复查。不要把管理命令自身无法连接,直接记录成所有业务分区均不可用。
把客户端结果分成三类
还要读取生产者实际生效配置和发送回调记录。Kafka 的 send() 返回通常只表示记录进入发送流程,不等于已收到 Broker 确认;确认依据应是对应 Future 或回调的最终结果。([Apache Kafka][5])
- 已确认成功:按当时的
acks、有效复制门槛和故障条件评估持久性,不能当作业务消费完成。 - 能证实未发送:例如本地序列化失败,应修复输入后按原业务标识重试。
- 结果未知:例如等待确认时连接中断或超时,消息可能已写入但确认未到达,必须保留核对与幂等补发能力。([Apache Kafka][5])
重点核对 acks、enable.idempotence、delivery.timeout.ms 和应用层重试。acks=1 的成功不代表副本已复制;自动重试受交付时限约束。生产者幂等不能替代应用重发与消费者业务幂等,重新调用发送仍可能构成新的消息。([Apache Kafka][6])
RabbitMQ 的 publisher confirms 与消费者确认也是两回事:前者不证明通知已发送或库存已更新。跨组件判断业务完成,仍要查对应消费者的持久化处理结果。([RabbitMQ][7])
用业务对账完成恢复验收
优先恢复副本、网络和存储,并保留原始数据与日志。不要为了“先恢复绿色”而临时降低确认门槛、启用不洁 Leader 选举,或跳过积压位点;不洁选举可能带来数据丢失,修改消费位点则会改变待处理范围。([Apache Kafka][2])
入口降级要遵守业务承诺:只有事件已有可恢复的持久化来源,且允许延后处理时,才适合返回“已受理”。采用事务性 Outbox 时,订单与待发布事件同事务保存;Broker 暂时不可用不应演变成不可追踪的内存积压。([AWS 文档][8])
恢复验收至少覆盖三个层面:副本回到预期状态且不再反复切换;真实发送确认和消费位点持续推进;故障窗口的订单、待发布事件与消费者结果能够对账。补发使用稳定的 eventId,并验证重复投递不会重复产生业务副作用。
影响报告应写清受影响分区、故障起止 <TIME>、已确认与结果未知的事件范围,以及当前业务延迟。ISR 快照与“Broker 已重启”都不能代替这份证据链,也不能证明故障期间从未丢失消息。