
架构与系统设计 / 系统课时
死信队列应该怎么使用
死信队列应该怎么使用
消息进入死信队列,只说明正常处理路径已经停止,并不表示业务已经完成。本篇把隔离、告警、修复、重投和验收连成可执行的处置流程,让失败消息有人负责、有据可查,而不是长期堆积后被直接清空。
学习目标
- 区分延迟重试、失败隔离与业务处理成功。
- 为死信设计诊断信息、告警责任和修复记录。
- 实施保留事件身份、限制次数并核对结果的重投流程。
死信是隔离区,不是成功回执
死信队列用于隔离未能正常处理的消息,便于排查原因并决定是否重新处理。可恢复且仍有预算的故障走重试路径;明显坏消息或重试耗尽的消息进入隔离路径。进入死信不等于对应业务已经完成。([AWS 文档][6])
不要把“配置了死信”理解为“转移一定不会丢失”。例如 RabbitMQ 的死信交换机负责路由,并不是存储队列;默认死信转发与显式启用的 quorum queue 至少一次死信转发,可靠性条件不同。应验证目标、绑定关系及目标不可用时的行为。([RabbitMQ][7])
让失败样本同时带上证据和负责人
建议为每条死信建立独立的失败档案,原始事件与处置记录分开保存。以下是应用侧的设计清单,不是所有中间件都会自动提供的统一字段。
| 信息组 | 建议保留内容 | 解决的问题 |
|---|---|---|
| 原始事件 | 原始字节、事件标识、业务键、版本、必要消息头 | 能复现,且不篡改原始事实 |
| 失败证据 | 来源、消费者版本、错误分类、首次与最后失败时间、累计次数 | 确认失败发生在哪里 |
| 处置记录 | 负责人、工单、修复说明、状态、重投次数与批次 | 确认谁处理、处理到了哪里 |
无法解析事件时,也应保留原始字节并按消息系统定位信息或独立隔离记录编号追踪,不能要求“先解析成功才能进入死信”。含敏感内容的原文限制访问,告警只带必要摘要和受控查询入口。
建议对新增死信量、未处理数量、最长未处理时长和重投后再次失败率分别设告警。关键业务可在出现首条死信时通知负责人,低风险批量任务可按阈值聚合;无论怎样聚合,都应有明确响应时限和升级对象。
保留期必须覆盖发现、定位和修复窗口,但不能假定进入死信后所有系统都会重新计时。例如 SQS 标准队列消息转入死信时仍沿用原始入队时间计算到期,FIFO 队列的行为不同。应按实际产品规则计算剩余处理时间。([AWS 文档][6])
按处置状态推进修复与重投
下面的状态是建议建立的应用侧档案状态,不是消息系统自动提供的状态机。特别要把待重投、已投递、已验收分开:生成任务、消息被目标接收和业务正确完成是三个不同结果。
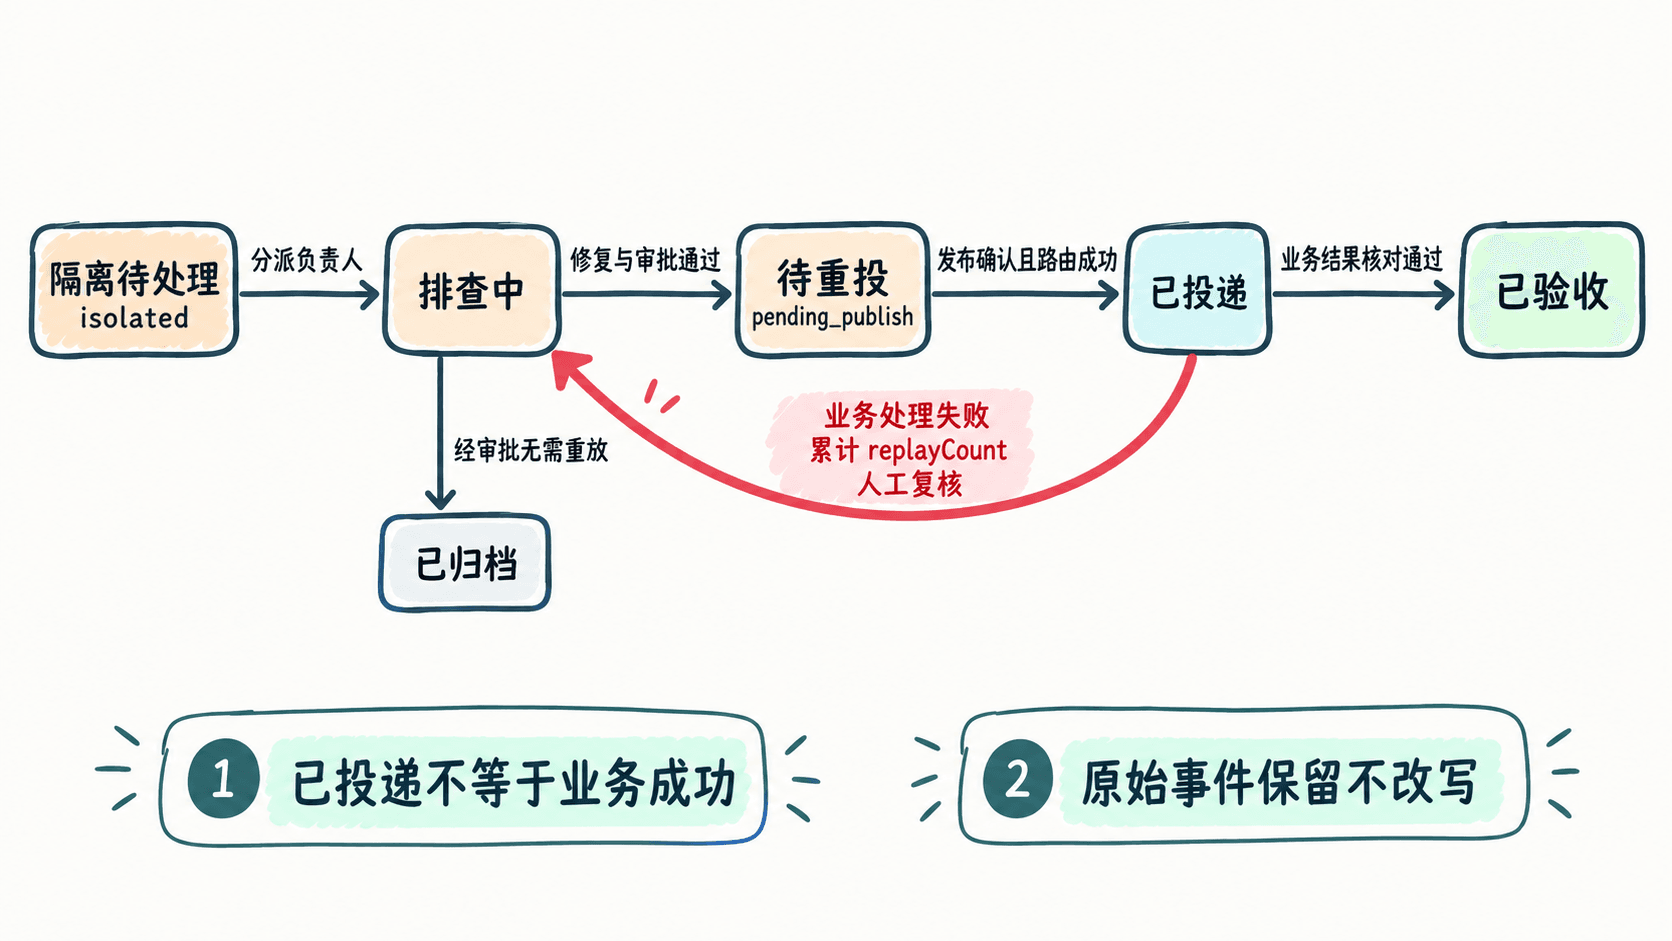
- 按错误分类聚合样本,分派负责人,核对消息版本、消费者版本及关联业务状态。
- 修复消费者、配置或依赖,并用原样本在隔离环境验证;先确认业务动作是否已经执行,避免重复生效。
- 审批后选择少量消息,经独立重投入口限速投递;若再次出现同类错误,停止该批次,返回排查。
- 核对实际业务结果后标记已验收;已过期、无须处理或必须补偿的消息,经审批记录原因后归档。
优先修复处理能力并原样重放。若需要改变金额、对象或其他业务事实,应按业务契约产生可追溯的更正事件,不能悄悄修改原事件,再借原标识绕过审计或幂等规则。
重投速度应从小值开始,根据正常流量与下游余量逐步提高,而不是一次性清空积压。SQS 的重投也支持速率控制,但其原生重投过程不支持筛选或修改消息;需要这些能力时,必须另行设计受控处理流程。([AWS 文档][8])
用代码检查重投资格
以下是完整可运行的本地演练,使用 Python 3.11 或更新版本的标准库。保存为 replay_plan.py 后运行 python replay_plan.py。场景是旧消费者不支持事件版本 2,修复消费者后保持原事件不变,生成重投计划。
from copy import deepcopy

def prepare_replay(record: dict, *, approved: bool,
                   ticket: str, requested_at: str) -> dict:
    # 这里只检查传入的审批结果,真实系统必须在服务端完成身份与权限校验。
    if not approved or not ticket.strip():
        raise ValueError("repair approval required")
    if record["status"] != "isolated" or record["replayCount"] >= 1:
        raise ValueError("replay not allowed")
    if record["event"]["schemaVersion"] != 2:
        raise ValueError("unsupported schema")

    # 保留原事件身份和内容;生成计划不代表已经发布消息。
    return {
        "event": deepcopy(record["event"]),
        "target": "billing.replay",
        "replayCount": record["replayCount"] + 1,
        "ticket": ticket,
        "requestedAt": requested_at,
        "state": "pending_publish",
    }

def main() -> None:
    # 模拟旧消费者不支持版本 2;修复消费者后,原事件不需要改写。
    record = {
        "event": {
            "eventId": "<ID>", "type": "OrderConfirmed",
            "schemaVersion": 2, "data": {"amountMinor": 12000},
        },
        "source": "billing.main", "consumerVersion": "billing-v1",
        "errorCode": "UNSUPPORTED_SCHEMA", "attempts": 1,
        "firstFailedAt": "<TIME>", "status": "isolated", "replayCount": 0,
    }
    try:
        prepare_replay(record, approved=False, ticket="", requested_at="<TIME>")
    except ValueError as exc:
        print(f"blocked={exc}")

    plan = prepare_replay(
        record, approved=True, ticket="<ID>", requested_at="<TIME>"
    )
    assert plan["event"] == record["event"]
    assert record["status"] == "isolated"
    print(f"eventId={plan['event']['eventId']} state={plan['state']}")
    print(f"replayCount={plan['replayCount']} original={record['status']}")

if __name__ == "__main__":
    main()
预期输出:
blocked=repair approval required
eventId=<ID> state=pending_publish
replayCount=1 original=isolated
<ID> 和 <TIME> 是演练占位符,生产中分别替换成对应事件或工单的真实标识、真实时间,不同字段的实际值可能不同。billing.replay 是本例约定的目标名称;程序没有创建队列,也没有实际发送消息。
第一次调用缺少修复审批,因此被拒绝;第二次只生成 pending_publish 计划,原始记录仍保持隔离。上限一次是本例的人工重投规则,不是产品默认值;再次失败的档案必须保留累计 replayCount,不能重新归零。
生产实现还需要把状态更新、唯一重投任务和审计记录放入同一数据库事务,再由发送器发布。发送器可能重复发送,因此目标消费者仍需幂等处理;单靠这个内存函数无法防止并发审批或进程崩溃造成重复任务。([AWS 文档][9])
分别验收投递结果与业务结果
应用自行搬移消息时,先确认目标路由成功并收到所需发布确认,再确认或删除源死信;发布失败或结果不明时保留可恢复记录。原始档案独立留存,直到业务结果核对完成。发布确认不代表消费者已经完成业务。([RabbitMQ][5])
重投应保留应用的 eventId 或稳定业务幂等键,不能把消息系统重新分配的传输标识当作事件身份。例如 SQS 重投会分配新的消息标识;依赖这个新标识去重,就无法识别它和原事件的关系。([AWS 文档][8])
对于严格顺序处理,不能默认移走失败事件后继续执行后续事件,再把旧事件补回就能恢复原顺序。应事先选择暂停受影响业务键、校验版本缺口或采用补偿;SQS 官方也明确提醒,死信隔离可能破坏严格顺序。([AWS 文档][6])
验收时建议故意制造两种故障:目标不可用时,原始消息和档案仍可恢复;发布成功后进程退出再重放时,业务副作用仍只发生一次。队列变空不是完成标准,能够查到每条失败事件的最终业务结果或审批处置结论,才允许关闭工单。