
架构与系统设计 / 系统课时
一条消息可能在哪些地方丢
一条消息可能在哪些地方丢
订单已经提交,仓库却没有收到通知,问题不一定出在消息服务器。本篇沿业务提交、生产发送、Broker 保存和消费落库寻找丢失窗口,区分真正丢失与结果未知,并用故障模型验证确认顺序为什么影响业务可靠性。
学习目标
- 沿消息交接边界定位可能丢失的位置及对应保护机制。
- 区分发布确认、消费 ACK 与业务事务提交的含义。
- 通过故障模型解释重试为什么需要幂等处理。
先沿责任交接寻找窗口
排查时先区分三种情况:消息仍在积压或重试,只是延迟;发送超时但接收方状态不明,属于结果未知;业务尚未完成,系统却已没有可恢复的消息或待办记录,才需要追查丢失窗口。建议用同一个 eventId 串联各阶段证据。
消息可靠性不是 Broker 的单方承诺。网络中断、客户端退出、服务器故障和确认时机,都可能改变消息由谁负责保存、恢复与重试。下面用队列消息的确认模型说明这些交接边界。([RabbitMQ][6])
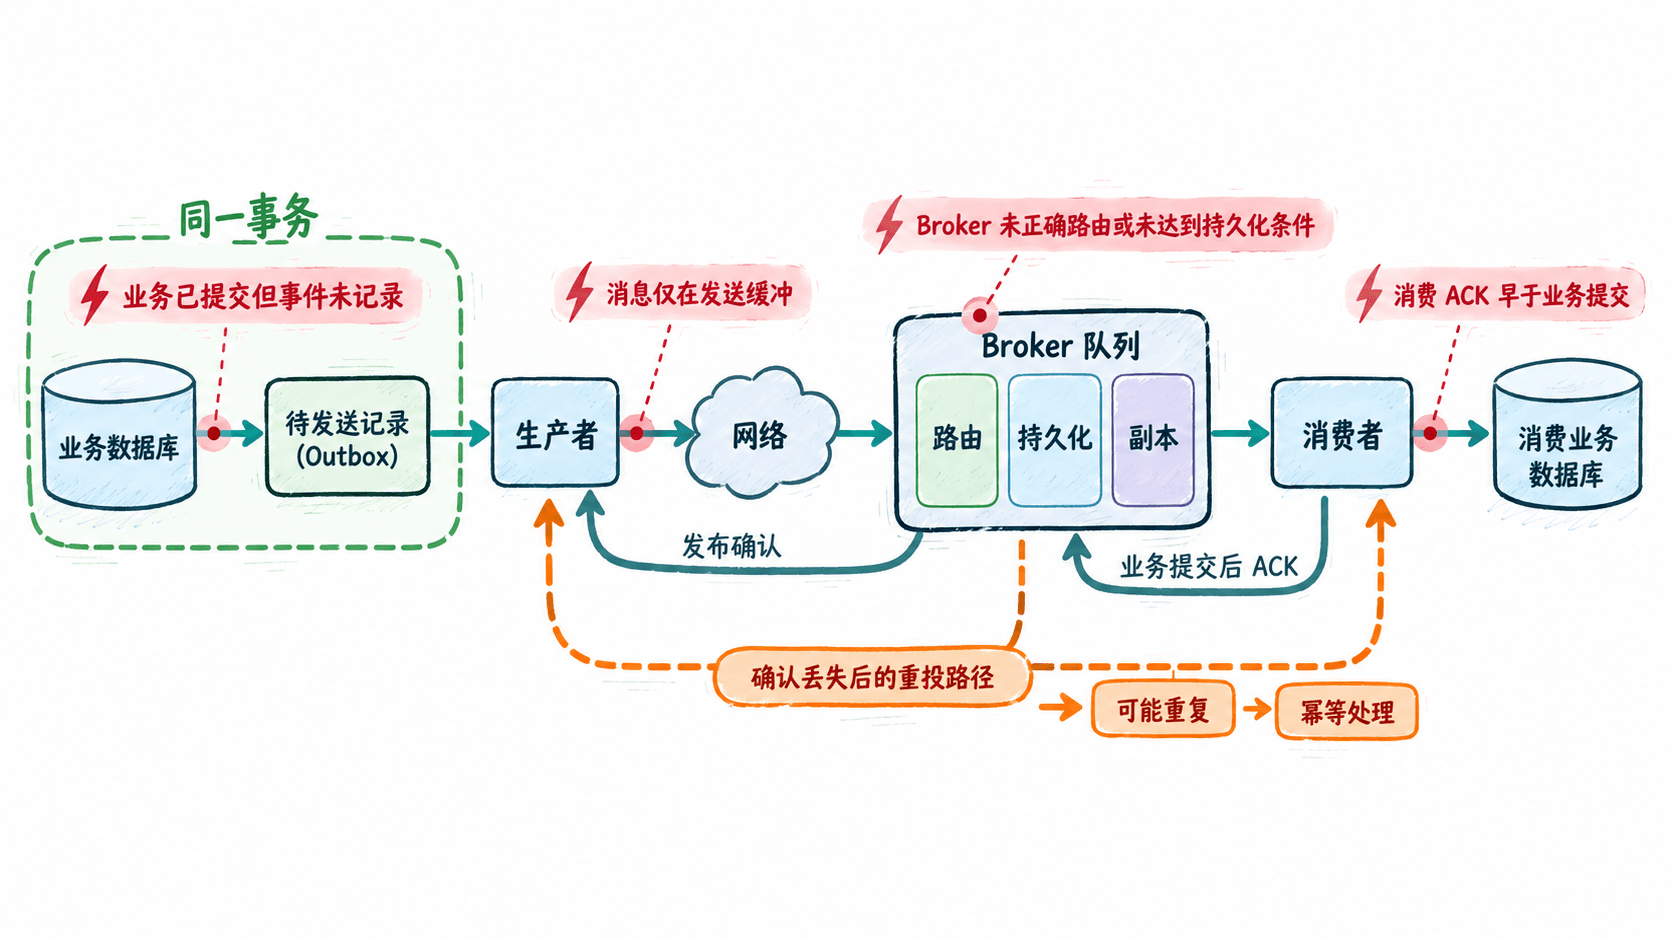
| 交接位置 | 典型丢失窗口 | 对应保护 |
|---|---|---|
| 业务提交到事件发送 | 订单已提交,进程在发送前退出 | 业务更新与 Outbox 同事务 |
| 生产者到 Broker | 消息仅在本地缓冲,退出后无法恢复 | 保存待发送状态、发布确认、重试 |
| Broker 内部 | 未正确路由,或未达到约定的保存条件 | 路由检查、持久化与副本机制 |
| 消费者到业务库 | 已确认消费,业务提交却失败 | 业务提交后 ACK,失败保留重投 |
Outbox 是与业务更新一起提交的待发送事件记录。发送进程随后读取它并投递,避免“订单存在,事件却没留下”的双写窗口;它不等于数据库与 Broker 之间建立了一个原子事务,后续投递仍需处理失败与重复。([AWS 文档][7])
Broker 确认没有覆盖整个业务
以 RabbitMQ 为例,发布确认用于生产者与 Broker 之间的交接;消费 ACK用于消费者告知 Broker 如何处理已投递消息。发布确认不会证明仓库已经扣库存,消费 ACK 也不是业务数据库的提交证明。([RabbitMQ][8])
发布确认还需要结合路由结果判断:无法路由到任何队列的消息也可能获得确认。需要发现这种情况时,应使用 mandatory 并处理返回消息。对于持久化消息进入持久化队列的情况,确认涉及落盘;quorum queue 的确认涉及多数副本接受。([RabbitMQ][8])
“部署了集群”也不等于每个队列都复制了消息,需要核对实际队列类型及副本配置。持久化用于应对相应的重启风险,副本机制用于覆盖其设计范围内的节点故障;两者都不能替代应用侧的正确确认。([RabbitMQ][6])
此外,消息可能按 TTL 过期,或因拒绝、队列长度限制等条件进入死信处理。队列深度减少不等于业务成功;要核查过期、拒绝和死信策略,也不能默认死信转发本身永不丢失。([RabbitMQ][9])
超时为什么仍要准备接收重复
生产者没有收到确认,存在两种可能:Broker 没收到消息,或者 Broker 已保存消息但确认在途中丢失。只凭超时无法区分。保留待发送记录并重试,可以恢复前者,却可能使后者产生重复投递。([RabbitMQ][6])
消费者也有类似窗口:业务已提交,但 ACK 尚未被 Broker 接收,连接就断了。Broker 可能重新投递;反过来,先 ACK 再提交业务,提交失败时通常已经失去正常重投机会。可靠处理因此要同时考虑提交顺序与幂等性。([RabbitMQ][8])
幂等的目标不是保证消息只出现一次,而是让同一事件重复到达时,不重复产生业务效果。真实实现可以将消费去重记录与业务更新放进同一个数据库事务,并用唯一键防止并发重复处理。([microservices.io][10])
用故障模型验证 ACK 顺序
下面是可以直接运行的 Python 3 内存模型,无第三方依赖。它不是 Broker 或数据库实现:字典抽象表示已保存的外部状态,commit 抽象表示一次原子业务提交,crash 只中断首次处理,恢复阶段不再注入故障。
模型假设未被确认的消息会重投,已确认的消息不会重投。<ID> 代表同一事件的稳定标识;实际系统应在重试时保留同一个 eventId,而不是每次生成新值。
def simulate(first_steps, deduplicate):
    event_id = "<ID>"
    state = {"acked": False, "effects": 0, "processed": set()}

    def commit():
        if deduplicate and event_id in state["processed"]:
            return
        # 模型把业务效果与去重记录视为同一事务,不模拟真实持久化。
        state["effects"] += 1
        state["processed"].add(event_id)

    for step in first_steps:
        if step == "commit":
            commit()
        elif step == "ack":
            state["acked"] = True
        elif step == "crash":
            break

    # 恢复时只重投未确认消息;此轮业务处理和确认均成功。
    if not state["acked"]:
        commit()
        state["acked"] = True
    return state["effects"]

# 每个场景从独立状态开始,比较最终生效次数而不是投递次数。
cases = [
    ("提前确认后崩溃", ("ack", "crash"), False),
    ("提交前崩溃", ("crash",), False),
    ("提交后确认前崩溃", ("commit", "crash"), False),
    ("提交后确认前崩溃并去重", ("commit", "crash"), True),
]
for label, steps, deduplicate in cases:
    print(f"{label}: {simulate(steps, deduplicate)}")
预期输出:
提前确认后崩溃: 0
提交前崩溃: 1
提交后确认前崩溃: 2
提交后确认前崩溃并去重: 1
第一行说明提前确认会让未完成的业务失去模型中的重投机会;第三行说明正确延后确认仍可能重复;第四行才同时保留恢复机会并避免重复生效。这个实验验证的是顺序关系,不是对真实网络、磁盘或副本可靠性的测试。
用证据验证保护是否闭环
建议在隔离测试环境中,分别在“业务提交后发送前”“Broker 接收后确认返回前”“消费提交后 ACK 前”注入进程退出或连接中断。恢复后围绕 eventId 对账,不要只比较发送量与消费量。
针对订单通知,验收应检查:每个应发送的事件,要么已产生一次预期业务效果,要么仍有可恢复的待发送、重试或失败记录。重点查待发送记录是否被过早删除、异常是否被吞掉、消费者是否提前确认,以及失败消息是否仍能补处理。
消息不丢的判断依据,不是某一行“发送成功”日志,而是每次责任交接都有明确确认条件,交接失败仍有恢复依据,重复发生时业务结果仍然正确。