
架构与系统设计 / 系统课时
突发流量如何避免压垮下游
突发流量如何避免压垮下游
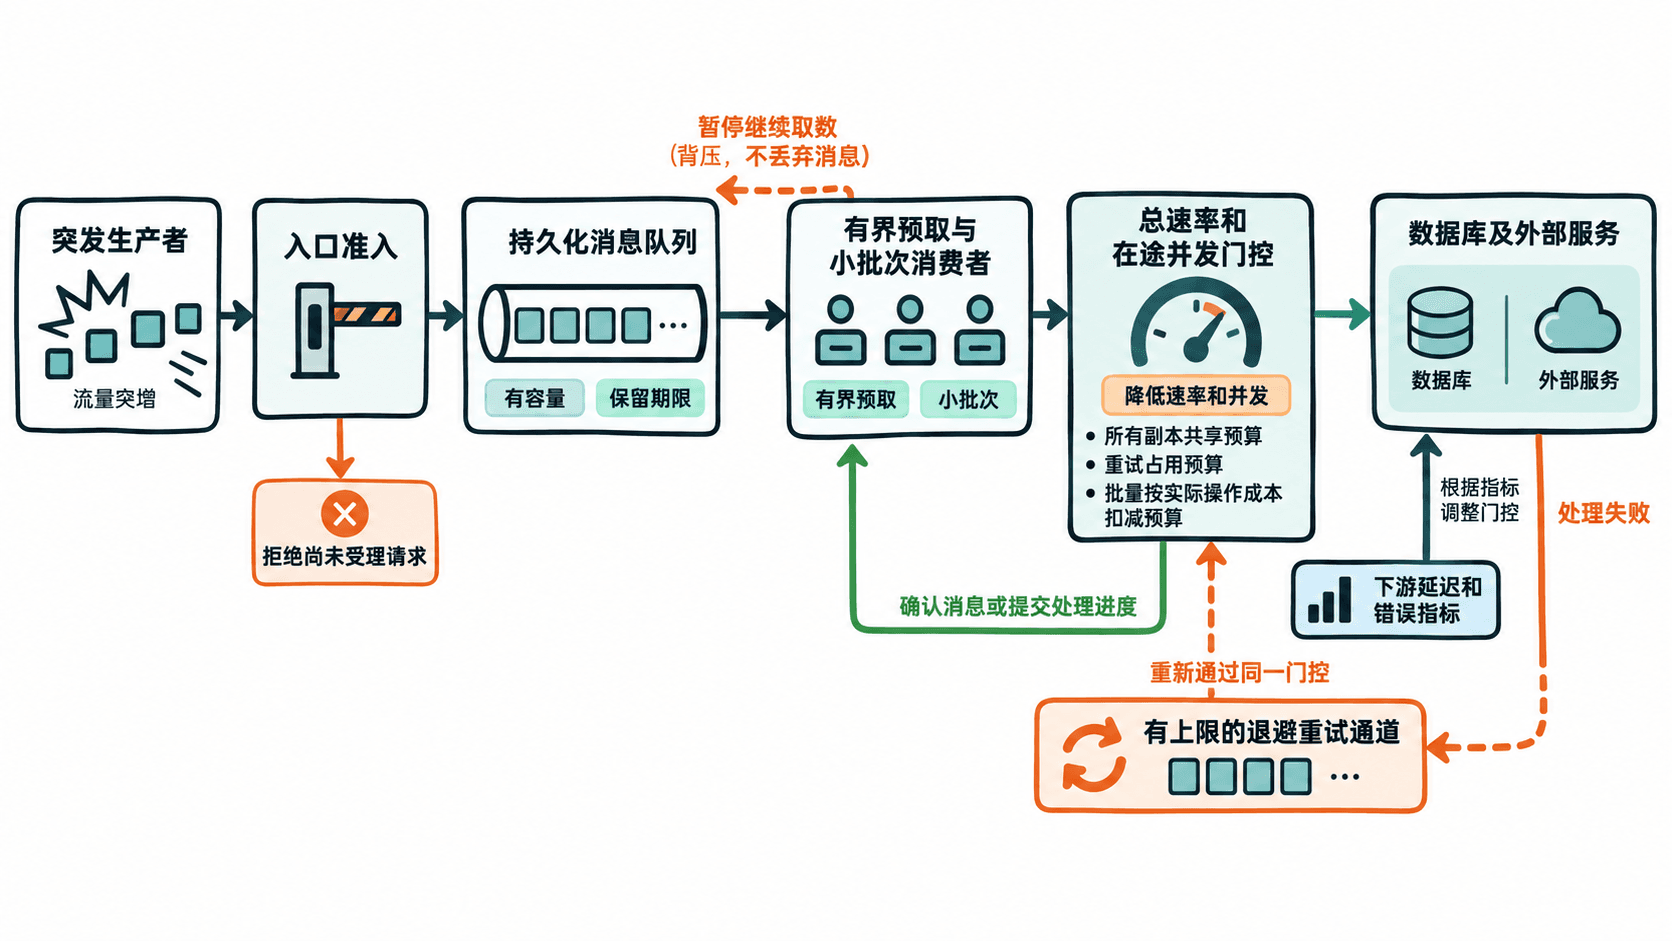
消息队列能暂存突发流量,却不能自动限制消费者对数据库和外部服务的冲击。本篇把缓冲容量、全局速率、在途并发和批量大小分开控制,并用可运行实验验证:入口可以变快,下游仍按安全节奏处理。
学习目标
- 把下游安全容量换算为所有消费者共享的操作预算。
- 组合有界缓冲、消费限速、并发限制和批量提交。
- 在重试与恢复阶段继续保护下游,并验证消息未被静默丢弃。
先给下游分配总预算
先根据真实读写组合的压测结果,扣除同步业务消耗和安全余量,再分配消息处理预算。不要直接把数据库的连接数上限当成吞吐能力,也不要把不同成本的写操作混成同一种请求。
假设下游安全能力为每秒 1000 次等价操作,同步业务占 600 次,预留 200 次,则消息链路共享剩余 200 次。若每条消息需要两次操作,就只能处理 100 条/秒;平均分给四个副本时,每个是 25 条/秒,而不是各自 100 条/秒。
所有访问同一下游的消费者和重试都要纳入预算。多副本可以共享限流器,或领取总和受控的配额;扩缩容和滚动发布时必须重分配额度,防止新旧实例各自拿到完整预算。([Microsoft Learn][5])
让缓冲和消费形成保护闭环
缓冲把突发流量转化成等待时间,不能创造处理能力。若长期生产速率超过安全消费速率,队列仍会不断增长;只根据积压无限扩消费者,会把过载继续传给数据库。([Microsoft Learn][4])
| 控制项 | 限制的对象 | 不能替代什么 |
|---|---|---|
| 有界缓冲 | 等待消息的条数、字节数和保留时间 | 不能替代入口准入与长期容量规划 |
| 消费限速 | 每秒调用数、操作数或处理字节数 | 不能限制慢请求占住的并发数量 |
| 并发上限 | 同时执行的下游请求或事务数量 | 不能保证每秒请求数不超额 |
| 批量边界 | 每批条数、字节数和组批等待时间 | 不能把一批中的所有操作当作一次成本 |
限速与并发需要分别控制:十个并发请求若瞬间完成,下一轮还可以立刻发出;每秒只启动少量请求,若一直不结束,在途请求也会累积。限速解决发送节奏,并发上限限制同时占用的资源。([Microsoft Learn][5])
规划缓冲时,可用“峰值生产率减安全消费率,再乘突发持续时间”估计新增消息量,并另计初始积压、消息字节大小和存储开销。排队时间还必须符合业务期限,不能只看磁盘是否足够。
运行一个有界批量写入实验
下面用 Python 3.11 或以上版本的标准库演示:生产者提交 40 条任务,等待队列最多 10 项,每批最多 5 条,最多等待 100 毫秒凑批,再按 20 条/秒的预算安排写入。只有一个写入者,因此下游在途批次最多为一批。
保存为 buffered_writer.py,执行 python buffered_writer.py。实验使用 SQLite 内存数据库,不创建磁盘数据库,也不连接真实消息中间件;它展示调度与事务提交,不实现进程崩溃后的恢复。
from contextlib import closing
from queue import Empty, Queue
from sqlite3 import connect
from threading import Thread
from time import monotonic, sleep

TOTAL = 40
BATCH_SIZE = 5
ROW_RATE = 20
MAX_WAIT = 0.1

def produce(work: Queue[tuple[int] | None]) -> None:
    # 满队列时阻塞生产者,而不是丢消息或创建无限等待任务。
    for number in range(TOTAL):
        work.put((number,))
    work.put(None)

def main() -> None:
    work: Queue[tuple[int] | None] = Queue(maxsize=10)
    producer = Thread(target=produce, args=(work,), daemon=True)
    # 内存数据库只用于实验,不提供重启后的数据持久性。
    with closing(connect(":memory:")) as db:
        db.execute("CREATE TABLE events (seq INTEGER PRIMARY KEY)")
        started = monotonic()
        next_start = started
        producer.start()
        finished = False
        while not finished:
            item = work.get()
            if item is None:
                work.task_done()
                break
            batch = [item]
            deadline = monotonic() + MAX_WAIT
            # 达到条数或组批等待上限,就处理当前批次。
            while len(batch) < BATCH_SIZE:
                remaining = deadline - monotonic()
                if remaining <= 0:
                    break
                try:
                    item = work.get(timeout=remaining)
                except Empty:
                    break
                if item is None:
                    work.task_done()
                    finished = True
                    break
                batch.append(item)
            # 按行数安排发送时间;停顿后不积累可瞬间花完的额度。
            next_start = max(next_start, monotonic()) + len(batch) / ROW_RATE
            sleep(max(0.0, next_start - monotonic()))
            # 单写入者限制并发为一批,提交成功后才标记任务完成。
            with db:
                db.executemany("INSERT INTO events(seq) VALUES (?)", batch)
            for _ in batch:
                work.task_done()
        producer.join()
        work.join()
        count = db.execute("SELECT COUNT(*) FROM events").fetchone()[0]
        elapsed = monotonic() - started
        print(f"stored={count}")
        print(f"queue_remaining={work.qsize()}")
        print(f"average_rate_ok={count / elapsed <= ROW_RATE}")

if __name__ == "__main__":
    main()
预期输出:
stored=40
queue_remaining=0
average_rate_ok=True
stored=40 表示全部教学任务已写入;average_rate_ok=True 验证本次运行的整体平均速度未超过预算,不代表毫秒级完全平滑。批量写入仍有最多一批的微突发,实际用时会随调度和处理耗时变化。
队列满时,put() 阻塞生产者;已经取出的当前批次不计入队列容量。task_done() 只是本地任务记账,不能替代消息中间件的确认,也不提供持久性。([Python documentation][6])
100 毫秒只限制凑批等待,不包含排队和限速等待。代码按行数而非批次数消耗额度,并把一批写入放在同一事务中。生产环境还应限制批量字节数和事务耗时,失败时按接口的整批或部分成功语义处理,不能盲目重放已成功的操作。([Python documentation][7])
接入消息中间件时保留背压
RabbitMQ 的手动确认模式应配合有限的预取数量;预取限制的是未确认消息数量,不是每秒调用数。事务成功后再确认消息,额度不足时不要继续把大量消息搬进应用内存。([RabbitMQ][8])
Kafka 的 max.poll.records 只限制一次 poll() 返回多少条,不是每秒速率限制,也不限制底层抓取总量。可以对分区使用 pause() 和 resume() 控制交付,但暂停期间仍要及时调用 poll(),不能用长时间睡眠代替消费循环管理。([Apache Kafka][9])
重试必须重新经过相同的速率和并发控制,并设置次数或总时长上限、退避与随机抖动。若下游给出 Retry-After,应尊重其等待要求;可能重复执行的写操作必须具备幂等保护,不能把“请求超时”当成“写入肯定没发生”。([Microsoft Learn][5])
缓存达到高水位时,应暂停可延后的生产或拒绝尚未受理的请求。已接受的关键业务消息不能静默删除;无法处理的消息进入可追踪的隔离或补偿流程,并为恢复重放保留受控预算。([Microsoft Learn][4])
用突发与恢复场景验收
- 突发阶段提高生产速率,确认队列或入口等待增加,而不是下游请求数与连接数失控;示例可把
TOTAL改为 43,检查不足一批的尾部任务也能写完。 - 下游变慢阶段检查在途上限、超时与重试总量;允许积压暂时上升,不允许为了追赶积压自动突破下游预算。
- 恢复阶段逐步提高消费额度,确认旧消息持续消化、重复投递没有重复业务副作用,且重放不会再次压垮下游。
保护是否有效,不看队列是否始终为零,而看下游是否守住预算、已接收消息是否可追踪,以及突发结束后能否在业务期限内恢复。