
架构与系统设计 / 系统课时
为订单链路选择消息中间件
为订单链路选择消息中间件
订单事件需要可靠送达库存、通知和查询投影,但这些需求并不能直接推出某个中间件。本篇给出一组明确的案例约束,比较队列与日志两种消费方式,计算停消费后的积压预算,最终形成带验收门槛和重评条件的选型记录。
学习目标
- 将吞吐、顺序、延迟和可靠性要求改写为可验证的边界。
- 比较 RabbitMQ Quorum Queue 与 Kafka 分区日志对订单链路的适配性。
- 计算积压和恢复期处理能力,写出有条件的选型结论。
先把订单需求变成验收边界
以下数字是教学案例假设,不是产品跑分:事件平均大小为 2 KiB,峰值为每秒 1000 条;库存、通知、查询投影是三个独立订阅。为计算容量上界,假设它们都接收完整订单事件流,而不是三个消费者共同分走一份任务。
本例要求同一订单的状态按因果顺序推进,不要求不同订单全局有序。正常、无积压时,从订单事务提交到消费者业务提交的 P99 延迟不超过 500 毫秒;单个订阅停消费 30 分钟后,应在恢复后的 30 分钟内清完积压。
可靠性边界是:已提交的订单事件不能因一个消息节点故障而静默丢失;允许重复投递,但不允许重复扣库存。不要求任意回看已消费历史,审计另行持久保存。假设团队已有三节点 RabbitMQ 运维经验,没有 Kafka 的值班与恢复经验。
比较消费方式,而不是只比较品牌
这里比较的是 RabbitMQ 4.x 的 Quorum Queue 与 Kafka 4.x 的分区日志、普通消费组,不把它们的某一种数据结构当成整个产品。下表中的差异来自各自的队列、日志和消费模型。([RabbitMQ][5])
| 决策维度 | RabbitMQ Quorum Queue | Kafka 分区日志 |
|---|---|---|
| 三个独立业务订阅 | 为各订阅建立独立队列,同队列消费者竞争处理 | 为各订阅使用不同消费组,各自维护消费位置 |
| 已消费事件重放 | 队列消费确认后不能靠回退位置重读 | 可在保留范围内重新读取日志 |
| 同一订单顺序 | 需要固定路由、串行处理,并处理重投影响 | 稳定分区规则下以订单号为键进入同分区,处理侧仍须保序 |
RabbitMQ Streams 也提供保留和重复读取能力,因此“RabbitMQ 不能重放”不是正确的产品级结论。Kafka 的分区顺序也不是全局顺序;增加分区或改变分区规则后,不能直接沿用原来的同键顺序假设。([RabbitMQ][6])
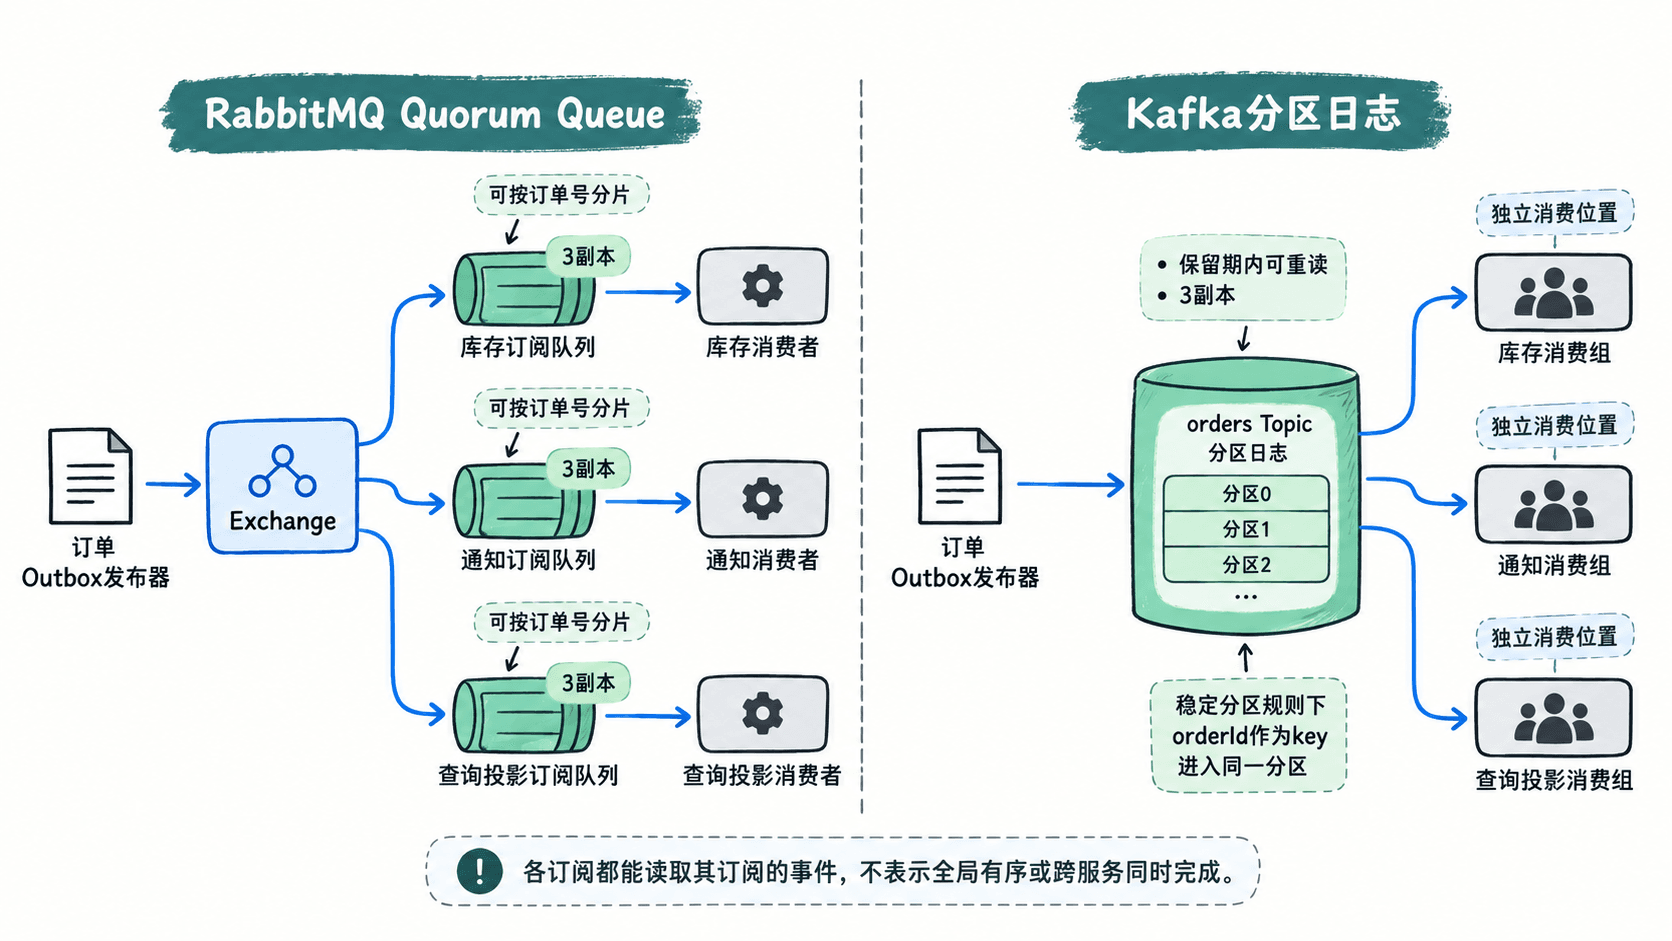
不能根据“队列适合低延迟、日志适合高吞吐”直接签字。应在相同消息大小、复制要求、业务处理逻辑和故障条件下比较;批量发送、热点订单和消费者数据库性能都必须进入测试条件,而不是只测生产者调用返回速度。
为暂定方案补齐可靠性与顺序条件
本例暂选 RabbitMQ Quorum Queue,理由是订阅规模有限、无需任意历史重放,而且团队已有运维基础。每个业务队列配置三个副本并分布在不同节点;多数派可用是队列继续工作的前提,不能把三副本理解为任何故障下都能继续写入。([RabbitMQ][7])
订单与 Outbox 同事务提交,发布器保留未确认事件并重试。AMQP 0-9-1 发布端使用 publisher confirms,并处理 mandatory 消息的退回;确认与“消费者业务已经完成”不是同一件事,未路由消息也可能收到发布确认。([AWS 文档][1])
交换器、订阅队列和绑定也要纳入部署验收。mandatory 只能发现没有任何目标队列的情况,不能证明三个预期订阅都已存在;这一限制决定了不能只凭发布成功率验收整条链路。([RabbitMQ][8])
消费者在本地业务变更和幂等记录一起提交后再确认消息。幂等键包含订阅名称、事件来源与事件标识;调用外部服务还要使用对方支持的业务幂等机制,不能先确认再执行业务。([AWS 文档][1])
即使换成 Kafka,消息事务也不会自动覆盖外部业务数据库的副作用,仍需协调消费位置与业务结果,不能把中间件的事务能力写成端到端“恰好一次”的保证。([Apache Kafka][9])
对严格顺序链路,发布器先按订单版本保序,再把相同订单稳定路由到同一分片队列,每分片使用单活消费者串行处理;不同订单可跨分片并行。失败订单的后续事件不能越过未处理的前序事件;队列的 FIFO 本身不足以替代这些约束。([RabbitMQ][5])
还要设计有界重试、隔离记录和人工补偿入口。隔离了一个事件,不代表相关订单可以直接跳过它继续推进;死信转移本身的可靠性也需要单独配置和验证,不能默认等于可靠交付。([RabbitMQ][7])
先算停消费后的积压预算
使用 Python 3.10 或更高版本,将下面的完整脚本保存为 capacity.py,从该目录执行 python3 capacity.py。按最坏情况,峰值持续覆盖停消费与恢复窗口,三个订阅同时停摆;分片只拆分负载,不改变各订阅要承接的总载荷量。
from math import ceil

event_rate = 1000
message_bytes = 2 * 1024
pause_seconds = 30 * 60
recover_seconds = 30 * 60
subscriptions = 3
replicas = 3

# 每个订阅接收全量事件,停消费期间新增事件全部积压。
pending = event_rate * pause_seconds
payload_gib = pending * message_bytes / (1024 ** 3)
replicated_gib = payload_gib * subscriptions * replicas

# 恢复时仍有新事件进入,必须用额外处理能力消化旧积压。
required_rate = event_rate + ceil(pending / recover_seconds)

print(f"每个订阅积压: {pending} 条")
print(f"每个订阅原始载荷: {payload_gib:.2f} GiB")
print(f"全部订阅三副本逻辑载荷: {replicated_gib:.2f} GiB")
print(f"每个订阅恢复期最低处理速率: {required_rate} 条/秒")
预期输出:
每个订阅积压: 1800000 条
每个订阅原始载荷: 3.43 GiB
全部订阅三副本逻辑载荷: 30.90 GiB
每个订阅恢复期最低处理速率: 2000 条/秒
30.90 GiB 是未压缩的逻辑载荷估算,不是可以照抄的磁盘容量。还要测量存储日志、元数据、重试和副本恢复的开销,并预留余量;每秒 2000 条也是每个订阅的理论最低能力,不是三个订阅合计,更不是已证明能达到的性能。
用验收门槛写下选型结论
选型记录写明约束、候选、暂定方案、取舍和以下验收计划。测试前固定服务器资源、版本、消息分布与业务数据库配置;没有取得实测结果时,结论只能是“有条件采用”,不能写成“已满足生产要求”。
| 验证场景 | 必须收集的证据 |
|---|---|
| 峰值持续输入 | 正常窗口 P99 不超过 500 毫秒,积压不持续增长 |
| 一个消息节点停止 | 恢复后核对事件标识集合,已提交事件不存在无法解释的缺口 |
| 发布确认丢失,或消费提交后未确认即崩溃 | 重投后业务只提交一次,没有重复扣减 |
| 停消费 30 分钟再恢复 | 新流量继续进入时,积压在另外 30 分钟内清完,记录资源峰值 |
副作用成功率、重试次数和事件对账结果必须与延迟一起看,不能只统计成功消息的延迟而隐藏失败与超时。正常时延目标不适用于停消费窗口;故障阶段使用恢复时间和无静默丢失的目标验收。
本案例的决策是:在上述约束及验收门槛成立时,采用 RabbitMQ Quorum Queue。若新增长期重放或大量独立订阅,或积压、恢复能力超出预算,就重新比较 Kafka、RabbitMQ Streams 与托管方案;若组织已有成熟 Kafka 平台,运维前提已经改变,也应重新评估,而不是把本次结论当成固定答案。