
架构与系统设计 / 系统课时
重复消费突然增加怎么查
重复消费突然增加怎么查
重复消费突然增多时,先别急着扩大超时或关闭重试。本篇把“同一消息再次到达”和“同一业务再次生效”拆开,沿确认失败、处理超时、进程重启及幂等失效寻找证据,确定需要修复的环节与验收条件。
学习目标
- 区分记录重读、重复发布和业务重复生效。
- 用确认、超时与进程生命周期证据定位重复来源。
- 验证幂等与恢复行为,避免用提前确认掩盖故障。
先限定重复的统计口径
先固定环境、消息源、逻辑处理器和时间窗口,把同一处理尝试的多条阶段日志合并为一条。分别统计处理尝试数、消息记录数、业务实际生效次数;重复打印“处理成功”不能证明重复扣款。
Kafka 这里指普通消费者组。固定集群和 topic 后,用 (partition, offset) 定位记录,用稳定的 event_id 关联业务;不同消费者组各处理一次可能是正常订阅,不能直接算重复故障。([Apache Kafka][1])
RabbitMQ 的 AMQP 0-9-1 投递标签 delivery_tag 只在通道内标识一次投递,不适合作为稳定幂等键。redelivered 提示原消息重投,却不能识别生产者另发的业务副本,因此仍需记录业务事件标识。([RabbitMQ][2])
对齐业务提交与消费进度
把一次尝试排成“接收、业务事务提交、ACK 或位点提交”。数据库已提交,但消费进度尚未可靠记录时,进程退出后可能再次处理;业务提交成功和消费进度提交成功不是同一件事。([Apache Kafka][1])
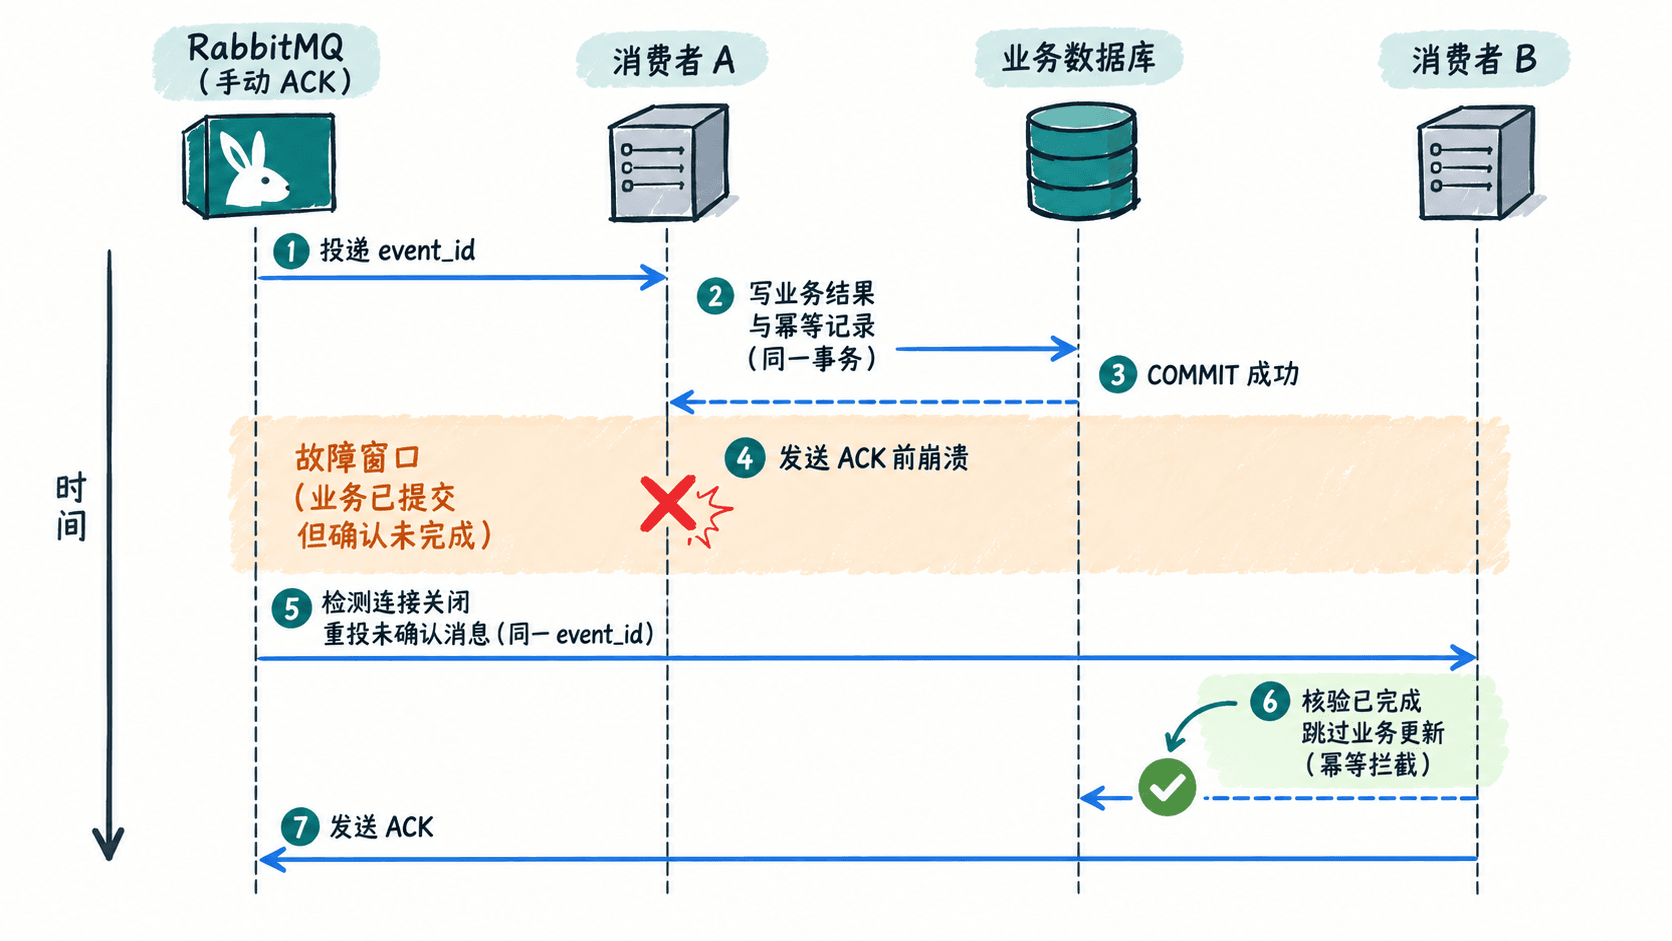
排查时同时保存事件标识、处理尝试标识、实例启动标识、业务事务结果和确认结果。线上标识与时间分别用 <ID>、<TIME> 脱敏,实际值可能不同;“已调用 ACK”只能证明应用执行到该处,不能单独证明 broker 已收到确认。([RabbitMQ][2])
按四类证据收敛根因
先对照故障开始时刻附近的发布、扩缩容和配置变更,再为重复样本找出最后一次成功的业务提交,以及它之后发生的异常。
| 怀疑方向 | 最有区分度的证据 |
|---|---|
| 确认失败 | 业务审计已有结果,随后位点提交失败、连接断开,或 RabbitMQ 使用了错误通道的投递标签。 |
| 消费超时 | 重复峰与批次处理变慢、依赖阻塞、长时间未再次拉取或确认超时日志同时出现。 |
| 进程重启 | 重复集中在退出前的在途记录,并与实例启动、重连或分区交接吻合。 |
| 幂等失效 | 同一业务动作确实生效多次,且伴随幂等键变化、缓存过期、进程内去重丢失或并发竞态。 |
Kafka 的 max.poll.interval.ms 约束相邻 poll() 调用间隔,不是单条消息的业务超时。处理阻塞可能触发成员失效与分区再分配;先缩小批次、修复慢依赖,再结合实际组协议和静态成员设置判断恢复过程。([Apache Kafka][3])
RabbitMQ 的确认超时需要核对版本和队列类型:4.3 起仅 quorum queues 支持该机制。确认超时可关闭通道并使未确认投递重新入队,不能把其他队列的重投一概归因于这个超时。([RabbitMQ][4])
用归一化样本区分重读与重发
以下完整脚本可在 Python 3.10+ 直接运行,无需消息集群。六行固定测试数据属于同一集群、topic、消费者组和逻辑处理器;每行代表一次独立处理尝试,不是 broker 原生日志格式。
元组依次是事件标识、分区、位点、此次新增业务效果数。最后一项必须来自已提交的业务审计:本例用 1 表示实际生效一次,0 表示被幂等拦截,而不是按应用日志出现次数填写。
from collections import defaultdict

def main() -> None:
    # 固定测试样本;真实日志需先按处理尝试标识去重。
    attempts = [
        ("evt-a", 0, 100, 1),
        ("evt-a", 0, 100, 0),
        ("evt-b", 0, 101, 1),
        ("evt-b", 0, 102, 0),
        ("evt-c", 1, 200, 1),
        ("evt-c", 1, 200, 1),
    ]
    grouped = defaultdict(list)
    for event_id, partition, offset, applied in attempts:
        grouped[event_id].append((partition, offset, applied))
    print("event attempts records effects")
    for event_id, rows in sorted(grouped.items()):
        # 位点必须连同分区比较;业务效果与投递次数分别计数。
        records = len({(p, o) for p, o, _ in rows})
        effects = sum(applied for _, _, applied in rows)
        print(event_id, len(rows), records, effects)

if __name__ == "__main__":
    main()
预期输出:
event attempts records effects
evt-a 2 1 1
evt-b 2 2 1
evt-c 2 1 2
evt-a 是同一记录再次处理,但业务只生效一次,应追查确认、重启或人工回放;evt-b 有两份记录,应检查生产重试、应用补发及回放路径;evt-c 已证明幂等防线失效。计数只是排查方向,不能据此断言某次重启就是根因。
若出现两份记录,还应检查生产端确认超时与补发日志。RabbitMQ 的 publisher confirm 丢失后,生产者可能重新发布已被 broker 接收的消息;这与消费者 ACK 失败引发原消息重投是两条不同路径。([RabbitMQ][5])
若生产者为同一业务动作不断生成新 event_id,还要按业务动作唯一键关联审计,否则这段按事件标识聚合的脚本会漏报。业务动作键应区分合法的不同动作,不能只用订单号。
修复要同时验证重复与漏处理
已经出现重复业务效果时,先暂停受影响处理器或隔离危险写入,保留源消息与审计。确认失败要修复连接、提交时机或通道使用;重启问题要检查停止接收、排空在途和提交已完成进度的退出顺序。
本地幂等可使用 (handler, event_id) 唯一约束,并把幂等记录与业务更新放在同一数据库事务中;只有明确的重复键冲突才能进入跳过分支,不能吞掉其他数据库错误。([microservices.io][6])
幂等记录的保留期应覆盖最大重放窗口。外部扣款等调用不在本地事务里,因此还需下游幂等键与结果核对;仅写一条本地“已处理”记录,不能解决外部调用结果未知的问题。
- 在测试环境的业务提交之后、ACK 或位点提交之前终止进程,再恢复消费。允许再次收到事件,但同一业务动作必须只生效一次。
- 并发重放同一事件,重启实例,并回放超过原缓存过期时间的样本。核对幂等冲突、实际业务效果、消费进度,以及未完成消息和死信的去向。
不要为压低重复率而提前 ACK 或提交位点。验收要同时证明没有重复业务效果、没有未处理却被确认的消息,并且故障解除后积压能够恢复。([RabbitMQ][5])