
架构与系统设计 / 系统课时
模拟积压和消费者故障
模拟积压和消费者故障
订单事件在正常环境中能消费,并不代表发生故障后仍能可靠收敛。本篇用隔离队列制造慢消费、提交后崩溃和下游超时,通过队列计数与业务账本验证重试有上限、恢复不重复执行。
学习目标
- 复现慢消费和进程退出,区分待投递消息与未确认消息。
- 验证业务提交后、ACK 前崩溃时,重投不会重复产生业务结果。
- 通过有限重试、失败隔离和事件对账,判断系统是否真正恢复。
建立隔离实验与验收账本
本篇独立使用 Python 3.11、Pika 1.3.2 与 RabbitMQ 4.x,命令运行于 Linux 或 WSL 的 Bash。准备可用的 Docker,在全新目录执行;只连接本课专用容器,不对生产队列注入故障。RabbitMQ 官方安装说明提供了这里使用的 rabbitmq:4-management 镜像入口。([RabbitMQ][1])
lab.orders 保存待处理事件,lab.orders.failed 保存持续失败事件。SQLite 的 effects 表就是实验中的业务结果,每个 eventId 最多对应一行。消息投递次数可以增加,但业务结果不能跟着增加。
# 只向本机开放 AMQP,实验凭据不得用于生产环境。
docker run -d --name eda-fault -p 127.0.0.1:5673:5672 -e RABBITMQ_DEFAULT_USER=lab -e RABBITMQ_DEFAULT_PASS=lab-only rabbitmq:4-management
python3 -m venv .venv
. .venv/bin/activate
python -m pip install pika==1.3.2
# 有限等待应用就绪;未打印就绪标记时不要开始发送消息。
timeout 60s bash -c 'until docker exec eda-fault rabbitmq-diagnostics -q check_running >/dev/null 2>&1; do sleep 1; done' && printf 'broker_ready\n'
预期输出,省略镜像下载、容器 ID 与依赖安装日志:
broker_ready端口 5673 是本例固定配置,不是随机输出。端口被占用时,要同时修改映射与后面脚本的连接端口;就绪检查超时则先检查容器是否退出,不要重复启动同名容器。本实验只验证消费者故障,不验证代理节点故障或集群高可用。
实现可控的故障开关
消费者采用手动 ACK,并把预取量设为 1。业务提交后才确认消费;连接关闭时,未确认消息会被重新入队,因此恢复逻辑必须允许重复投递。发布确认与消费 ACK 是两个独立环节,不能相互替代。([RabbitMQ][2])
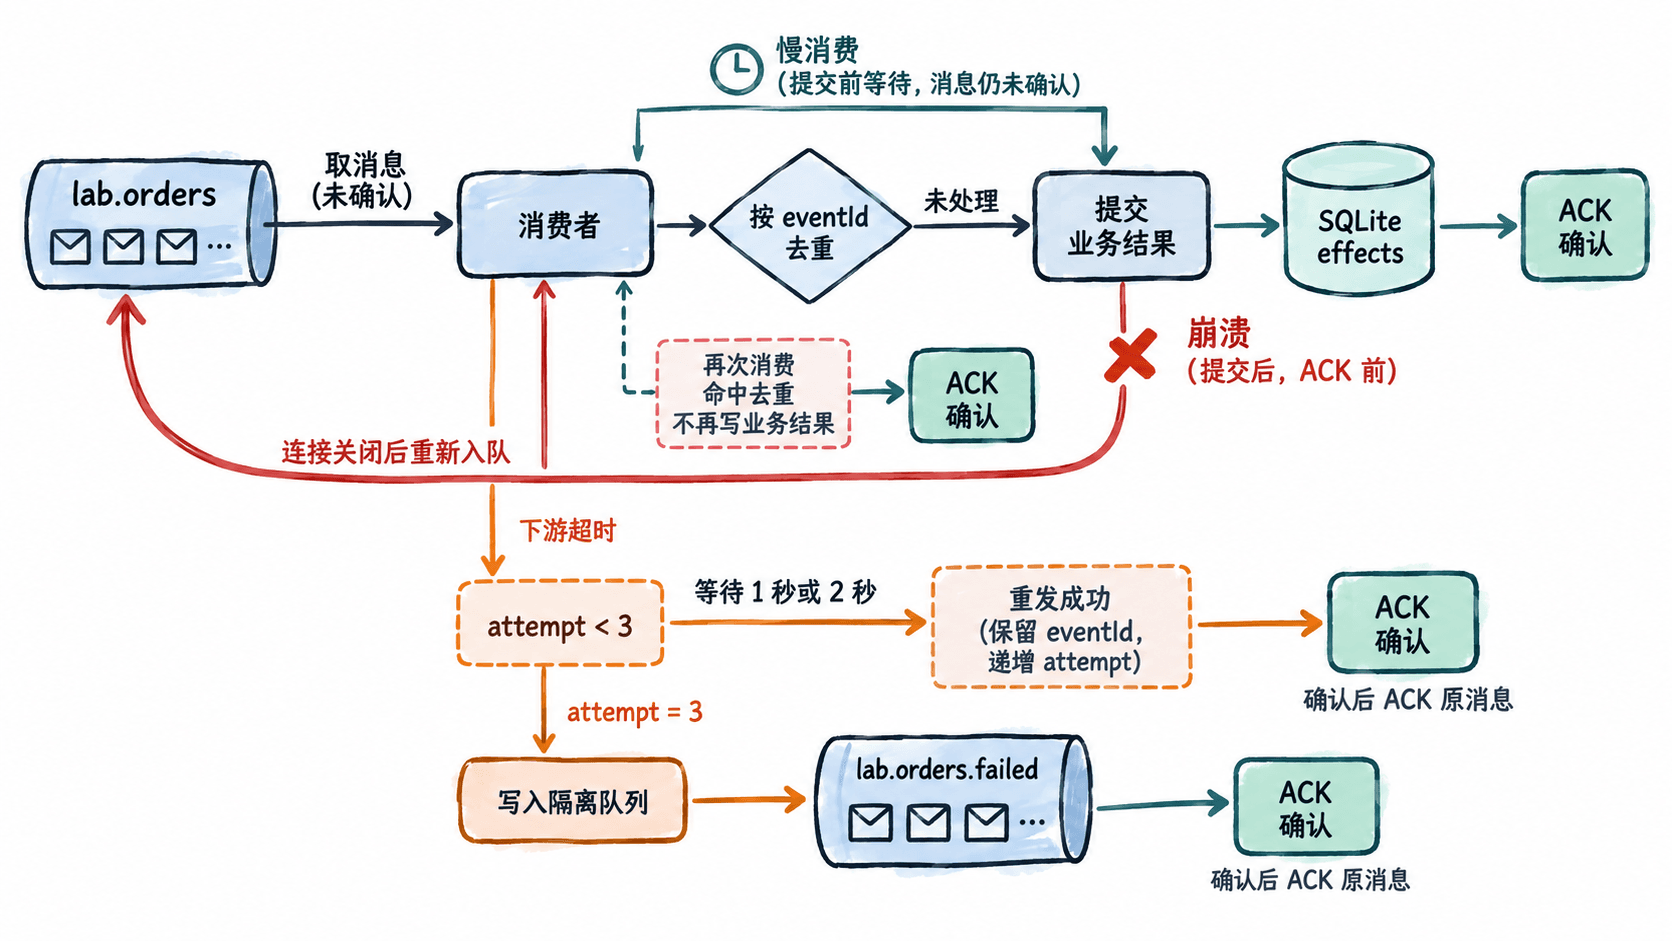
将下面完整程序保存为 fault_lab.py。--count 对发送端表示事件数,对消费端表示要完成的终态事件数,重试本身不占这个名额。confirm_delivery() 配合 mandatory=True,让无法确认或无法路由的重发通过异常中止,而不是继续删除原消息。([Pika][3])
import argparse
import json
import os
import sqlite3
import uuid
import pika

QUEUE = "lab.orders"
FAILED = "lab.orders.failed"

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("mode", choices=["seed", "work"])
    parser.add_argument("--count", type=int, default=1)
    parser.add_argument("--delay", type=float, default=0)
    parser.add_argument("--fail-until", type=int, default=0)
    parser.add_argument("--crash", action="store_true")
    args = parser.parse_args()
    if args.count < 1 or args.delay < 0 or args.fail_until < 0:
        parser.error("count must be positive; delays and attempts cannot be negative")

    db = sqlite3.connect("effects.db")
    db.execute("CREATE TABLE IF NOT EXISTS effects "
               "(event_id TEXT PRIMARY KEY, order_id TEXT NOT NULL)")
    connection = pika.BlockingConnection(pika.ConnectionParameters(
        host="127.0.0.1", port=5673,
        credentials=pika.PlainCredentials("lab", "lab-only"),
        heartbeat=30, blocked_connection_timeout=10))
    try:
        channel = connection.channel()
        for name in (QUEUE, FAILED):
            channel.queue_declare(queue=name, durable=True,
                                  arguments={"x-queue-type": "classic"})
        channel.confirm_delivery()

        def publish(event, target, attempt):
            # 先得到发布确认;失败就抛出异常,不能继续 ACK 原消息。
            channel.basic_publish(
                exchange="", routing_key=target, mandatory=True,
                body=json.dumps(event).encode(),
                properties=pika.BasicProperties(
                    delivery_mode=2, content_type="application/json",
                    message_id=event["eventId"], headers={"attempt": attempt}))

        if args.mode == "seed":
            for _ in range(args.count):
                publish({"eventId": str(uuid.uuid4()),
                         "orderId": str(uuid.uuid4()),
                         "type": "OrderConfirmed"}, QUEUE, 1)
            print(f"published={args.count}")
            return

        remaining = args.count
        def consume(ch, method, properties, body):
            nonlocal remaining
            event = json.loads(body)
            attempt = int((properties.headers or {}).get("attempt", 1))
            terminal = True
            exists = db.execute("SELECT 1 FROM effects WHERE event_id=?",
                                (event["eventId"],)).fetchone()
            if exists:
                result = "duplicate"
            else:
                try:
                    # 使用连接自带的等待方法,慢处理时仍维护心跳。
                    connection.sleep(args.delay)
                    if attempt <= args.fail_until:
                        raise TimeoutError("injected downstream timeout")
                    with db:
                        inserted = db.execute(
                            "INSERT OR IGNORE INTO effects VALUES (?, ?)",
                            (event["eventId"], event["orderId"])).rowcount
                    # 专门击中业务提交成功、ACK 尚未发送的窗口。
                    if args.crash and inserted:
                        print(f"crash_after_commit event_id={event['eventId']}",
                              flush=True)
                        os._exit(42)
                    result = "applied" if inserted else "duplicate"
                except TimeoutError:
                    if attempt < 3:
                        connection.sleep(2 ** (attempt - 1))
                        publish(event, QUEUE, attempt + 1)
                        result, terminal = f"retry next={attempt + 1}", False
                    else:
                        publish(event, FAILED, attempt)
                        result = "quarantined"
            ch.basic_ack(delivery_tag=method.delivery_tag)
            print(f"result={result} attempt={attempt} "
                  f"redelivered={method.redelivered} event_id={event['eventId']}",
                  flush=True)
            if terminal:
                remaining -= 1
                if remaining == 0:
                    ch.stop_consuming()

        channel.basic_qos(prefetch_count=1)
        channel.basic_consume(queue=QUEUE, on_message_callback=consume,
                              auto_ack=False)
        channel.start_consuming()
        print("effects=" + str(db.execute("SELECT COUNT(*) FROM effects").fetchone()[0]))
    finally:
        if connection.is_open:
            connection.close()
        db.close()

if __name__ == "__main__":
    main()
预期结果:程序通过 seed 与 work 两个入口运行。先执行一次无故障基线,确认环境、发送和落库全部正常:
# 新目录中的 effects.db 应为空;这条基线只创建一个业务结果。
python fault_lab.py seed
python fault_lab.py work
预期输出:
published=1
result=applied attempt=1 redelivered=False event_id=<ID>
effects=1
<ID> 是运行时生成的事件标识,同一事件的不同尝试必须保持一致。故障开关用 TimeoutError 模拟下游超时,不代表真的调用了库存接口;它用于隔离验证重试逻辑。等待使用 connection.sleep(),避免慢消费实验意外变成心跳丢失实验。([Pika][4])
依次执行三类故障
先注入慢消费:一次发送 5 条,每条处理前等待 2 秒。脚本放在后台只是为了让同一终端能够采样队列;它不是额外增加一个消费者。
# 先制造有限积压,再观察消费者逐条处理。
python fault_lab.py seed --count 5
python fault_lab.py work --count 5 --delay 2 >slow.log 2>&1 &
worker_pid=$!
sleep 1
docker exec eda-fault rabbitmqctl -s list_queues name messages_ready messages_unacknowledged | sort
# 等本批真正结束,再检查业务结果,而不是只看队列瞬时下降。
wait "$worker_pid"
tail -n 1 slow.log
预期输出,采样计数用占位符表示:
published=5
lab.orders <READY> <UNACKED>
lab.orders.failed 0 0
effects=6队列行的后两列依次是待投递数和未确认数,实际以制表符分隔。<READY> 随采样时间下降,<UNACKED> 通常为 1,交接瞬间也可能为 0;这些计数含义由 rabbitmqctl list_queues 定义。不要把“已经投递给消费者”当作“业务已经完成”。([RabbitMQ][5])
接着击中最危险的窗口:业务已经提交,进程却没来得及 ACK。下面主动退出的是实验消费者进程,不是 RabbitMQ 容器。
python fault_lab.py seed
# 把预期非零退出放进条件分支,兼容开启 set -e 的终端。
if python fault_lab.py work --crash; then
  printf 'unexpected_success\n'
else
  printf 'exit=%s\n' "$?"
fi
# 取消故障开关,等待代理重新投递原事件。
python fault_lab.py work
预期输出:
published=1
crash_after_commit event_id=<ID>
exit=42
result=duplicate attempt=1 redelivered=True event_id=<ID>
effects=7
恢复后的结果必须是去重命中,而不是第二次新增。RabbitMQ 需要先识别连接关闭,重投并不承诺瞬时发生;重启期间不得删除 effects.db,否则会把已有业务结果和去重证据一起丢掉。([RabbitMQ][2])
最后模拟下游前两次超时、第三次恢复。只对明确的临时错误重试,示例不是捕获所有异常后无限重发。
# attempt 从 1 开始,前两次失败分别等待 1 秒和 2 秒。
python fault_lab.py seed
python fault_lab.py work --fail-until 2
预期输出:
published=1
result=retry next=2 attempt=1 redelivered=False event_id=<ID>
result=retry next=3 attempt=2 redelivered=False event_id=<ID>
result=applied attempt=3 redelivered=False event_id=<ID>
effects=8
这里的应用重试是重新发布消息,因此 redelivered 仍可以是 False;它不能替代应用的尝试计数。把故障持续到重试上限之外,再验证失败没有被悄悄吞掉:
# 故障持续存在,但消费者仍只允许初次执行加两次重试。
python fault_lab.py seed
python fault_lab.py work --fail-until 99 | tail -n 2
docker exec eda-fault rabbitmqctl -s list_queues name messages_ready messages_unacknowledged | sort
预期输出:
published=1
result=quarantined attempt=3 redelivered=False event_id=<ID>
effects=8
lab.orders 0 0
lab.orders.failed 1 0
按业务结果验收与恢复
按上述顺序执行后,共发布了 9 个唯一事件:8 个形成业务结果,1 个留在隔离队列,主队列没有待投递或未确认消息。按 eventId 核对这个关系,不要用包含重复投递的累计次数对账。
隔离队列由应用主动写入,并不是已经配置了代理死信策略。修复下游后,重放应保留原 eventId,记录重放批次并先小批量验证;不能换一个新标识绕过去重,也不能只清空队列让监控变绿。
生产中,长时间退避应交给持久化调度或延迟重试机制,避免占住消费并发;并增加抖动、限流和重试预算。业务去重记录必须与实际业务变更处于同一事务,外部扣款等副作用还需要下游支持幂等键,不能靠本地一张表假定已经覆盖。
这次有限批量能够消退,只证明撤销故障后可以恢复。持续流入时,还要确认成功处理速率长期大于新增事件速率,并记录积压消退时间、重复副作用数和未解决事件数。演练结束后只清理本课专用容器与实验数据,不操作共享队列。