
智能制造与工业软件 / 系统课时
针对难例和新批次复测模型
针对难例和新批次复测模型
缺陷检测模型在常规测试集上表现良好,也可能在金属反光、工件偏移、背景变化或更换生产批次后发生漏检。本课建立一套可重复执行的分组回归评测方法,通过固定测试条件、计算分类指标和追溯错误案例,判断模型是否需要补充样本、重新训练或暂停上线。
学习目标
- 设计覆盖反光、位置偏移、背景变化和新批次的独立复测集。
- 使用 Python 按场景统计漏检、误剔及缺陷召回率,并定位错误样本。
- 根据错误归因和验收门槛,决定补充采样、调整成像条件或重新训练。
固定模型版本与复测边界
回归评测要回答一个具体问题:在模型、阈值和部署配置不变的情况下,生产条件发生合理变化后,检测性能是否仍然满足要求。
假设产线采用二分类缺陷模型,输出范围为 0~1 的缺陷概率,阈值固定为 0.50。概率大于或等于阈值时判定 NG,否则判定 OK。这里的 NG 表示检测到缺陷,OK 表示未检测到缺陷。
复测前冻结以下内容:
- 模型权重与版本,例如
defect-v1.4.2,同时记录文件 SHA-256 校验值。 - 图像预处理,包括输入尺寸、颜色通道顺序、归一化方式和 ROI 裁剪规则。
- 推理阈值 0.50,以及实际使用的推理框架版本。
- 相机曝光、增益、光源亮度和相机安装位置。
- 标注规范、样本唯一编号及生产批次编号。
不要在测试过程中看到某组结果不理想,就临时修改该组的阈值。这会破坏不同模型版本之间的可比性。如果确实需要重新选择阈值,应使用独立验证集确定,再对未参与选择的测试集重新评测。
按以下场景建立测试子集。表中扰动范围是示例产线的初始测试设计,正式使用前必须根据设备公差和实际生产波动调整。
| 场景 | 测试条件 | 重点观察 |
|---|---|---|
| baseline | 正常光照、标准工件位置、原生产批次 | 基准性能是否退化 |
| glare | 改变反射角度,覆盖局部高亮和轻微过曝 | 反光是否掩盖划痕或污点 |
| shift | 工件平移 ±10 px、旋转 ±5°,保持完整进入 ROI | 定位偏移是否造成漏检 |
| background | 更换托盘颜色或改变允许范围内的背景纹理 | 模型是否错误依赖背景 |
| new_batch | 至少选取 3 个未参与训练的新生产批次 | 材质、纹理和加工差异是否造成性能下降 |
每组初步准备不少于 100 张真实缺陷图像和 100 张真实正常图像,并尽量覆盖缺陷尺寸、位置和严重程度。这个数量只适合初步发现回归风险,不足以单独证明极低的漏检概率。
同一工件的连续拍摄图像、裁剪版本和增强版本必须作为关联样本管理,不能分别泄漏到训练集和独立测试集中。对于新批次,还需要按批次整体隔离,而不是从同一批次随机抽取部分图像进行训练、另一部分进行验收。
按场景计算回归指标
工业缺陷检测不能只看整体准确率。假设 1000 件工件中只有 10 件有缺陷,模型全部判为正常,也能得到 99% 的准确率,但实际漏检了全部缺陷。
以缺陷为正类,需要记录四种结果:
- TP:真实有缺陷,模型判定有缺陷。
- FN:真实有缺陷,模型判定无缺陷,即漏检。
- FP:真实无缺陷,模型判定有缺陷,即误剔。
- TN:真实无缺陷,模型判定无缺陷。
缺陷召回率为 ,误剔率为 。前者越高越好,后者越低越好。不要把误剔率与精确率或整体错误率混淆。
下面使用 Python 3.9 及以上版本的标准库实现一个独立复测脚本。实际项目中,应先使用冻结的模型完成推理,再将逐张预测结果导出为 CSV。
创建 predictions.csv。以下数据是用于验证评测程序的模拟样本,并非真实产线统计结果。
group,part_id,truth,score
baseline,b01,1,0.95
baseline,b02,1,0.83
baseline,b03,0,0.08
baseline,b04,0,0.10
glare,g01,1,0.42
glare,g02,1,0.80
glare,g03,0,0.15
glare,g04,0,0.68
shift,s01,1,0.78
shift,s02,1,0.74
shift,s03,0,0.30
shift,s04,0,0.20
background,c01,1,0.71
background,c02,1,0.59
background,c03,0,0.13
background,c04,0,0.60
new_batch,n01,1,0.36
new_batch,n02,1,0.68
new_batch,n03,0,0.40
new_batch,n04,0,0.30
其中 truth 是人工确认的真实标签,score 是模型输出的缺陷概率。真实导出时应额外保存图像路径、批次、模型版本和拍摄条件,用于后续错误追溯。
创建 retest.py,与 CSV 放在同一目录。
import csv
from collections import defaultdict

# 固定场景与阈值,避免根据测试结果临时修改判定规则
groups = ("baseline", "glare", "shift", "background", "new_batch")
counts = defaultdict(lambda: {"TP": 0, "FN": 0, "FP": 0, "TN": 0})
mistakes = []
seen = set()

with open("predictions.csv", encoding="utf-8", newline="") as file:
    for row in csv.DictReader(file):
        group, pid = row["group"], row["part_id"]
        truth, score = int(row["truth"]), float(row["score"])

        # 排除重复工件编号、非法标签和越界概率
        if (pid in seen or group not in groups
                or truth not in (0, 1) or not 0 <= score <= 1):
            raise ValueError(f"无效记录: {row}")
        seen.add(pid)

        prediction = int(score >= 0.50)
        kind = ("TP" if truth else "FP") if prediction else ("FN" if truth else "TN")
        counts[group][kind] += 1

        if truth != prediction:
            mistakes.append(f"{group}/{pid}/{kind}")

# 每组分别计算指标,不让正常场景掩盖难例退化
for group in groups:
    c = counts[group]
    pos = c["TP"] + c["FN"]
    neg = c["FP"] + c["TN"]
    if not pos or not neg:
        raise ValueError(f"{group} 缺少正例或负例")
    print(f"{group}: TP={c['TP']} FN={c['FN']} FP={c['FP']} TN={c['TN']} "
          f"recall={c['TP']/pos:.0%} fpr={c['FP']/neg:.0%}")

print("错例:", ", ".join(mistakes))
在终端执行 python retest.py。
预期输出:
baseline: TP=2 FN=0 FP=0 TN=2 recall=100% fpr=0%
glare: TP=1 FN=1 FP=1 TN=1 recall=50% fpr=50%
shift: TP=2 FN=0 FP=0 TN=2 recall=100% fpr=0%
background: TP=2 FN=0 FP=1 TN=1 recall=100% fpr=50%
new_batch: TP=1 FN=1 FP=0 TN=2 recall=50% fpr=0%
错例: glare/g01/FN, glare/g04/FP, background/c04/FP, new_batch/n01/FN
这组模拟数据说明:基准场景没有错误,不代表模型能够处理反光和新批次。尤其是 glare/g01 与 new_batch/n01,真实有缺陷却被判为正常,需要优先分析。
由于演示集中每组只有两张缺陷图和两张正常图,50% 或 100% 的结果仅用于验证计算逻辑,不能用于实际模型验收。
逐张追溯错误与判断根因
发现 FN 或 FP 后,不应立即把所有错例加入训练集。首先要区分成像问题、定位问题、标注问题和模型泛化问题,否则重新训练可能掩盖真实故障。
建议按照以下顺序检查:
- 打开原始图像和模型实际输入的 ROI,确认缺陷仍然位于有效检测区域内。
- 对照采集记录,检查曝光、增益、光源状态、工件位置和背景差异。
- 核对人工标签,确认划痕、污点或纹理变化是否符合缺陷验收标准。
- 复查预测概率、分类阈值和模型版本,确认推理配置与基准测试相同。
- 为每张错例记录根因分类、缺陷严重程度以及建议处理方式。
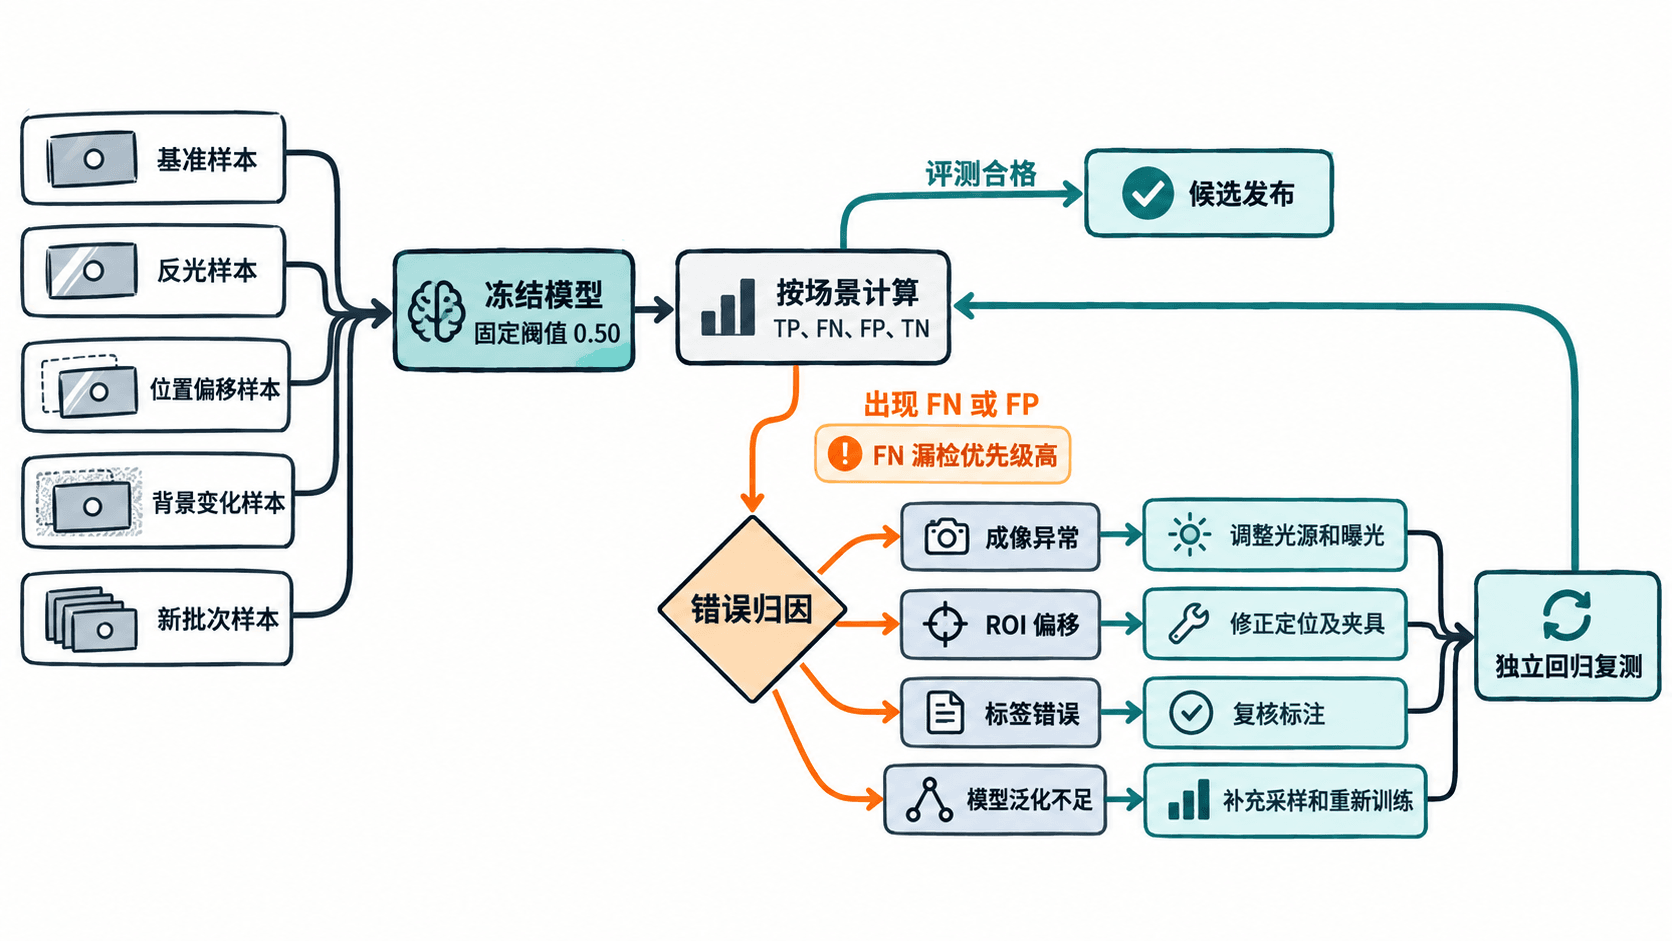
针对模拟结果中的三类典型错误,可按以下方式处理。
| 错误样本 | 可能原因 | 优先检查与措施 |
|---|---|---|
| glare/g01,FN | 高光覆盖真实缺陷 | 检查饱和像素比例、光源角度和缺陷可见性,必要时改善成像 |
| background/c04,FP | 模型把背景纹理误判为缺陷 | 检查 ROI 是否混入背景,随后补充代表性正常样本 |
| new_batch/n01,FN | 新批次材质或表面纹理分布变化 | 对比不同批次的纹理与缺陷特征,补采并评估复训 |
例如,在反光组中发现缺陷区域有大量像素达到相机灰度上限 255,应先排查曝光或照明。对于已经饱和、无法恢复缺陷细节的图像,单纯重新训练通常不能可靠找回丢失的信息。
对于工件偏移,若已经超出规定的 ±10 px 测试范围,应先判断是否发生夹具或定位异常。不能把超出设备设计边界的样本与正常允许扰动混在一起,然后把所有错误归咎于分类模型。
建议为错误记录增加 root_cause、severity、batch_id、image_id 和 model_version 等字段。这里是项目自定义的追溯字段,不是检测框架自动提供的标准输出。
确定补充采样、复训和发布条件
不同错误需要不同措施。可以将处理策略分成三级,并为每一级设置可验证的完成条件。
| 发现的问题 | 处理动作 | 完成条件 |
|---|---|---|
| 曝光过度或 ROI 截断 | 调整采集参数或定位规则 | 同一异常条件下重新成像,缺陷清晰且 ROI 完整 |
| 少量难例表现下降 | 补采相应难例和正常对照样本 | 补充覆盖真实变化范围,标注通过复核 |
| 多个新批次持续漏检 | 重新训练或调整模型方案 | 新模型通过未参与训练的独立批次验收 |
补充采样时,不要只增加模型判错的缺陷图片,还要收集同样光照、背景和材质条件下的正常工件。否则模型可能通过过度敏感来减少 FN,却显著增加 FP,使正常工件大量误剔。
一个可执行的复训安排是:
- 保留原有独立测试集,不用它直接参与训练或超参数选择。
- 为每类主要失效模式新增一批真实样本,例如 200 张缺陷图与 200 张正常图,按工件和批次划分训练、验证数据。
- 使用新增训练数据进行复训,在验证集上选择固定阈值。
- 使用原有独立测试集和额外保留的新批次测试集,同时对比旧模型与新模型。
- 记录每组的 TP、FN、FP、TN、样本数量和模型版本;若关键场景退化,则不替换线上版本。
以上新增样本数量是采样计划示例,并非所有工业产线通用的最低要求。对于极少见的严重缺陷,还需要考虑缺陷合成、专门试件以及独立的人工复核流程,但不能把人工合成样本直接等同于真实生产分布的可靠性证据。
假设某条产线的示例验收要求为缺陷召回率不低于 99%,正常工件误剔率不高于 1%。必须在每个关键难例组和新批次组分别评估,不允许用整体平均值掩盖单组未达标。
还要考虑样本数量造成的统计不确定性。即使测试了 100 张缺陷图并且没有漏检,也不能据此认为真实召回率必然达到 99%。在样本独立且具有代表性等假设下,300 张缺陷样本零漏检,才能使用近似的三法则,将漏检率的单侧 95% 置信上界估计到约 1%。对误剔率也需要独立的正常样本数量支持。
因此,正式发布前至少检查以下结果:
- 原基准测试集不存在不可接受的性能回退。
- 反光、偏移、背景变化和每个关键新批次的指标分别达到项目规定门槛。
- 所有高严重程度 FN 已完成原因分析和风险处置。
- 模型文件、阈值、预处理参数、测试样本清单和评测报告均可追溯。
- 对样本不足或尚未覆盖的生产条件,保留人工复核或其他经过验证的检测措施,不宣称已经完成可靠性验证。
只有修正后的模型在独立测试集上满足要求,且实际生产成像条件处于规定范围内,才能考虑替换线上版本。对于尚未通过验收的新批次,应继续使用已验证的检测方案或执行隔离复检,而不是通过临时降低检测阈值来掩盖漏检风险。