
智能制造与工业软件 / 系统课时
用 PR 曲线选取告警阈值
用 PR 曲线选取告警阈值
缺陷检测模型输出的置信度不能直接当作产线判定结果。阈值过低会频繁误报,阈值过高又可能放过真实缺陷。本课通过一组可复现的验证数据,计算不同阈值下的误检和漏检,并结合 PR 曲线与质量约束选出可执行的告警阈值。
学习目标
- 正确计算精确率、召回率、混淆矩阵及良品误检率。
- 使用验证数据绘制和解读 PR 曲线上的阈值工作点。
- 根据产线漏检风险、误检成本和质量要求选择并验证告警阈值。
固定正负样本与统计口径
先明确一个工件是否属于缺陷品。本例将真实缺陷工件记为正类(1),合格工件记为负类(0)。模型输出缺陷置信度,范围为 0~1;当置信度大于或等于阈值时,系统发出缺陷告警,否则放行。
以工件为统计单位,四种结果如下:
| 真实情况 | 模型告警:缺陷 | 模型放行:良品 |
|---|---|---|
| 实际缺陷 | TP:正确检出 | FN:漏检 |
| 实际良品 | FP:误检 | TN:正确放行 |
对于工业检测,FN 通常直接影响产品质量;FP 则导致人工复核、停线或不必要的剔除。两种错误的业务代价可能相差很大。
三个指标分别为:
- 精确率:,表示告警工件中真正有缺陷的比例。
- 召回率:,表示全部真实缺陷中被成功检出的比例。
- 良品误检率:,表示实际良品中被错误告警的比例。
例如,100 件真实缺陷中检出 92 件,则召回率为 92%;900 件良品中误报 36 件,则良品误检率为 4%。
如果检测器输出多个缺陷框,应先规定框与真实缺陷的匹配规则,例如 IoU 阈值、类别一致性及重复框处理,再汇总到工件级判定。不能直接把框级 PR 指标当成整件产品的放行可靠性。
扫描置信度阈值并计算指标
假设验证集包含 1000 件工件,其中 100 件有缺陷、900 件合格。我们构造一组固定的模型分数分布,分别测试阈值 0.30、0.50、0.70 和 0.85。
下面使用 Python 3 标准库实现统计,不需要安装第三方依赖。实际使用时,应将示例数据替换成模型在独立验证集上的真实预测记录。
# 每组表示(缺陷置信度,工件数量)
positive = [(0.90, 70), (0.75, 16), (0.60, 6), (0.40, 4), (0.10, 4)]
negative = [(0.90, 4), (0.75, 8), (0.60, 24), (0.40, 54), (0.10, 810)]

# 真实缺陷为 1,真实良品为 0
samples = (
    [(1, score) for score, count in positive for _ in range(count)]
    + [(0, score) for score, count in negative for _ in range(count)]
)

print('阈值 TP FP FN TN 精确率 召回率 良品误检率')

for threshold in (0.30, 0.50, 0.70, 0.85):
    # 分数达到阈值就告警,未达到则放行
    tp = sum(label == 1 and score >= threshold for label, score in samples)
    fp = sum(label == 0 and score >= threshold for label, score in samples)
    fn = sum(label == 1 and score < threshold for label, score in samples)
    tn = sum(label == 0 and score < threshold for label, score in samples)

    precision = tp / (tp + fp) if tp + fp else 0.0
    recall = tp / (tp + fn) if tp + fn else 0.0
    fpr = fp / (fp + tn) if fp + tn else 0.0

    print(f'{threshold:.2f} {tp} {fp} {fn} {tn} '
          f'{precision:.1%} {recall:.1%} {fpr:.1%}')
预期输出:
阈值 TP FP FN TN 精确率 召回率 良品误检率
0.30 96 90 4 810 51.6% 96.0% 10.0%
0.50 92 36 8 864 71.9% 92.0% 4.0%
0.70 86 12 14 888 87.8% 86.0% 1.3%
0.85 70 4 30 896 94.6% 70.0% 0.4%
结果体现了阈值变化的直接影响:从 0.30 提高到 0.85,误检数由 90 降到 4,但漏检数也从 4 增加到 30。提高阈值并不意味着整体质量一定更好。
统计时需要同时检查两个恒等关系:,。如果某个阈值不满足,说明样本可能被遗漏、重复计数或正负类定义不一致。
阅读 PR 曲线并选择工作点
PR 曲线横轴为召回率 Recall,纵轴为精确率 Precision。每个置信度阈值对应一个工作点;遍历全部候选阈值,可以得到完整曲线。这里用四个离散工作点说明选择方法。
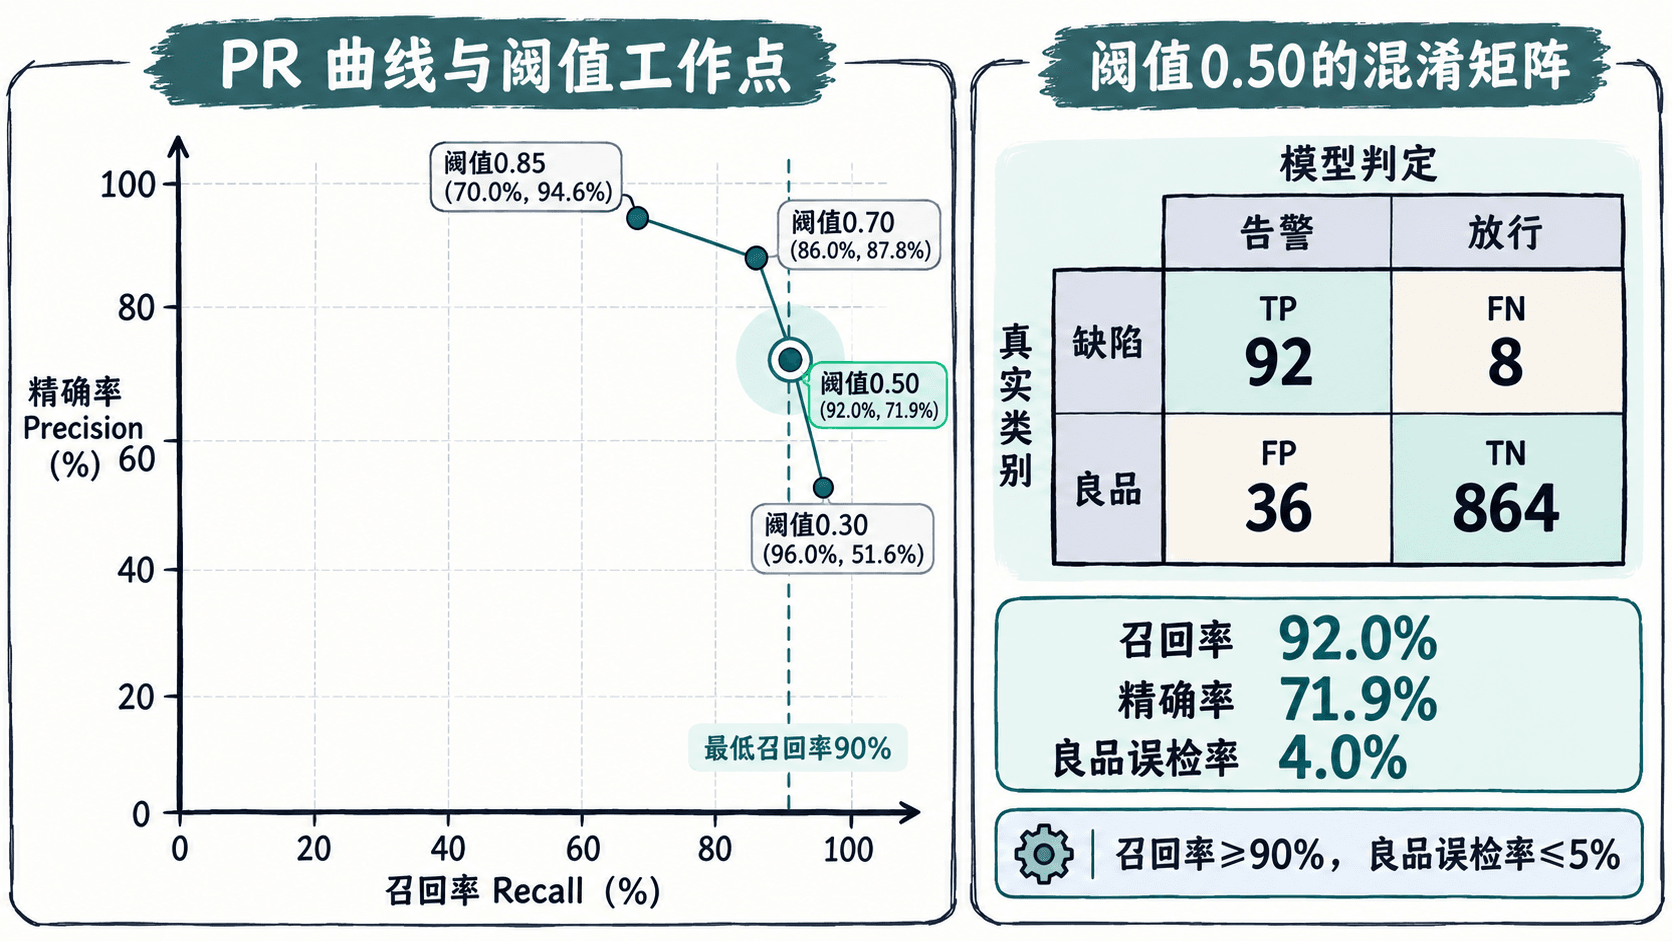
从图中可以看到,0.85 的精确率最高,但召回率只有 70%;0.30 的召回率达到 96%,却有较多错误告警。PR 曲线用于观察这种权衡,不能仅凭最靠近右上角的点确定最终阈值。
现在假设产线提出两条验收约束:
- 缺陷召回率至少 90%,避免大量不合格产品流出。
- 良品误检率不超过 5%,控制人工复核和误剔除负担。
逐项检查:
- 阈值 0.30:召回率 96%,但良品误检率 10%,不满足第二条。
- 阈值 0.50:召回率 92%,良品误检率 4%,两条均满足。
- 阈值 0.70:良品误检率仅 1.3%,但召回率 86%,不满足第一条。
- 阈值 0.85:召回率只有 70%,同样不合格。
因此,在这组验证数据和业务约束下,选择 0.50 作为候选告警阈值。这里的 0.50 来自实测工作点,不是因为模型分数超过一半就天然可靠。
如果现场希望用经济损失辅助决策,也可以设定每漏检一件造成 2000 元预期损失,每误检一件造成 50 元处理成本。则总损失估算为:
阈值 0.30 的估算损失为 元;阈值 0.50 为 元。按这组假设的成本,0.30 更有利,但它不满足前述误检率上限。
这说明成本最小化和强制质量约束可能给出不同选择。生产中应优先满足不可违反的质量、安全及节拍要求,再在可行阈值中优化成本。对于极高风险缺陷,漏检还可能属于不能仅用平均金额衡量的事件。
验证阈值能否用于真实产线
验证集上的 0.50 只是候选值,上线前还需要使用未参与训练和调参的独立测试集确认结果,避免反复调阈值导致评估偏乐观。
建议按以下顺序验收:
- 固定模型版本、图像预处理参数和阈值 0.50,记录每件工件的真实标签、置信度及最终判定。
- 按缺陷类型、设备、班次和材料批次分别统计 TP、FP、FN、TN,排查某类缺陷被整体漏检的情况。
- 在真实产线节拍下运行,记录每千件误报量、复核耗时、误剔除数量及漏检复判结果。
- 抽查阈值附近的样本,例如分数 0.45~0.55 的工件,确认分数抖动是否导致反复改变判定。
- 将阈值、模型版本、测试集版本、指标及审批结果一同保存;修改任一关键条件后重新评估。
还要检查验证集的缺陷比例。本例缺陷占 10%,但真实生产线可能只有 1% 或更低。当缺陷基率下降时,即使召回率与良品误检率保持不变,精确率通常也会下降,人工看到的告警中假阳性比例可能显著提高。因此,不能直接拿人为富集缺陷的测试集精确率预测现场表现。
模型分数还可能受到照明、相机曝光、工件表面反光和生产批次变化影响。若上线后连续出现误检率升高或特定缺陷漏检,应先核查成像条件与数据分布,再重新评估阈值,避免未经验证就临时提高阈值。
最终应将告警阈值作为一项可追溯的质量参数管理,而不是只在模型训练结束时挑选一个看起来最优的数字。