
智能制造与工业软件 / 系统课时
用 OCR 读取批次号与字符
用 OCR 读取批次号与字符
产线上的批次号即使清晰可见,也可能因为字符倾斜、反光或背景干扰而识别错误。本课使用 OpenCV 和 Tesseract 构建单行批次号读取程序,完成字符区域定位、图像增强、倾斜校正、OCR 识别和格式校验,最终输出可用于产线分拣的 OK/NG 结果。
学习目标
- 根据固定相机画面定位字符 ROI,并完成灰度增强与倾斜校正。
- 使用 Tesseract 读取单行批次号,理解识别模式和字符白名单。
- 通过正则表达式、日期合法性和置信度规则输出 OK/NG。
定位字符区域并确定识别范围
假设相机输出 1280×720 图像,工件由定位治具固定,批次号印在板件右侧。现场标定得到字符区域左上角坐标为 (400,260),宽度 500 像素、高度 100 像素。OpenCV 可以使用 image[260:360,400:900] 提取这个区域。
这种方式属于固定 ROI 定位,适用于相机、工件和印字位置相对稳定的产线。ROI 应完整包含字符及少量背景,避免裁断最左侧、最右侧字符,也不要包含螺丝孔、板件边框等高对比度结构。
如果工件会在画面中平移,应先利用定位孔、模板匹配或特征点求得位置偏移,再同步移动字符 ROI。直接使用固定坐标读取明显偏移的工件,容易把背景纹理误识别为字符。
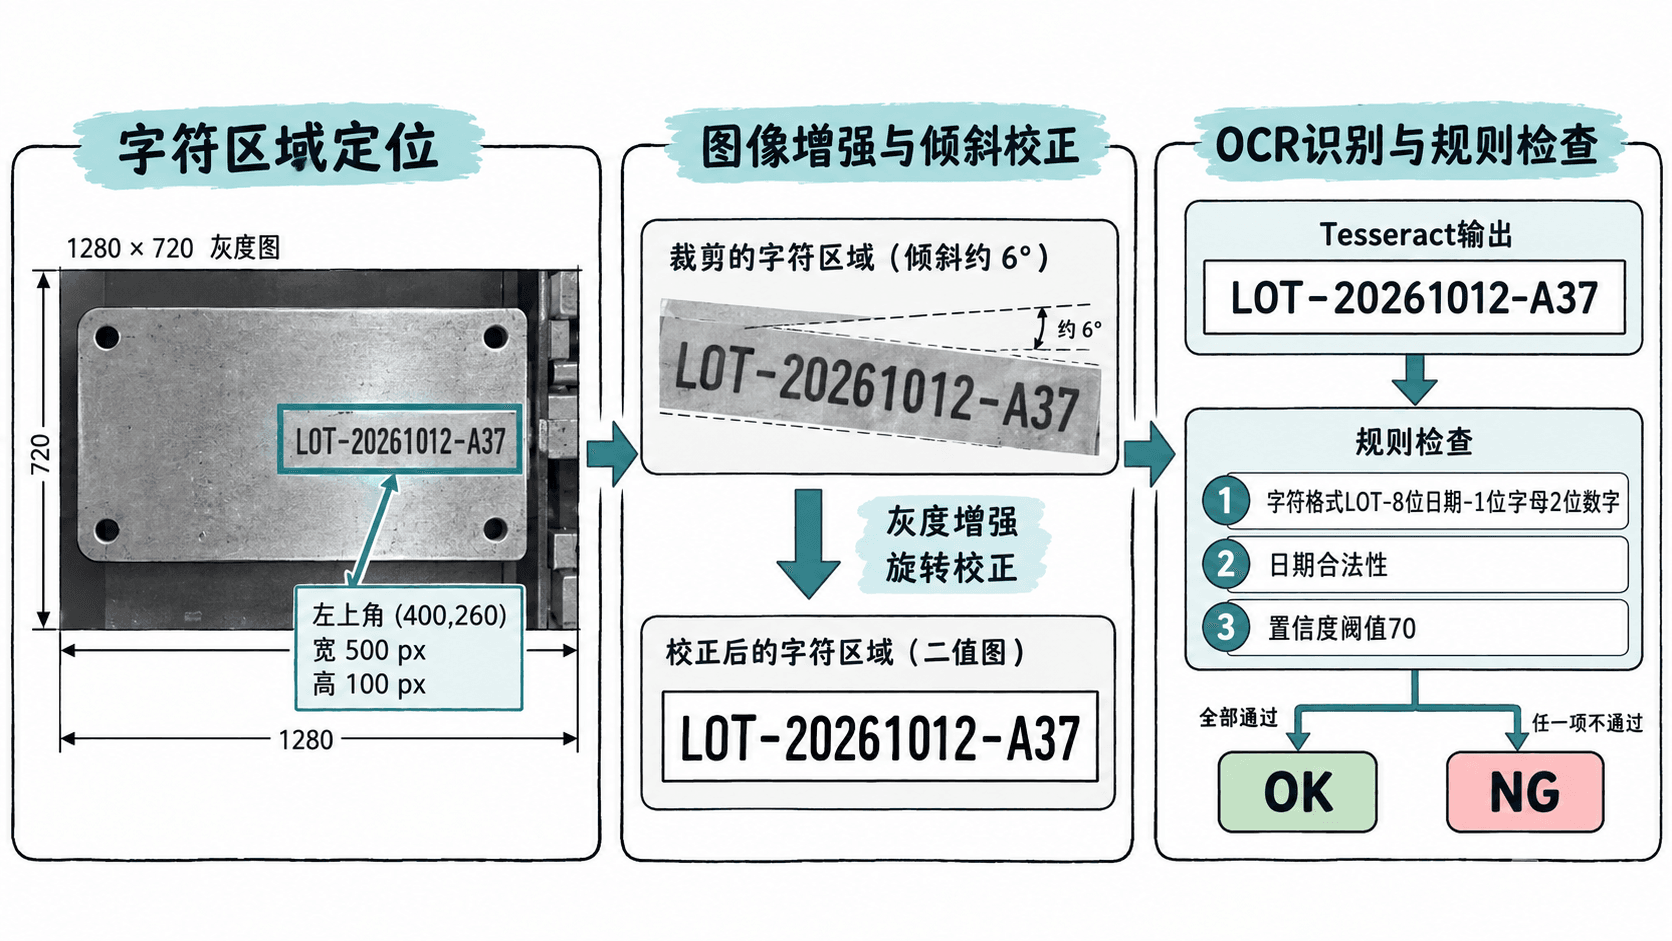
这里采用单行字符 ROI,而不是整幅图像 OCR。对于 1280×720 的相机帧,原图包含 921600 个像素,而指定 ROI 只有 50000 个像素,可以显著缩小后续处理范围,但 OCR 耗时仍取决于图像处理和识别器实现。
增强字符并校正倾斜
读取字符前,先将 ROI 转为灰度图。对于深色字符、浅色背景的印字,可以使用 CLAHE 局部对比度增强,再通过 Otsu 阈值法提取字符前景。CLAHE 的 clipLimit=2.0、tileGridSize=(8,8) 可以作为初始参数,最终需要用实际样本验证。
对于整行字符只有轻微旋转的情况,可以利用前景像素的最小外接旋转矩形估算方向,再进行旋转校正。例如字符行相对水平方向倾斜 6°,应将它校正到接近 0°,减少分割和识别错误。
这套方法有三个使用边界:
- ROI 内应以目标字符为主,避免污点或外框影响旋转矩形。
- 建议先处理约 ±10° 以内的小角度倾斜;大角度旋转应结合工件姿态定位。
- 字符很淡或背景严重反光时,优先改善光源、曝光和焦距,不能指望后处理恢复已经丢失的字符信息。
校正后使用二值图输入 OCR,同时保留原始 ROI,便于发生 NG 时对照检查。对于高度不足 20 像素的字符,可以尝试放大 2 倍,但放大不能补回原始图像缺失的细节。
调用 Tesseract 读取批次号
示例使用 Python 3.10 及以上版本、OpenCV 4.x、pytesseract 和 Tesseract OCR 5.x。Tesseract 是独立 OCR 引擎,pytesseract 只是 Python 调用封装,因此需要先安装 Tesseract,并确保命令位于系统 PATH 中。
在 Python 环境安装 opencv-python、numpy 和 pytesseract,同时通过操作系统安装 Tesseract 及英文 eng 语言数据。执行 tesseract --list-langs,确认输出列表包含 eng,再运行程序。
新建 ocr_lot.py,将现场图像保存为同目录下的 frame.png。下面是完整示例,ROI 坐标针对前述 1280×720 固定工位,实际部署时必须重新标定。
import re
import sys
from datetime import datetime

import cv2
import numpy as np
import pytesseract
from pytesseract import Output


if len(sys.argv) != 2:
    raise SystemExit('用法: python ocr_lot.py frame.png')

image = cv2.imread(sys.argv[1])
if image is None:
    raise SystemExit('无法读取图像')

# 使用现场标定的字符ROI,不在整幅图像上直接OCR
x, y, w, h = 400, 260, 500, 100
height, width = image.shape[:2]
if x + w > width or y + h > height:
    raise SystemExit('字符ROI超出图像范围')

roi = image[y:y + h, x:x + w]
gray = cv2.cvtColor(roi, cv2.COLOR_BGR2GRAY)
clahe = cv2.createCLAHE(clipLimit=2.0, tileGridSize=(8, 8))
enhanced = clahe.apply(gray)
blurred = cv2.GaussianBlur(enhanced, (3, 3), 0)

# 提取深色字符,利用整行前景估算小角度倾斜
_, foreground = cv2.threshold(
    blurred, 0, 255, cv2.THRESH_BINARY_INV + cv2.THRESH_OTSU
)
ys, xs = np.where(foreground > 0)
if len(xs) < 20:
    print('OCR=')
    print('判定=NG')
    sys.exit(0)

points = np.column_stack((xs, ys)).astype(np.float32)
box = cv2.boxPoints(cv2.minAreaRect(points))
edges = [box[(i + 1) % 4] - box[i] for i in range(4)]
major = max(edges, key=np.linalg.norm)
angle = float(np.degrees(np.arctan2(major[1], major[0])))
angle = (angle + 45) % 90 - 45

matrix = cv2.getRotationMatrix2D((w / 2, h / 2), angle, 1.0)
aligned = cv2.warpAffine(
    enhanced, matrix, (w, h),
    flags=cv2.INTER_LINEAR,
    borderMode=cv2.BORDER_CONSTANT,
    borderValue=255
)

# 转为黑字白底,增加白边并放大,适配单行OCR
_, binary = cv2.threshold(
    aligned, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU
)
binary = cv2.copyMakeBorder(
    binary, 10, 10, 10, 10, cv2.BORDER_CONSTANT, value=255
)
binary = cv2.resize(
    binary, None, fx=2, fy=2, interpolation=cv2.INTER_CUBIC
)

config = (
    '--oem 3 --psm 7 '
    '-c tessedit_char_whitelist=ABCDEFGHIJKLMNOPQRSTUVWXYZ0123456789-'
)
data = pytesseract.image_to_data(
    binary, lang='eng', config=config, output_type=Output.DICT
)

parts = [s.strip() for s in data['text'] if s.strip()]
code = ''.join(parts).upper()
confidences = [
    float(c) for s, c in zip(data['text'], data['conf'])
    if s.strip() and float(c) >= 0
]
confidence = sum(confidences) / len(confidences) if confidences else 0

# 格式为LOT-8位日期-1位字母2位数字
match = re.fullmatch(r'LOT-(\d{8})-[A-Z]\d{2}', code)
valid_date = False
if match:
    try:
        datetime.strptime(match.group(1), '%Y%m%d')
        valid_date = True
    except ValueError:
        pass

status = 'OK' if valid_date and confidence >= 70 else 'NG'
print(f'OCR={code}')
print(f'判定={status}')
在终端执行 python ocr_lot.py frame.png。如果图像中印有 LOT-20261012-A37,字符被正确识别且平均置信度达到 70,预期输出为:
OCR=LOT-20261012-A37
判定=OK
实际输出取决于输入图像。如果字符模糊、缺失或识别置信度不足,程序会输出 NG。输入文件不存在、ROI 超界等情况则会明确报错,不会被误判为合格工件。
配置里的 --psm 7 表示将输入当作单行文本处理,适合已经裁剪的批次号。--oem 3 使用 Tesseract 可用的默认 OCR 引擎模式;字符白名单限定候选字符,但不能保证识别结果一定正确。
使用格式与日期规则拦截错误
OCR 的返回内容不等于最终合格结果。这里规定合法批次号格式为 LOT-YYYYMMDD-A37,其中日期部分为 8 位数字,末尾为 1 位大写字母加 2 位数字。
| OCR 结果 | 检查结果 | 判定 |
|---|---|---|
LOT-20261012-A37 |
格式正确、日期有效、置信度达标 | OK |
LOT-20261012-437 |
末尾缺少字母 | NG |
LOT-20260230-A37 |
2 月 30 日不存在 | NG |
LOT-20261012-A37 |
平均置信度低于 70 | NG |
| 空字符串 | 未读取到字符 | NG |
正则表达式负责检查字符结构,datetime.strptime 负责检查日期是否合法。只使用正则表达式会漏掉 20260230 这样的无效日期。
这里的置信度使用 Tesseract 返回的非负字符词块置信度的算术平均值。70 是演示用的初始阈值,不代表识别正确概率为 70%。它也不能保证每个字符都可靠:如果产线不允许任何批次号错误,还需要结合字符级检查、重复拍摄或与生产订单数据库核对。
在产线上验证误识别与漏识别
正式接入 PLC 或分拣设备前,应先对同一工位采集有人工确认标签的图像样本。至少覆盖正常字符、轻微倾斜、低对比度、反光、污点、缺字和错误批次号。
例如选取 200 张样本,其中 160 张为符合规则的可读批次号,40 张为真实 NG。若系统将 3 张真实 NG 错判为 OK、将 8 张真实 OK 错判为 NG,则需要重点分析前一种漏检,因为它会让错误批次号流入后续工序。
在验收记录中分别统计:
- 真实 NG 被判为 OK 的数量和比例。
- 真实 OK 被判为 NG 的数量和比例。
- 单张图像处理耗时的平均值、P95 和最大值。
- ROI 定位失败、字符读取失败、格式校验失败各自的数量。
如果 NG 主要来自轻微倾斜,可检查旋转角度和字符是否被裁切;如果来自 O/0、I/1 等相似字符,应增加字符高度、改善照明,并结合批次号字段规则复核,不能直接将所有 O 自动替换成 0。
产线集成时还需要把 OCR 判定与设备通信状态分开:识别成功且规则通过才输出业务 OK;识别失败输出 NG 或人工复核;相机断线、OCR 引擎异常或处理超时应进入设备故障处理,不能默认放行。最终把原始图像、识别字符串、校验结果和工件追踪 ID 关联保存,才能追查一次错误判定的真实原因。