
智能制造与工业软件 / 系统课时
标注缺陷并按批次划分数据集
标注缺陷并按批次划分数据集
同一工件的连续拍摄图像往往高度相似。如果把这些图像随机分进训练集和测试集,模型可能只是记住了工件纹理,评估结果就会虚高。本篇给出缺陷标注规范、样本清单和批次隔离方法,并通过代码验证数据集没有批次泄漏。
学习目标
- 制定可复核的缺陷类别、标注边界和疑难样本处理规则。
- 组织正常与异常样本,记录批次、工件及采集信息。
- 按批次划分训练、验证和测试集,检查数据泄漏与类别覆盖。
定义缺陷类别与标注边界
以金属板件表面检测为例,先确定需要识别的缺陷,再统一标注尺度。类别必须对应可观察、可复核的外观特征,不应仅凭缺陷可能产生的原因命名。
| 类别编码 | 判定依据 | 标注方式 |
|---|---|---|
| OK | 检测区域内无目标缺陷 | 图像级正常标签 |
| SCRATCH | 连续线状划伤,与正常加工纹理可区分 | 沿可见划伤绘制紧致框 |
| DENT | 局部凹陷形成稳定的明暗或形状异常 | 框住可辨认的凹陷区域 |
| STAIN | 油污、污染物形成非正常色块 | 框住实际污染区域 |
| UNCERTAIN | 无法确定类别或边界 | 单独标记,暂不纳入评估 |
对于目标检测任务,标注框采用左上角坐标与宽高 (x, y, width, height),单位为原始图像像素。例如一条划伤在 1280×1024 图像中占据从 (320, 410) 到 (428, 426) 的区域,则框为 (320, 410, 108, 16)。
标注时遵守以下约定:
- 只框住可见缺陷,不把大面积正常背景包含进去。
- 同一图像存在两处划伤时创建两个缺陷实例,不合并为一个大框。
- 同一位置同时存在划伤和污点时,分别记录对应实例;确实无法区分时交由复核人员裁定。
- 对反光、阴影和正常加工纹理设置明确排除规则,不能把所有暗线都标成划伤。
- 图像中存在未确认的可疑区域时,不得直接将整张图像标记为 OK。
如果任务需要准确计算缺陷面积,可以将矩形框改为像素级掩膜。两种标注不能混用同一套面积指标:矩形框面积并不等于实际缺陷面积。
组织样本清单并执行复核
每张原始图像必须能够追溯到实际生产批次和工件。建议建立一份清单,至少包含以下字段。
| 字段 | 示例 | 用途 |
|---|---|---|
| image_id | B007-P015-F02 | 唯一图像编号 |
| batch_id | B007 | 生产批次标识 |
| part_id | P015 | 工件标识 |
| frame_id | F02 | 同一工件的拍摄帧 |
| camera_id | CAM01 | 相机或工位标识 |
| label | SCRATCH | 图像主类别或类别汇总 |
| annotation_path | annotations/B007-P015-F02.json | 缺陷实例标注文件 |
| review_status | APPROVED | 复核状态 |
实际项目还应记录采集时间、产品型号、光源配置版本和标注规范版本。对于一张图像包含多个缺陷类别的情况,类别汇总不能替代逐实例标注文件。
样本采集需要同时覆盖合格品和真实不合格品。例如初期收集 3000 张图像,可以先设定正常图像 1800 张、划伤 600 张、凹陷 400 张和污点 200 张作为采集目标,但最终数量应根据真实缺陷发生率、缺陷形态覆盖度与独立批次数调整。
复核采用两级流程:标注员完成初标,复核员检查类别和边界;存在争议的样本由工艺或质量人员裁定。可以先对每类随机抽取至少 10% 进行独立复标,并对全部疑难样本进行复核,统计两名标注员的类别一致率和边界差异。
同一工件的多张相似照片不能当作多个独立缺陷案例。正常样本也要覆盖不同生产日期、表面纹理和允许的光照波动,否则模型容易把正常变化误识别为缺陷。
按生产批次隔离训练与评估数据
错误的做法是直接对所有图像随机执行 80% 训练、10% 验证、10% 测试。假设批次 B007 中同一工件连续拍摄 20 帧,这些相似帧可能同时出现在三个集合中,导致测试结果无法反映模型对新批次工件的泛化能力。
正确的方法是先以 batch_id 分组,再将完整批次分配给训练集、验证集或测试集。同一批次的全部工件、相机视角和连续帧必须留在同一个集合中。
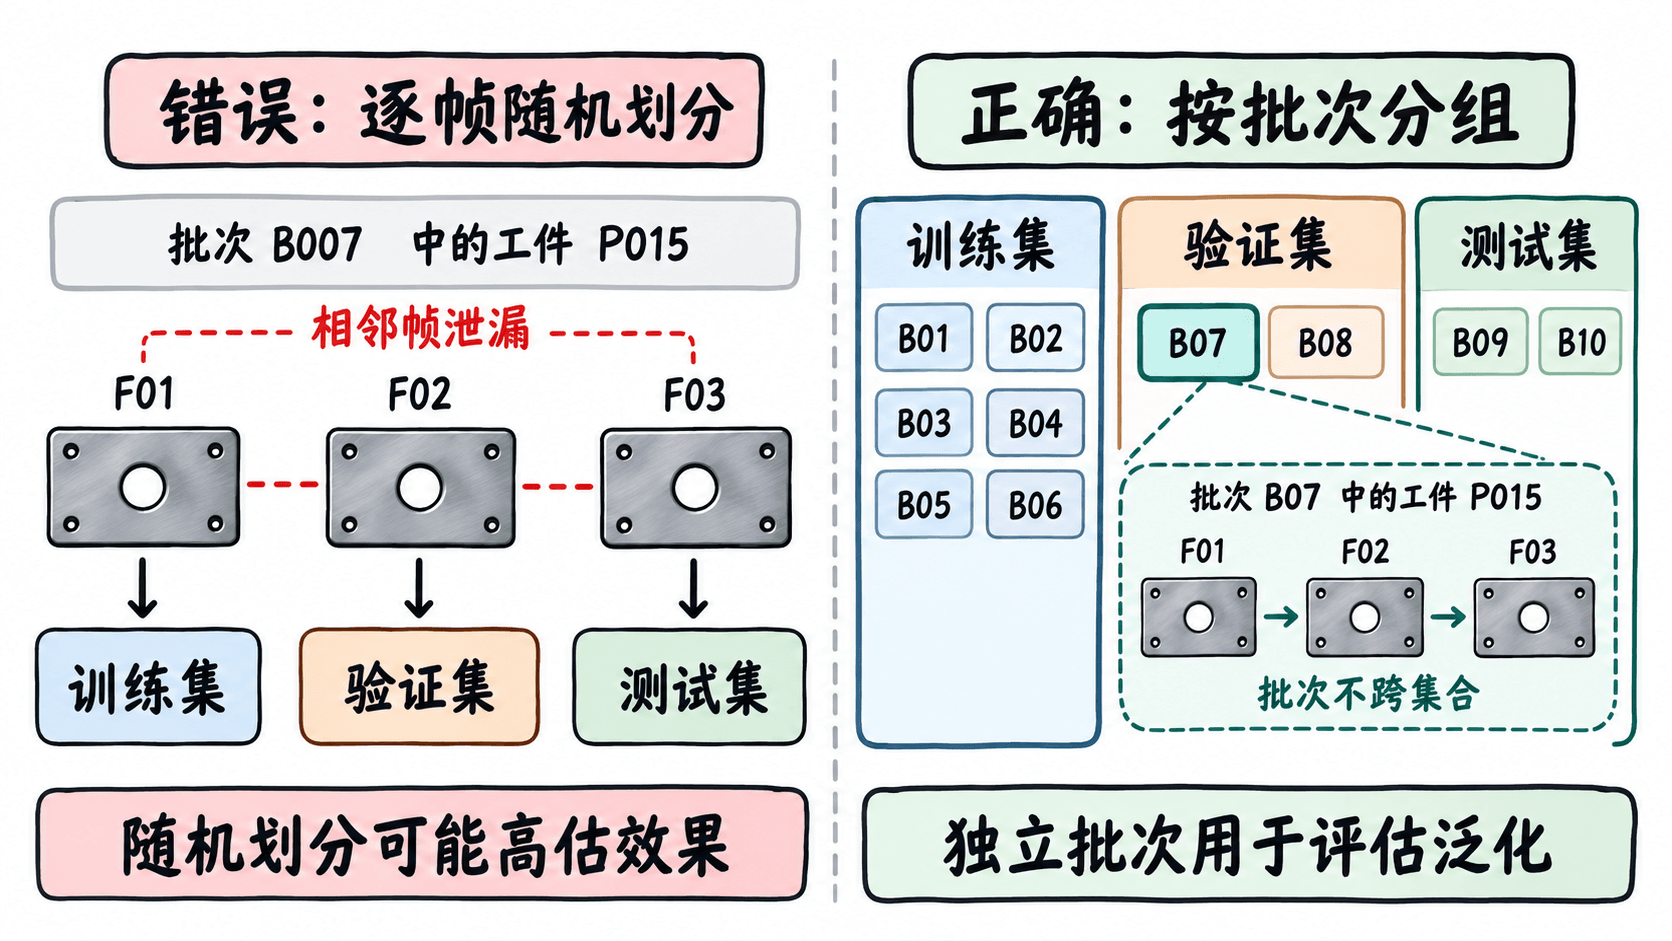
下面使用 Python 标准库构造一个可独立运行的示例。共有 10 个生产批次,每批 4 张图像,其中包含同一工件的两张连续帧。示例使用简化的类别分布,演示按批次进行 60% / 20% / 20% 划分。
import random
from collections import Counter

# 构造演示清单:同一工件的连续帧共享批次和工件编号
manifest = []
for i in range(1, 11):
    batch = f'B{i:02d}'
    samples = [
        ('P1', 'F0', 'OK'),
        ('P1', 'F1', 'OK'),
        ('P2', 'F0', 'SCRATCH'),
        ('P3', 'F0', 'DENT'),
    ]
    for part, frame, label in samples:
        manifest.append({
            'batch_id': batch,
            'part_id': part,
            'frame_id': frame,
            'label': label,
        })

# 先打乱批次,再划分,不能直接打乱图片
batches = sorted({r['batch_id'] for r in manifest})
random.Random(42).shuffle(batches)
assigned = {
    'train': set(batches[:6]),
    'val': set(batches[6:8]),
    'test': set(batches[8:]),
}

for name, batch_ids in assigned.items():
    rows = [r for r in manifest if r['batch_id'] in batch_ids]
    counts = Counter(r['label'] for r in rows)
    print('{}: 批次={}, 图片={}, 类别={}'.format(
        name, len(batch_ids), len(rows), dict(sorted(counts.items()))
    ))

# 集合间批次不得有交集
names = list(assigned)
leaks = sum(len(assigned[a] & assigned[b])
            for i, a in enumerate(names) for b in names[i + 1:])
assert leaks == 0
print('批次泄漏:', leaks)
预期输出:
train: 批次=6, 图片=24, 类别={'DENT': 6, 'OK': 12, 'SCRATCH': 6}
val: 批次=2, 图片=8, 类别={'DENT': 2, 'OK': 4, 'SCRATCH': 2}
test: 批次=2, 图片=8, 类别={'DENT': 2, 'OK': 4, 'SCRATCH': 2}
批次泄漏: 0
真实项目中可以将 manifest 替换为从 CSV、数据库或标注平台导出的记录。划分结果必须保存批次与集合的对应表,并记录随机种子,避免后续训练因重新划分而改变测试范围。
检查泄漏、类别覆盖与测试集独立性
批次没有交集只是第一项检查。正式训练前还应执行以下验收:
- 批次隔离:训练、验证、测试三个集合的
batch_id两两不相交;相同part_id如果在不同批次重复使用编号,应结合批次形成唯一工件键,并核查实际工件是否被跨批次重复采集。 - 重复图像:计算图像文件的 SHA-256 哈希,识别跨集合完全重复文件;对于重新编码、裁剪或轻微位移产生的近重复图像,再使用感知哈希或视觉相似度人工核查。
- 类别覆盖:分别统计每类缺陷的图片数、实例数和独立批次数。如果测试集没有 STAIN,就不能声称已经验证了污点检测能力。
- 标注质量:仅将审核通过的确定标签纳入正式评估;对 UNCERTAIN 和存在边界争议的样本单独处理,不得默认归入 OK。
- 分布代表性:检查相机、光源配置、产品型号、生产日期及不同班次的覆盖情况,避免测试集只包含最容易检测的工况。
例如某类划伤共有 200 张图片,但全部来自同一批次、同一工件的连续拍摄,这不能等同于 200 个独立缺陷案例。应增加不同批次、不同工件以及不同缺陷形态的样本,而不是继续对相邻帧做数据增强。
测试集应在模型选择和阈值调整之前冻结。训练集负责拟合参数,验证集用于选择模型与决策阈值,测试集只用于最终独立评估。如果根据测试集漏检结果反复修改模型,就应另外保留新的独立批次作为最终测试集。
产线部署前,还可以选取时间上晚于训练数据的完整生产批次做一次额外验证,检查材料供应、设备状态或光照变化引起的性能下降。最终交付的数据版本应同时保存图像、标注、批次划分表、标注规范版本和完整的样本统计结果,使每一项检测指标都能追溯到具体的独立工件和生产批次。